




1、Elasticsearch 的基本概念
Node(节点)是 ES 架构中最基础的单元,它代表着单个 Elasticsearch 实例。每个节点都可以承担不同的角色,如主节点、数据节点、客户端节点等。主节点负责集群状态的管理,包括索引的创建、删除,节点的加入和离开等;数据节点专注于存储和处理数据;客户端节点则主要用于接收客户端请求,并将请求转发到合适的数据节点。一个节点可以同时承担多个角色,也可以根据业务需求进行角色划分,通过合理配置节点角色,能够充分发挥硬件资源的优势,提升整个集群的性能
2、Elasticsearch 架构图解
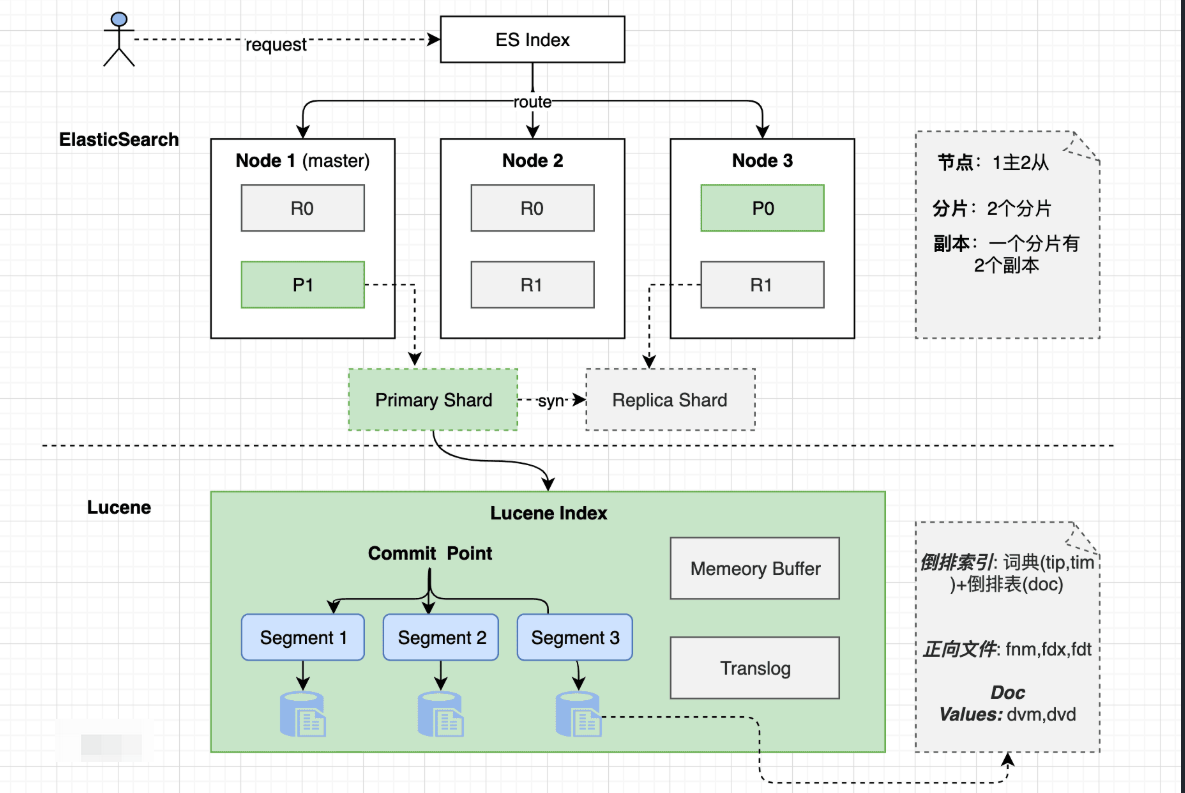
3、Elasticsearch 的核心架构原理
1. 分布式分片机制
Elasticsearch 将每个索引分成多个 Shard(分片),每个分片是一个独立的 Lucene 索引。分片可以分布在不同的节点上,从而实现:
负载均衡
数据冗余
横向扩展
📌 主分片数量一旦创建不可更改,副本分片可动态调整。
2. 副本机制(Replication)
每个主分片(Primary Shard)可以配置多个副本(Replica Shard),以提升系统的:
容错能力(故障恢复)
查询吞吐量(负载均衡)
3. 节点角色划分
Master Node(主节点):负责管理集群元数据、节点加入/退出等操作。
Data Node(数据节点):存储数据并执行 CRUD、搜索、聚合等操作。
Ingest Node(摄入节点):负责对数据进行预处理(如转换、过滤)。
Coordinating Node(协调节点):接收用户请求,将请求路由到合适节点并汇总结果返回。
一个节点可以同时承担多种角色。
4、Elasticsearch 的工作流程
读取流程(Search)
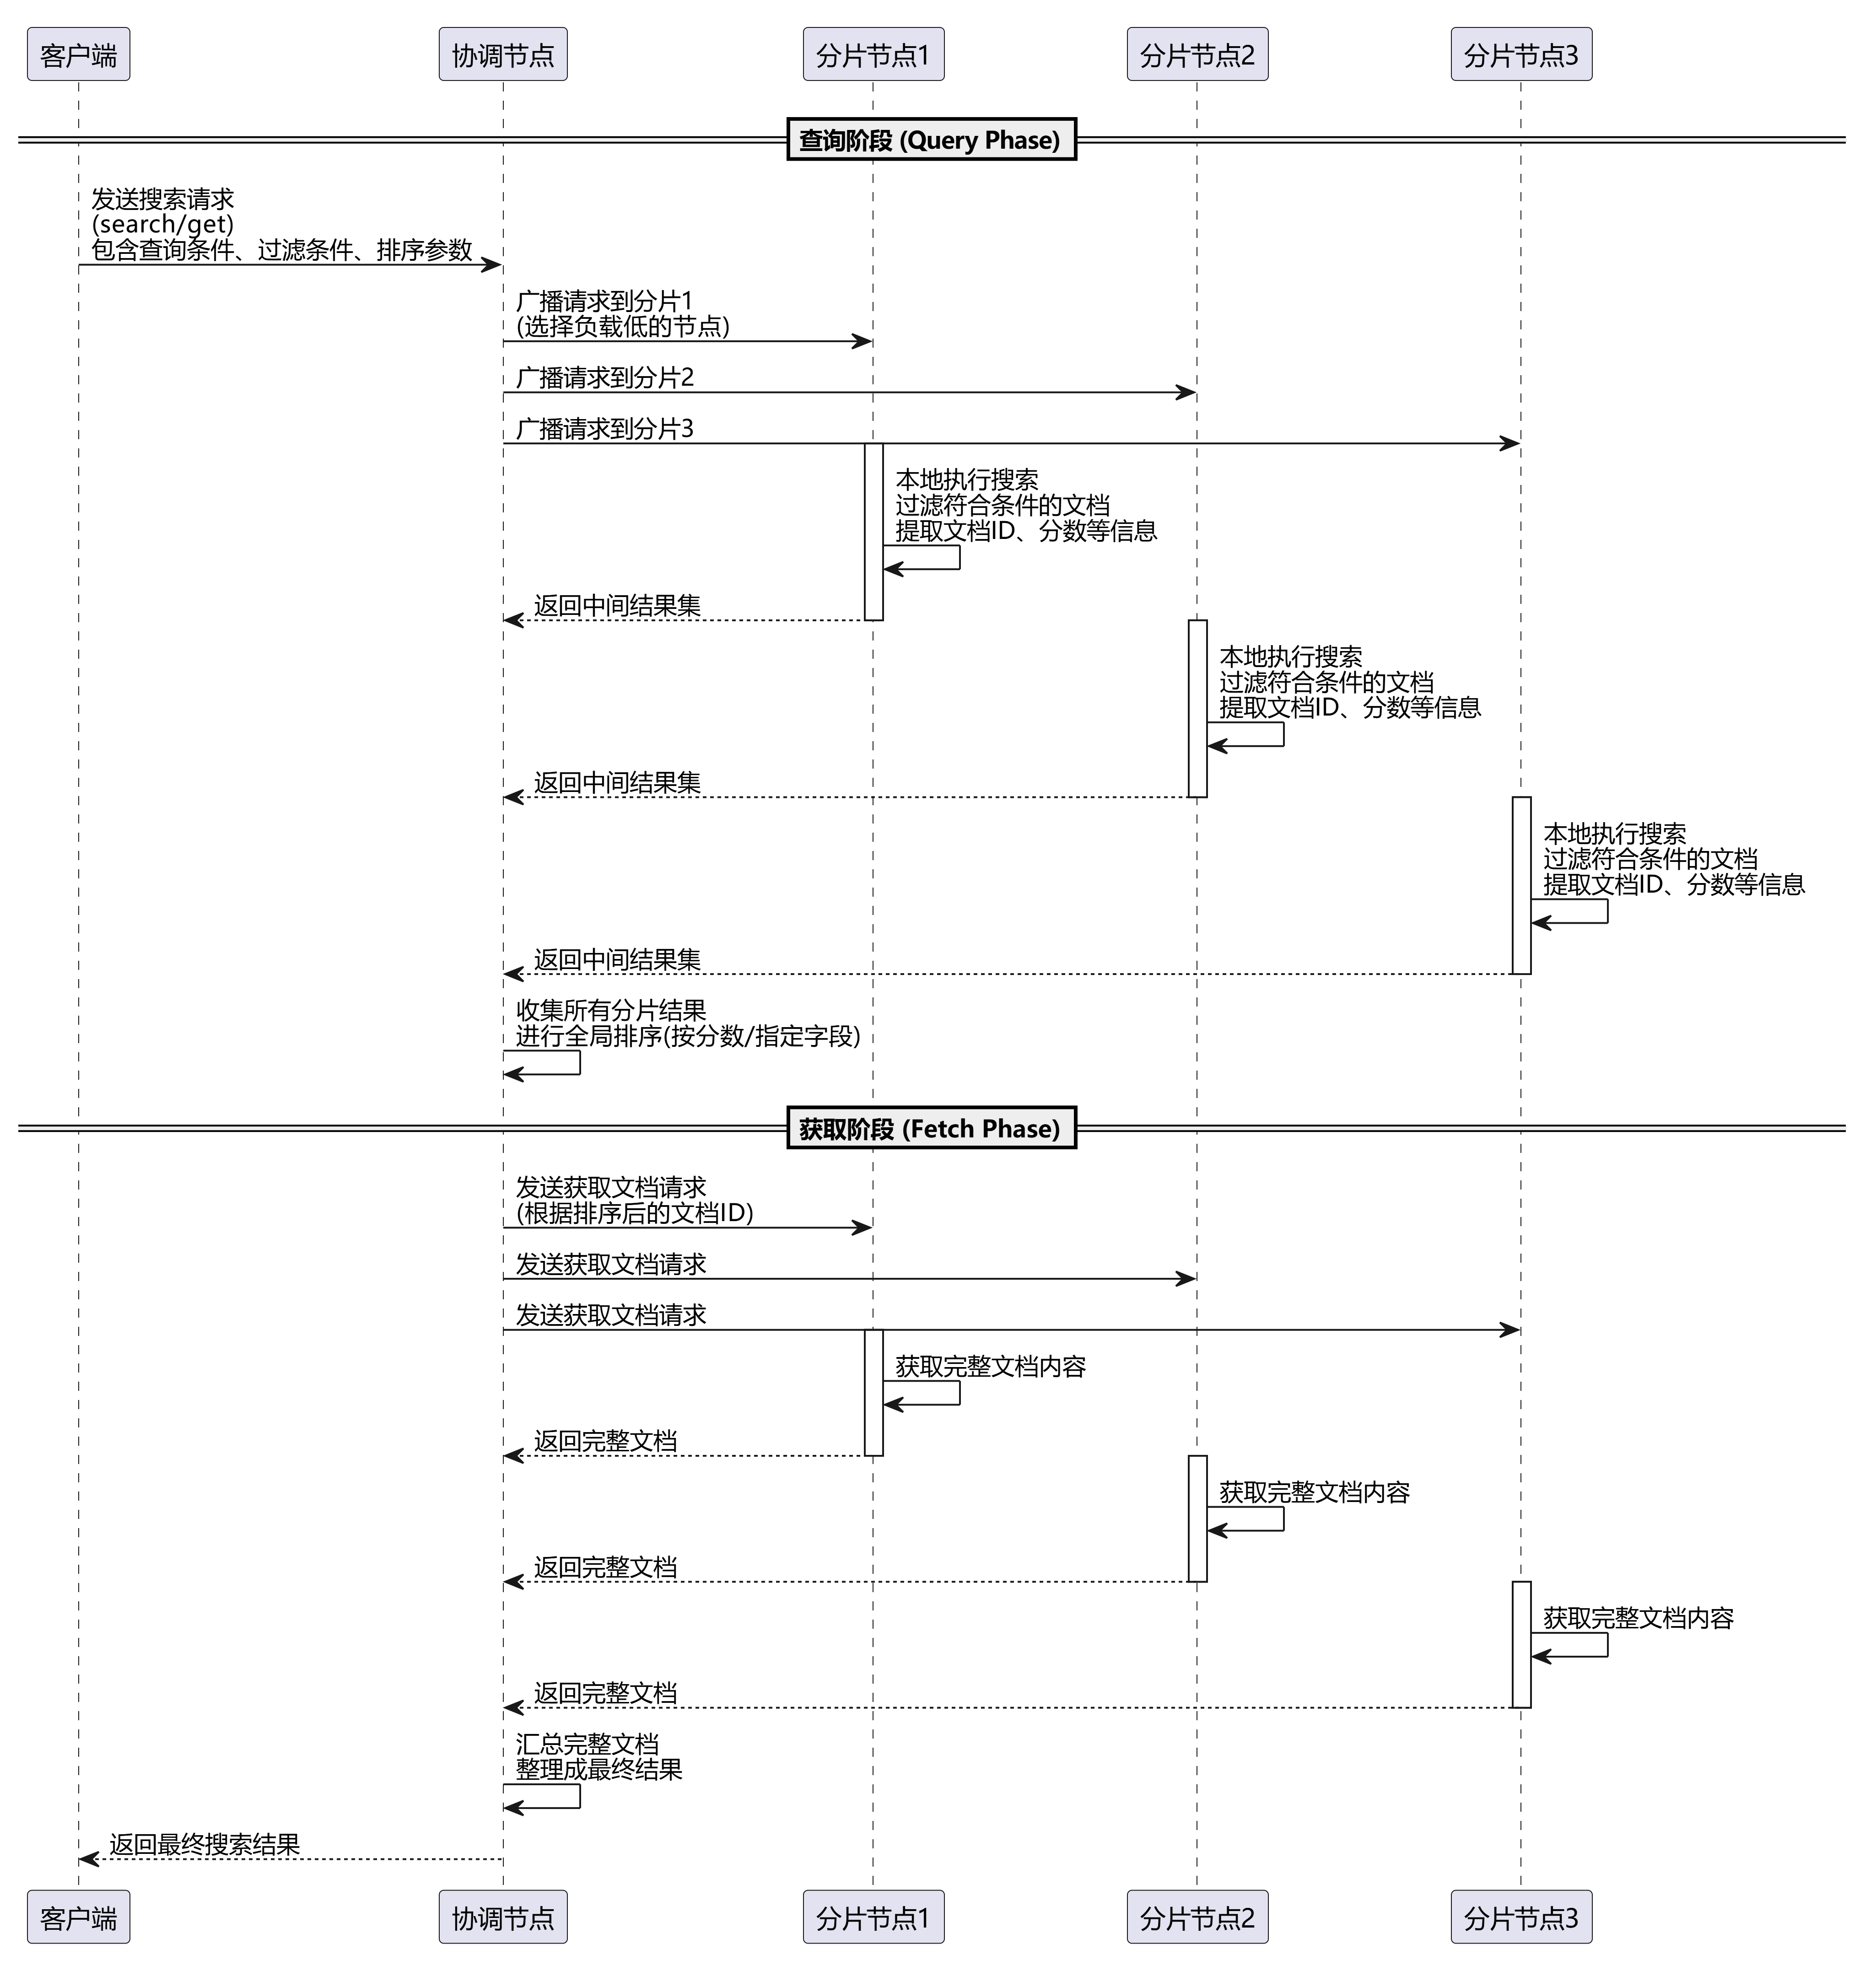
读取流程(Search)详解
1. 客户端发起搜索请求
客户端发送搜索请求(如
search、get)到协调节点,请求中可指定查询条件、过滤条件、排序等参数。2. 协调节点广播请求到相关分片
协调节点根据索引的分片配置,确定需要查询的分片(主分片或副本分片,优先选择负载较低的节点)。
对于 查询阶段(Query Phase) ,协调节点将请求广播到所有相关分片(每个分片处理自己的部分数据)。
3. 分片执行本地搜索并返回中间结果
每个分片在本地执行搜索,过滤出符合条件的文档,并提取文档 ID、分数(Score)等信息,形成中间结果集(不返回完整文档内容)。
分片将中间结果返回给协调节点,协调节点收集所有分片的结果后进行全局排序(按分数、指定字段等)。
4. 协调节点汇总结果并获取完整文档(Fetch Phase)
若搜索结果需要返回完整文档(如
get请求或search中指定返回字段),协调节点会根据排序后的文档 ID,向对应的分片发送获取文档请求(仅获取目标文档)。分片返回完整文档内容,协调节点汇总后整理成最终结果,返回给客户端。。
写入流程(Search)详解
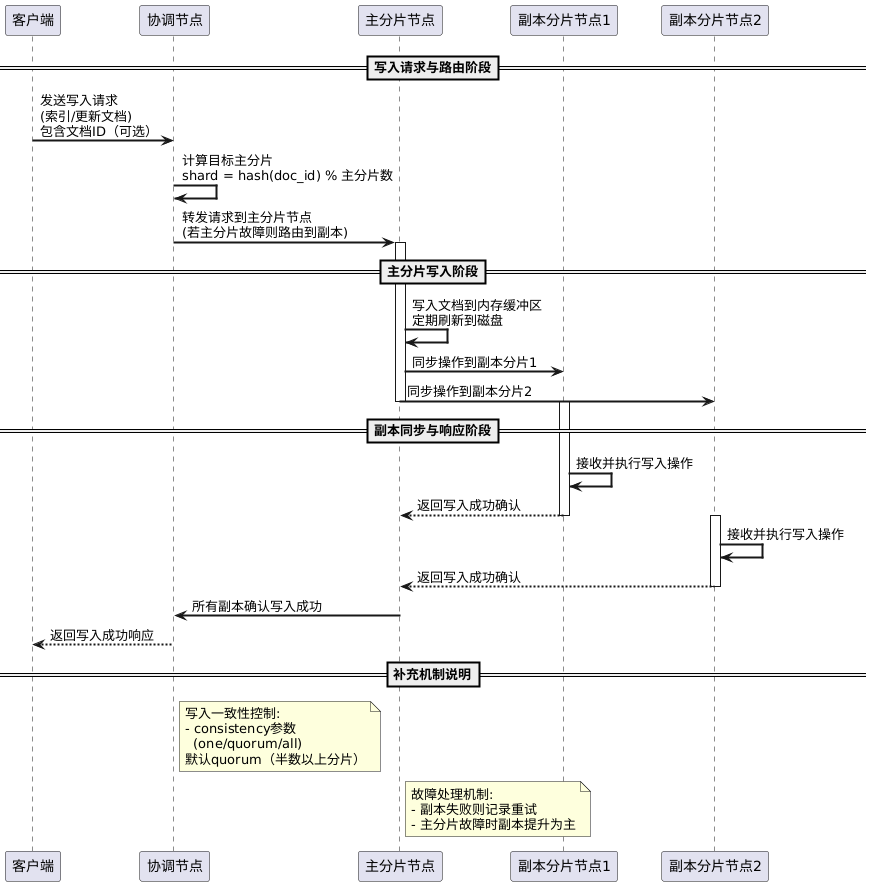
写入流程(Indexing)详解
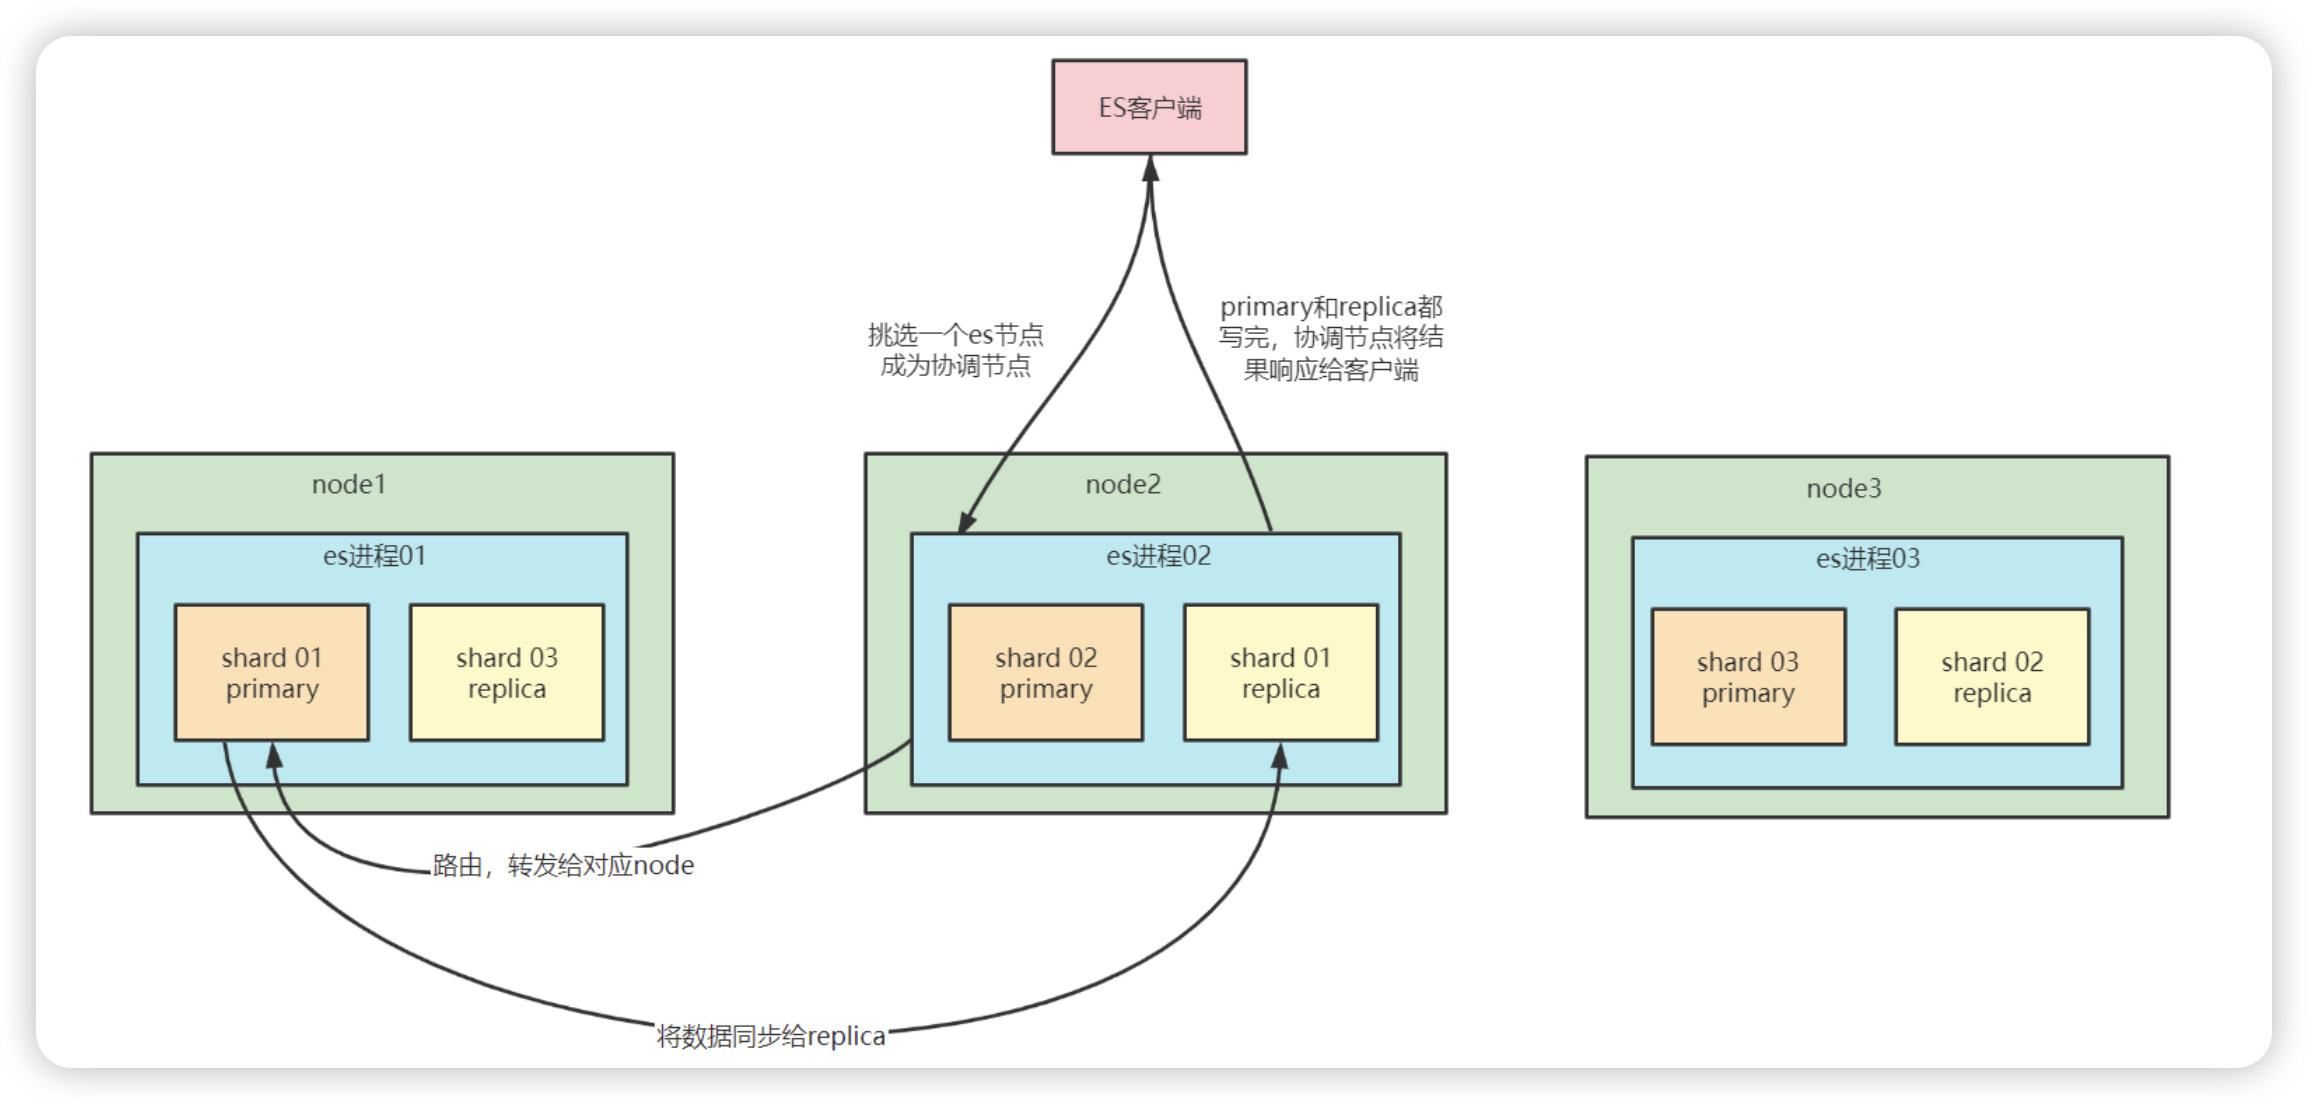
1. 客户端请求与协调节点路由
客户端发送写入请求(如索引文档、更新文档)到任意节点,该节点自动成为协调节点(Coordinating Node)。
协调节点根据文档的 ID(若未指定则自动生成),通过公式
shard = hash(doc_id) % number_of_primary_shards计算目标主分片的位置。2. 转发至主分片所在节点
协调节点将请求转发到目标主分片所在的节点(若主分片所在节点故障,会自动路由到副本分片,后续由副本分片提升为主分片处理)。
3. 主分片写入与副本同步
主分片节点接收请求后,将文档写入本地分片(先写入内存缓冲区,再定期刷新到磁盘)。
主分片完成写入后,会将操作同步到该分片的所有副本分片(Replica Shard)。同步方式为同步复制(默认),即主分片会等待所有副本分片确认写入成功。
4. 响应客户端
当所有副本分片确认写入成功后,主分片节点将成功信号返回给协调节点,最终由协调节点响应客户端,完成写入流程。
写入一致性:可通过
consistency参数调整(如one、quorum、all),默认quorum(要求超过半数的分片成功)。故障处理:若副本分片写入失败,主分片会记录失败节点,后续重试;若主分片故障,集群会自动选举副本分片成为新主分片。
Elasticsearch 中 Node 的通信机制解析
在 Elasticsearch 的架构体系中,多个 Node(节点)共同组成一个 Cluster(集群),协同工作。而节点之间的高效、稳定通信,是实现集群高可用性、数据一致性以及水平扩展的基础。
接下来,我们将深入解析 Elasticsearch 不同节点之间是如何进行通信的。
一、通信协议与端口
Elasticsearch 基于 TCP 协议 实现节点间的通信,默认使用端口 9300。TCP 是一种面向连接、可靠的传输协议,能够确保节点间交换的关键信息(如集群状态更新、分片分配指令、文档操作请求等)不会丢失或错乱。
⚠️ 注意:
在实际部署中,若默认端口被占用,可通过配置文件修改节点间通信端口,以确保节点正常建立连接。
二、节点发现机制
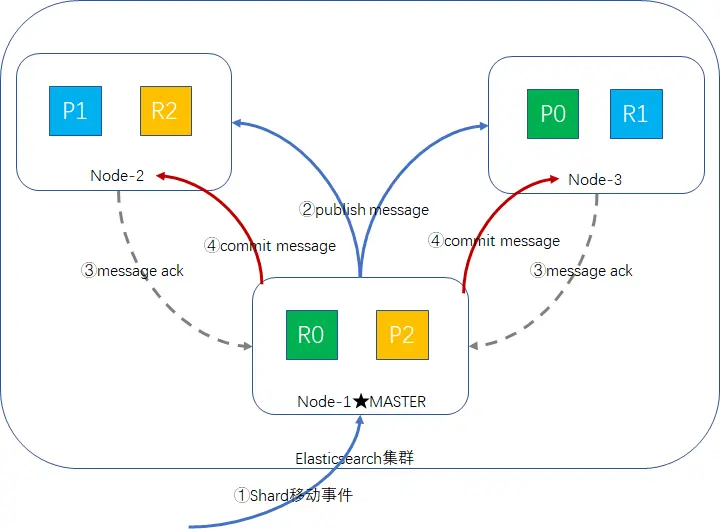
当新节点加入集群或已有节点感知到集群变化时,需要通过 节点发现机制 来建立通信连接。
Elasticsearch 支持多种发现方式,包括:
组播(Multicast)
单播(Unicast)
推荐使用:单播(Unicast)
在生产环境中,推荐使用单播方式,其优势在于网络开销小、安全性高、可控性强。
单播发现流程如下:
管理员在每个节点的配置文件中指定部分已知节点的 IP 地址。
当新节点启动时,会向这些已知节点发送请求,获取当前集群的状态和其他节点列表。
已知节点收到请求后,返回集群信息,帮助新节点完成初始化。
新节点将自身信息同步给其他节点,从而完成整个集群的通信连接。
这种方式避免了广播带来的网络负担和安全隐患,提升了节点发现过程的稳定性与效率。
在 Elasticsearch 集群部署中,核心配置文件是 elasticsearch.yml,其配置内容需根据集群规模、节点角色及网络环境等因素进行调整。以下是单播发现机制下典型的集群配置示例及详细说明:
集群配置
# 集群基本配置
cluster.name: my-elasticsearch-cluster  # 集群名称,同一集群内所有节点需一致
node.name: node-1                         # 节点名称,集群内唯一标识

# 节点角色配置(根据需求选择)
node.master: true                         # 是否有资格成为主节点
node.data: true                           # 是否存储数据
node.ingest: true                         # 是否处理 ingest pipeline
# node.ml: true                           # 是否启用机器学习功能(可选)

# 网络配置
network.host: 192.168.1.101               # 节点绑定的IP地址(本机IP)
http.port: 9200                           # HTTP服务端口
transport.port: 9300                      # 节点间通信端口(TCP)

# 单播发现机制配置(生产环境推荐)
discovery.seed_hosts: ["192.168.1.101", "192.168.1.102", "192.168.1.103"]
# 上述IP为集群中部分已知节点的IP地址,新节点通过这些IP发现集群

# 主节点选举配置
cluster.initial_master_nodes: ["node-1", "node-2", "node-3"]
# 初始化时参与主节点选举的节点列表,需与node.name对应

# 其他常用配置(可选)
path.data: /data/elasticsearch/data       # 数据存储路径
path.logs: /data/elasticsearch/logs       # 日志存储路径
bootstrap.memory_lock: true               # 锁定物理内存,避免交换分区影响性能
http.cors.enabled: true                   # 启用CORS跨域访问
http.cors.allow-origin: "*"                # 允许所有来源访问(生产环境可限制具体域名)
不同节点的配置差异
1. 主节点(Master Node)
必须配置
node.master: true,建议不存储数据(node.data: false)以减轻负载。discovery.seed_hosts和cluster.initial_master_nodes需包含自身信息。
2. 数据节点(Data Node)
配置
node.data: true,建议分配更多磁盘空间和内存。可根据需求设置
node.master: false(避免参与主节点选举)。
3. 客户端节点(Client Node)
不存储数据且不参与主节点选举(
node.data: false,node.master: false),仅用于接收客户端请求并转发至数据节点。
单播发现机制的部署注意事项
IP地址准确性:
discovery.seed_hosts中配置的IP必须可被新节点访问(确保防火墙开放9300端口)。初始主节点选举:
cluster.initial_master_nodes列表需包含至少3个候选主节点(形成多数派选举),避免脑裂问题。动态发现优化:
若集群节点较多,可配合cloud discovery(如AWS、阿里云)或容器服务(Kubernetes)实现动态发现,减少手动配置成本。
配置文件示例(三节点集群)
节点1(主节点+数据节点)
cluster.name: es-cluster
node.name: node-1
node.master: true
node.data: true
network.host: 192.168.1.101
discovery.seed_hosts: ["192.168.1.101", "192.168.1.102", "192.168.1.103"]
cluster.initial_master_nodes: ["node-1", "node-2", "node-3"]
节点2(主节点+数据节点)
cluster.name: es-cluster
node.name: node-2
node.master: true
node.data: true
network.host: 192.168.1.102
discovery.seed_hosts: ["192.168.1.101", "192.168.1.102", "192.168.1.103"]
cluster.initial_master_nodes: ["node-1", "node-2", "node-3"]
节点3(数据节点)
cluster.name: es-cluster
node.name: node-3
node.master: false  # 不参与主节点选举
node.data: true
network.host: 192.168.1.103
discovery.seed_hosts: ["192.168.1.101", "192.168.1.102", "192.168.1.103"]
新节点启动时会通过 discovery.seed_hosts 中的IP连接已知节点,获取集群状态并完成加入流程,确保集群通信的稳定性和安全性。实际部署时需根据硬件资源、网络环境及业务需求调整参数。
三、集群状态同步
集群状态(Cluster State) 包含索引元数据、分片分布、副本状态等关键信息。为了保障集群的一致性和协调性,所有节点都必须保持集群状态的同步。
主节点职责
负责维护和更新集群状态。
当发生以下事件时,主节点生成新的集群状态版本:
创建/删除索引
节点加入/离开
分片重新分配
同步流程
主节点通过 TCP 连接将新的集群状态广播给所有节点。
各节点接收后校验版本,并更新本地状态。
每个节点基于最新状态处理数据操作和请求转发。
这种机制确保了集群内所有节点对集群结构有统一认知,是实现高可用和一致性的重要基础。
评论区