




Elasticsearch DSL 查询之复合查询详解
在实际的搜索应用场景中,单一的查询条件往往无法满足我们的需求,我们经常需要将多个查询条件进行组合,以获取更精准的结果。在 ElasticSearch 中,这种多种条件组合的查询被称为复合查询。ElasticSearch 为我们提供了 5 种强大的复合查询方式,分别是 bool query (布尔查询)、boosting query (提高查询)、constant_score(固定分数查询)、dis_max (最佳匹配查询)以及 function_score (函数查询)。接下来,我们将从构造数据开始,深入探究这五种复合查询的具体用法。
一、构造模拟数据
为了更好地演示复合查询,我先构造一批模拟数据,大家可以直接使用我的示例数据
假设我们有一个电商商品索引,每个商品文档包含title(商品标题)、description(商品描述)、price(商品价格)、category(商品类别)等字段。
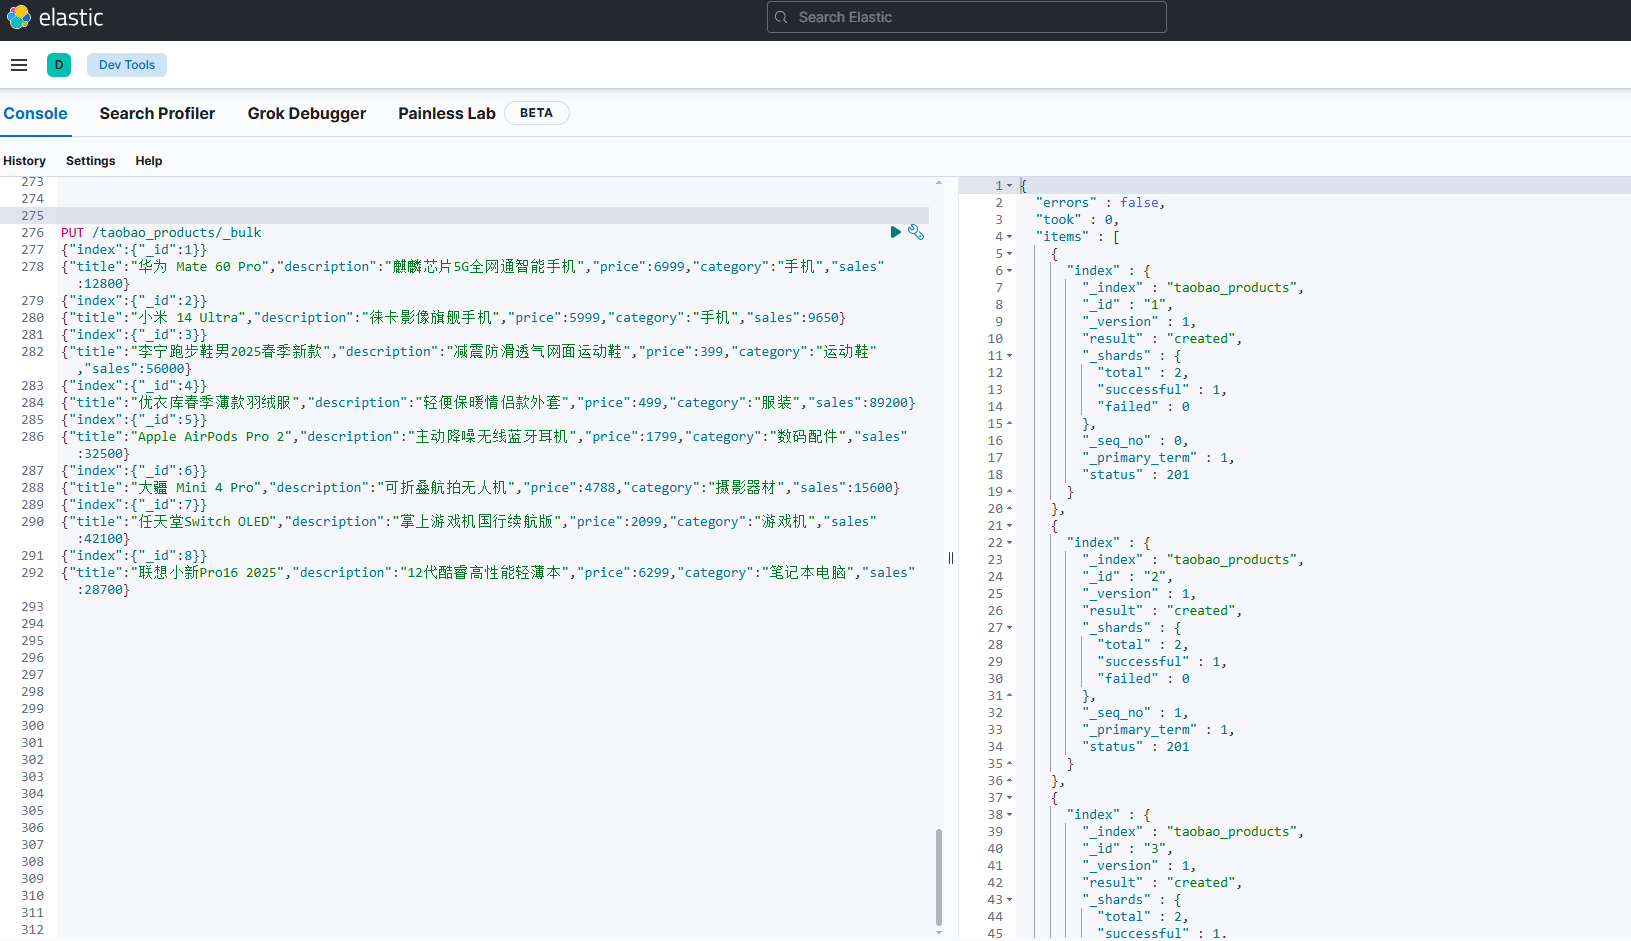
ElasticSearch 中批量插入数据:
PUT /taobao_products/_bulk
{"index":{"_id":1}}
{"title":"华为 Mate 60 Pro","description":"麒麟芯片5G全网通智能手机","price":6999,"category":"手机","sales":12800}
{"index":{"_id":2}}
{"title":"小米 14 Ultra","description":"徕卡影像旗舰手机","price":5999,"category":"手机","sales":9650}
{"index":{"_id":3}}
{"title":"李宁跑步鞋男2025春季新款","description":"减震防滑透气网面运动鞋","price":399,"category":"运动鞋","sales":56000}
{"index":{"_id":4}}
{"title":"优衣库春季薄款羽绒服","description":"轻便保暖情侣款外套","price":499,"category":"服装","sales":89200}
{"index":{"_id":5}}
{"title":"Apple AirPods Pro 2","description":"主动降噪无线蓝牙耳机","price":1799,"category":"数码配件","sales":32500}
{"index":{"_id":6}}
{"title":"大疆 Mini 4 Pro","description":"可折叠航拍无人机","price":4788,"category":"摄影器材","sales":15600}
{"index":{"_id":7}}
{"title":"任天堂Switch OLED","description":"掌上游戏机国行续航版","price":2099,"category":"游戏机","sales":42100}
{"index":{"_id":8}}
{"title":"联想小新Pro16 2025","description":"12代酷睿高性能轻薄本","price":6299,"category":"笔记本电脑","sales":28700}
批量插入接口_bulk,一次性向名为products的索引中插入了 5 条商品数据。
二、bool query (布尔查询)
概念
布尔查询是 ElasticSearch 中最常用的复合查询方式,它基于布尔逻辑来组合多个查询子句。布尔查询包含四个重要的子句:must、must_not、should和filter。
must:必须满足的条件,相当于逻辑与(AND),满足must条件的文档会被包含在结果集中,并且会影响文档的相关性得分。must_not:必须不满足的条件,相当于逻辑非(NOT),满足must_not条件的文档会被排除在结果集之外,不影响文档的相关性得分。should:应该满足的条件,相当于逻辑或(OR),满足should条件的文档会增加相关性得分。如果must和filter子句没有匹配的文档,那么should子句中至少有一个条件匹配的文档才会被返回。filter:过滤条件,与must类似,满足filter条件的文档会被包含在结果集中,但不计算相关性得分,因此在性能上会比must更好,常用于对查询结果进行条件过滤。
例子
查询价格在 3000 元以上的数码类商品(手机、数码配件、摄影器材),同时排除华为品牌的商品:
must子句确保返回的文档价格大于等于 3000 且类别属于数码类商品,must_not子句则将华为品牌的商品排除在外。
GET /taobao_products/_search
{
  "query": {
    "bool": {
      "must": [
        {
          "range": {
            "price": {
              "gte": 3000
            }
          }
        },
        {
          "terms": {
            "category": ["手机", "数码配件", "摄影器材"]
          }
        }
      ],
      "must_not": [
        {
          "match_phrase": {
            "title": "华为"
          }
        }
      ]
    }
  }
}
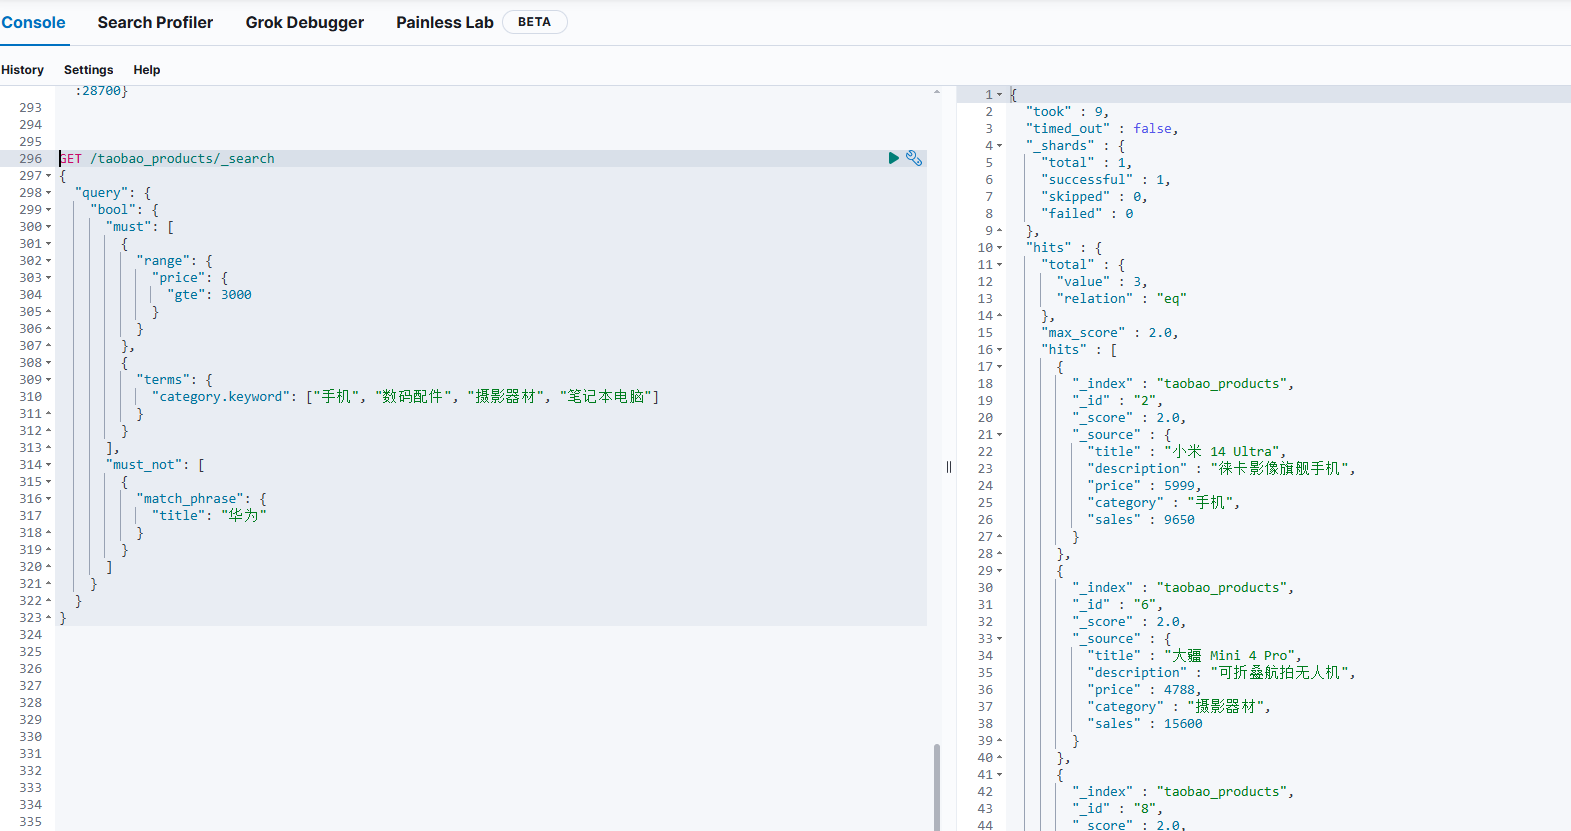
此处因为我们没有定义字段的mapping ,category字段可能已经被分词,所以我们指定查询的方式为keyword. 或者可以修改一下这个索引mapping。
PUT /taobao_products/_mapping
{
  "properties": {
    "category": {
      "type": "keyword"
    },
    "description": {
      "type": "text",
      "fields": {
        "keyword": {
          "type": "keyword",
          "ignore_above": 256
        }
      }
    },
    "price": {
      "type": "long"
    },
    "sales": {
      "type": "long"
    },
    "title": {
      "type": "text",
      "fields": {
        "keyword": {
          "type": "keyword",
          "ignore_above": 256
        }
      }
    }
  }
}
三、boosting query (提高查询)
概念
提高查询用于控制文档的相关性得分,它可以提升满足某个查询条件的文档的相关性得分,同时降低不满足另一个查询条件的文档的相关性得分。提高查询包含两个重要的子句:positive和negative,以及一个negative_boost参数。
positive:需要提升得分的查询条件。negative:需要降低得分的查询条件。negative_boost:降低得分的权重,取值范围在 0 到 1 之间,数值越小,降低的程度越大。
例子
查询手机类商品,同时降低销量低于 10000 的商品的相关性得分:
positive子句筛选出类别为手机的商品,negative子句找出销量低于 10000 的商品,并通过negative_boost参数将其相关性得分降低到原来的 30%。
GET /taobao_products/_search
{
  "query": {
    "boosting": {
      "positive": {
        "term": {
          "category.keyword": "手机"
        }
      },
      "negative": {
        "range": {
          "sales": {
            "lt": 10000
          }
        }
      },
      "negative_boost": 0.3
    }
  }
}
需要理解boosting查询的工作机制:它不会过滤文档,只会调整分数。具体来说:
positive 查询:匹配所有类别为 "手机" 的商品(在你的数据中是华为 Mate 60 Pro 和小米 14 Ultra)
negative 查询:检查这些商品的销量是否低于 10000
negative_boost=0.3:如果商品同时满足 negative 条件(销量 < 10000),则将其相关性分数乘以 0.3
数据情况:
华为 Mate 60 Pro:销量 12800(不满足 negative 条件,分数不变)
小米 14 Ultra:销量 9650(满足 negative 条件,分数 ×0.3)
预期结果:
两个商品都会返回,但小米 14 Ultra 的分数会被降低
如果按分数排序,华为 Mate 60 Pro 会排在前面
验证方法:
执行查询并查看返回结果的_score字段:
GET /taobao_products/_search
{
  "query": {
    "boosting": {
      "positive": {
        "term": {
          "category.keyword": "手机"
        }
      },
      "negative": {
        "range": {
          "sales": {
            "lt": 10000
          }
        }
      },
      "negative_boost": 0.3
    }
  },
  "_source": ["title", "sales"],
  "explain": true  // 显示分数计算详情
}
误解:
如果你期望销量 < 10000 的商品被完全过滤掉,需要使用bool查询而非boosting
GET /taobao_products/_search
{
  "query": {
    "bool": {
      "must": [
        { "term": { "category.keyword": "手机" } }
      ],
      "filter": [
        { "range": { "sales": { "gte": 10000 } } }
      ]
    }
  }
}
boosting查询语法正确,它会保留所有手机类商品,但降低销量低的商品的排名。如果这不是想要的效果,可以改用bool+filter组合。
四、constant_score(固定分数查询)
概念
固定分数查询会为所有匹配的文档分配一个固定的相关性得分,而不考虑文档与查询条件的实际匹配程度。它常用于在不关心文档相关性得分,只需要根据特定条件过滤文档的场景。固定分数查询通常与其他查询条件结合使用,通过filter子句来实现。
例子
查询所有销量超过 50000 的商品,并为这些商品分配固定的相关性得分 1.0:
GET /taobao_products/_search
{
  "query": {
    "constant_score": {
      "filter": {
        "range": {
          "sales": {
            "gt": 50000
          }
        }
      },
      "boost": 1.0
    }
  }
}
在这个filter子句筛选出销量超过 50000 的商品,boost参数为这些匹配的文档设置固定的相关性得分为 1.0。
五、dis_max (最佳匹配查询)
概念
最佳匹配查询会返回与任何一个查询条件匹配度最高的文档,它只考虑最佳匹配的查询子句,而忽略其他子句的匹配情况,并且会对最佳匹配的子句的相关性得分进行提升。dis_max 查询包含一个queries参数,用于指定多个查询子句。
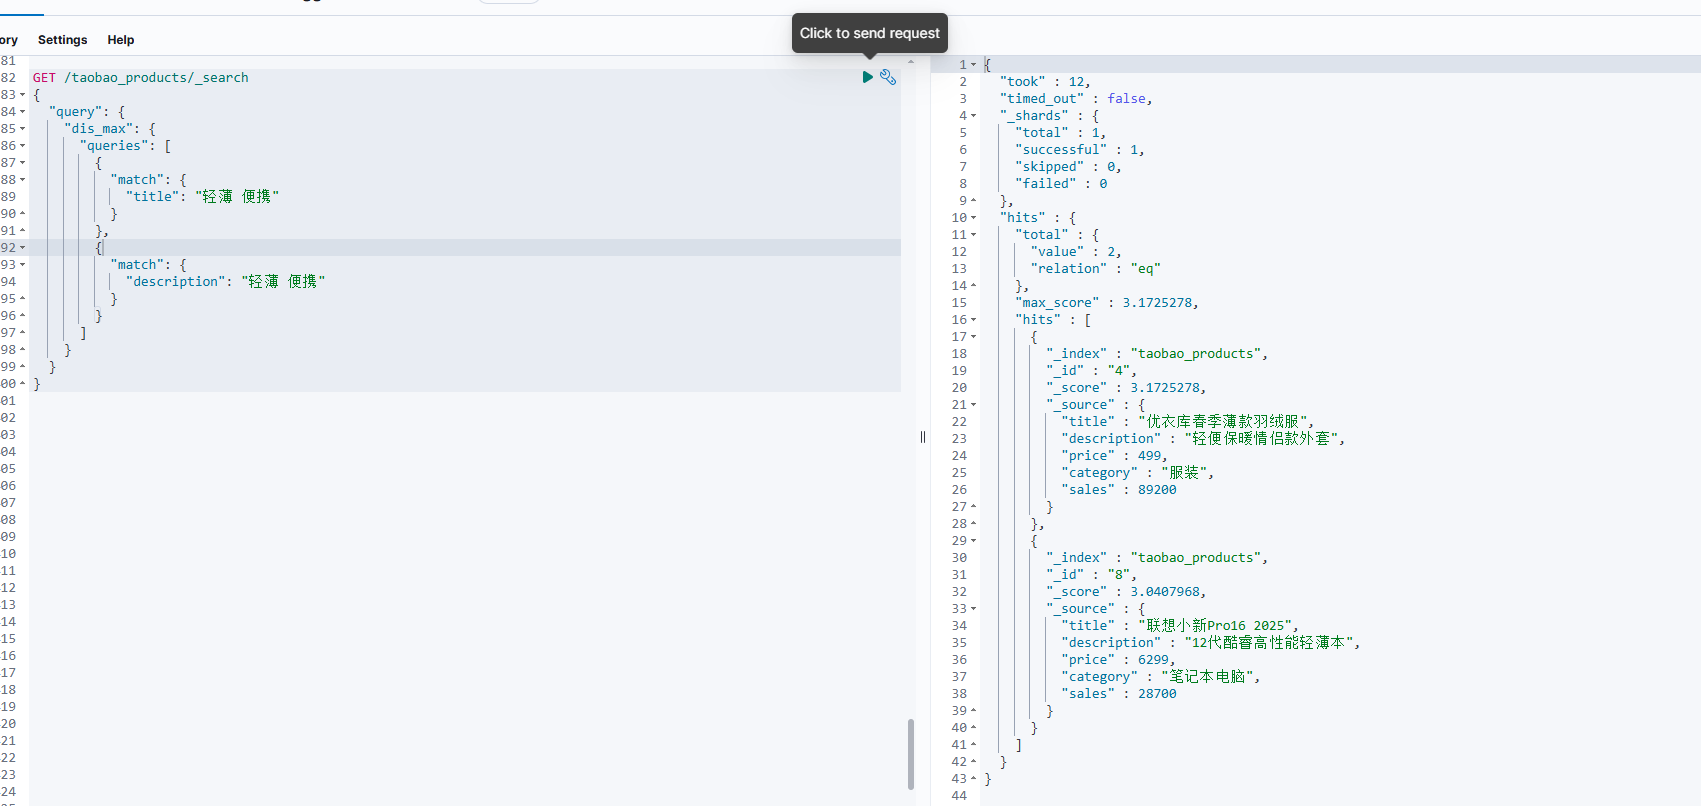
查询标题或描述中包含 “轻薄” 或 “便携” 的商品,只返回匹配度最高的文档:
GET /taobao_products/_search
{
  "query": {
    "dis_max": {
      "queries": [
        {
          "match": {
            "title": "轻薄 便携"
          }
        },
        {
          "match": {
            "description": "轻薄 便携"
          }
        }
      ]
    }
  }
}
queries参数包含了两个match查询,分别在商品的标题和描述中搜索 “轻薄” 和 “便携”,最终只会返回与这两个查询条件中匹配度最高的文档。
六、function_score (函数查询)
概念
函数查询允许我们根据自定义的函数来调整文档的相关性得分。它可以结合多种函数,如weight(固定权重)、random_score(随机得分)、field_value_factor(根据字段值计算得分)等,对文档的相关性得分进行灵活的控制。函数查询包含query子句用于指定基础查询条件,以及functions数组用于定义调整得分的函数。
例子
查询所有价格在 1000-5000 元之间的商品,并根据销量来调整相关性得分,销量越高,得分越高:
GET /taobao_products/_search
{
  "query": {
    "function_score": {
      "query": {
        "range": {
          "price": {
            "gte": 1000,
            "lte": 5000
          }
        }
      },
      "functions": [
        {
          "field_value_factor": {
            "field": "sales",
            "modifier": "log1p",
            "factor": 0.5
          }
        }
      ]
    }
  }
}
query子句先筛选出价格在 1000-5000 元之间的商品,functions数组中的field_value_factor函数根据商品的sales字段值来计算相关性得分,通过modifier参数指定使用log1p函数对销量进行转换,使得销量越高,相关性得分提升得越明显。
通过以上对 ElasticSearch 中五种复合查询方式的详细介绍和实例演示,相信你已经对复合查询有了更深入的理解。在实际应用中,根据不同的业务需求灵活选择和组合这些复合查询方式,能够帮助我们实现更加精准和高效的搜索功能。
评论区