




在 ElasticSearch 的实际应用中,对文本内容的搜索是最常见的需求之一,这类查询被称为全文搜索。在非结构化的文本数据中快速定位相关信息,是搜索引擎的核心能力。本文将从官网学习方法入手,深入解析 ElasticSearch 中全文搜索的各种 DSL 查询方式,包括match、query_string、simple_query_string和match_phrase等核心查询类型。
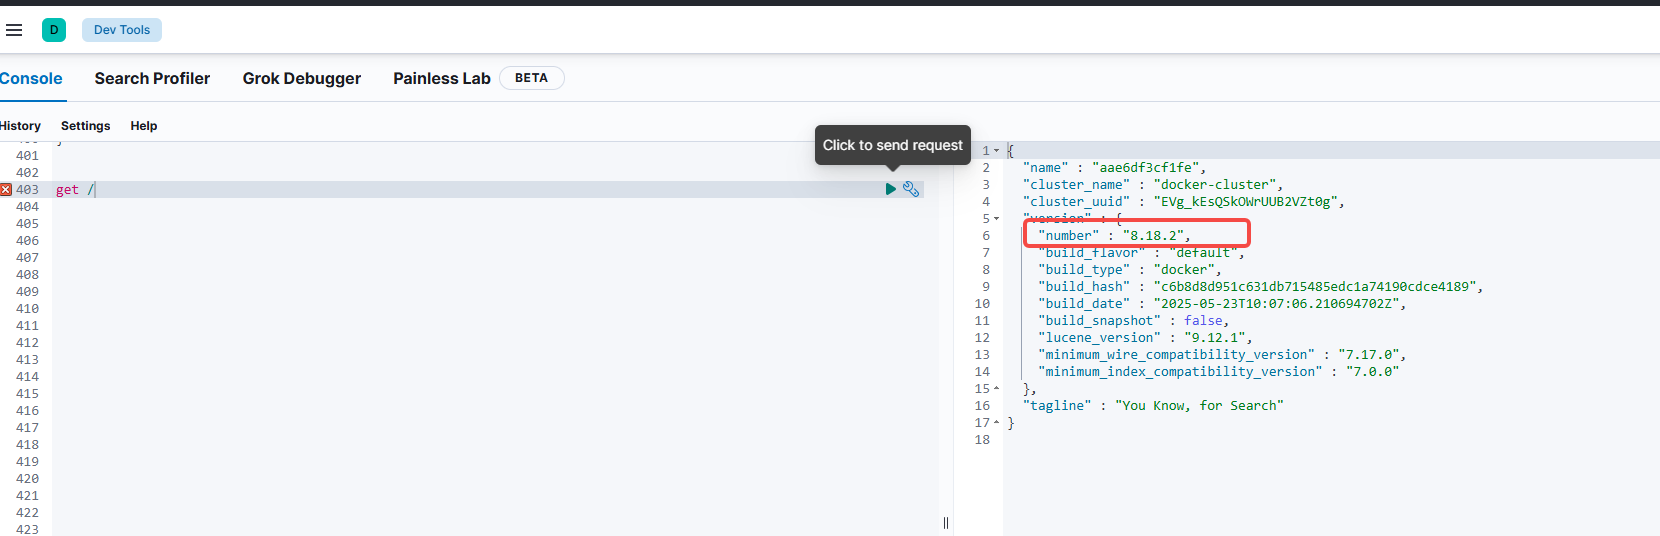
本文开始前,我特意部署了最新版本的ES 8.18. 大家在学习前要关注自己本地的版本
从官网学习
学习 ElasticSearch 的 DSL 查询,官方文档是最权威且全面的资料。建议按照以下步骤系统学习:
切换到你要了解的版本。
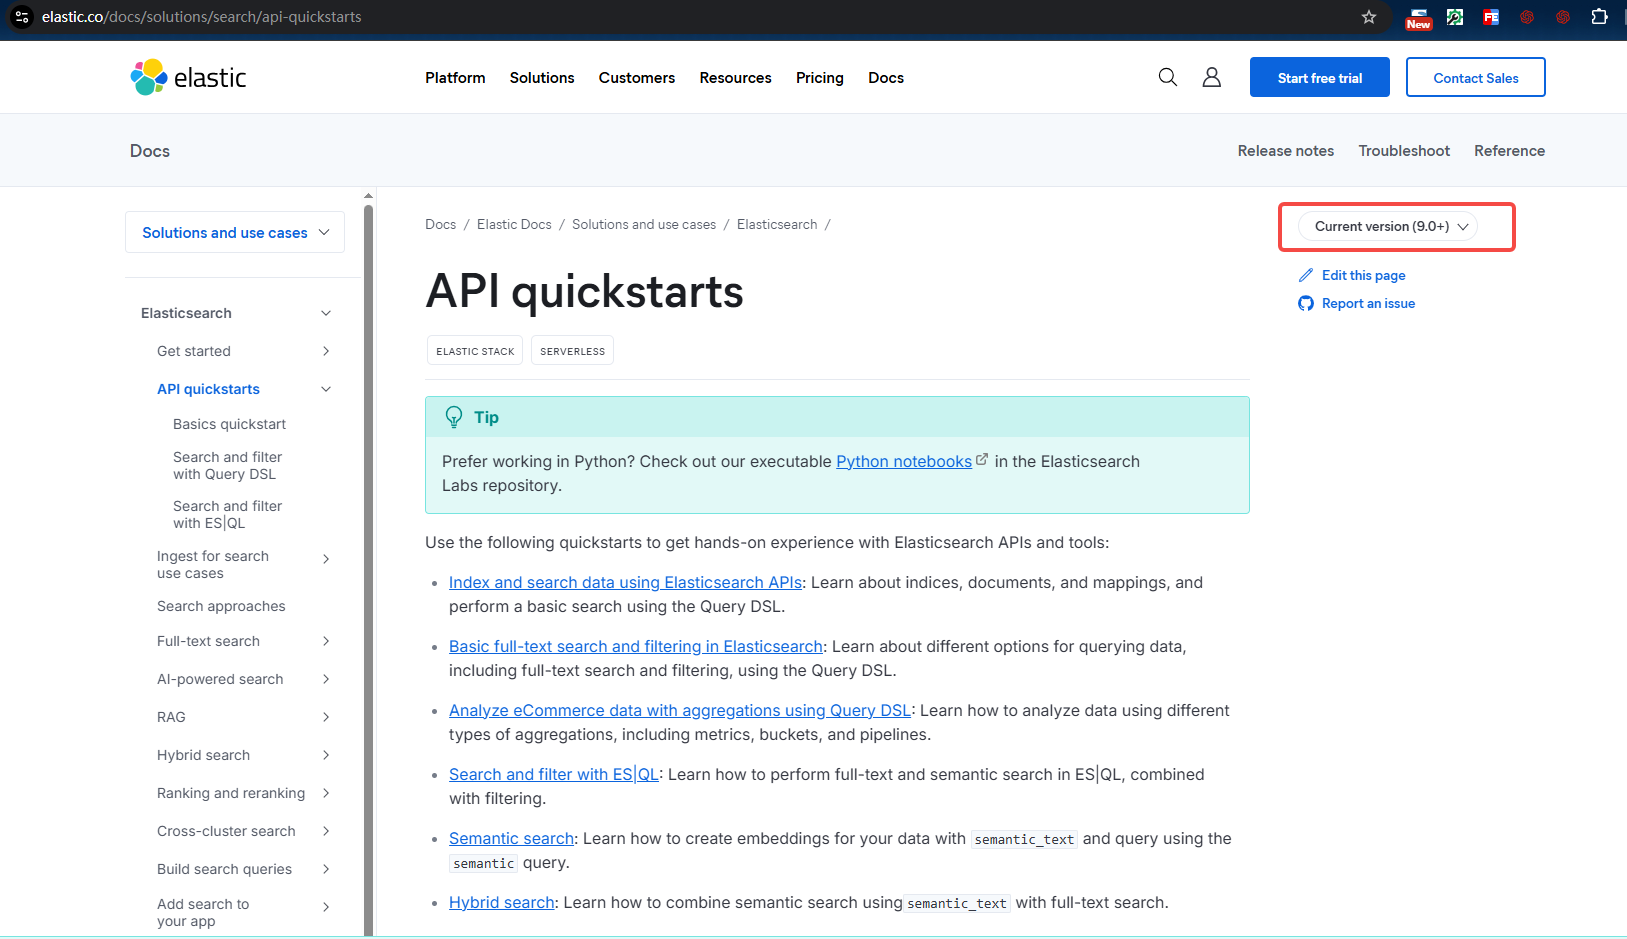
根据自己搭建的版本来看
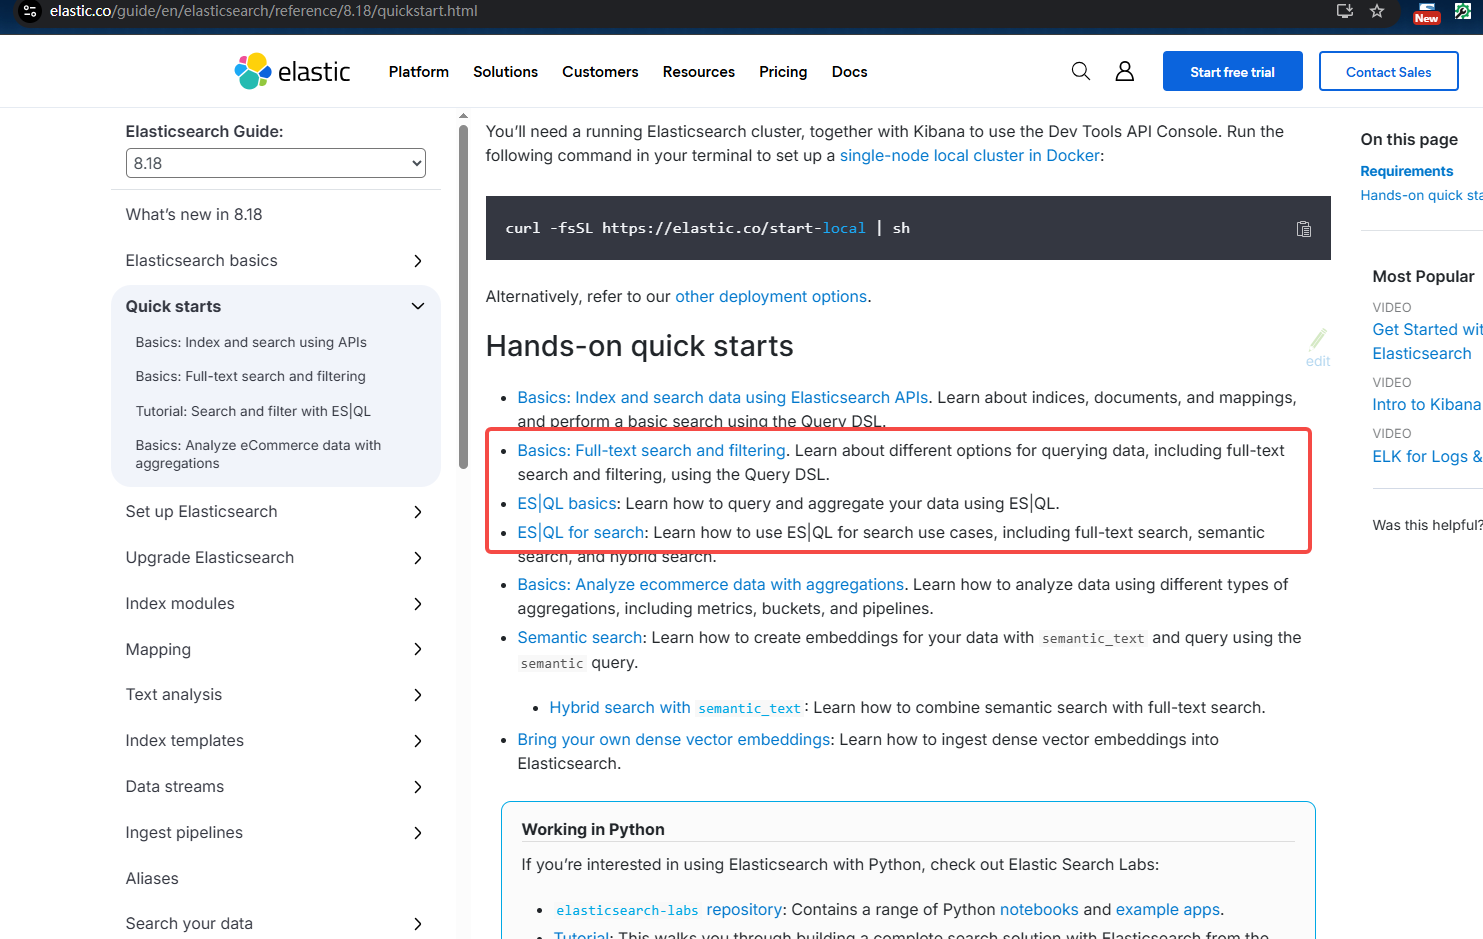
访问官方文档:
打开ElasticSearch 官方文档 https://www.elastic.co/guide/en/elasticsearch/reference/8.14/full-text-queries.html,定位到Query DSL章节。
理解核心概念:
重点阅读Text vs. Keyword章节,明确文本字段(text)和关键字段(keyword)的区别:
text字段会被分词器处理,适用于全文搜索
keyword字段保持原始值,适用于精确匹配
按查询类型分类学习:
官网将查询分为Leaf Query Clauses和Compound Query Clauses,全文搜索主要属于前者。
结合示例实践:
官网每个查询类型都提供了完整的 JSON 示例,建议在本地 ElasticSearch 环境中逐一测试。
关注版本差异:
注意文档顶部的版本选择器,确保学习内容与实际使用的 ElasticSearch 版本一致。
Match 类型查询
match查询是全文搜索的基础,它会根据字段的映射类型自动选择合适的查询方式:对text字段进行分词搜索,对keyword字段进行精确匹配。
match 查询的基本步骤
假设我们有一个博客文章索引blog_posts,包含title(文本类型)和author(关键字类型)字段:
// 创建索引并设置映射
PUT /blog_posts
{
  "mappings": {
    "properties": {
      "title": { "type": "text" },
      "author": { "type": "keyword" },
      "content": { "type": "text" }
    }
  }
}
// 插入测试数据
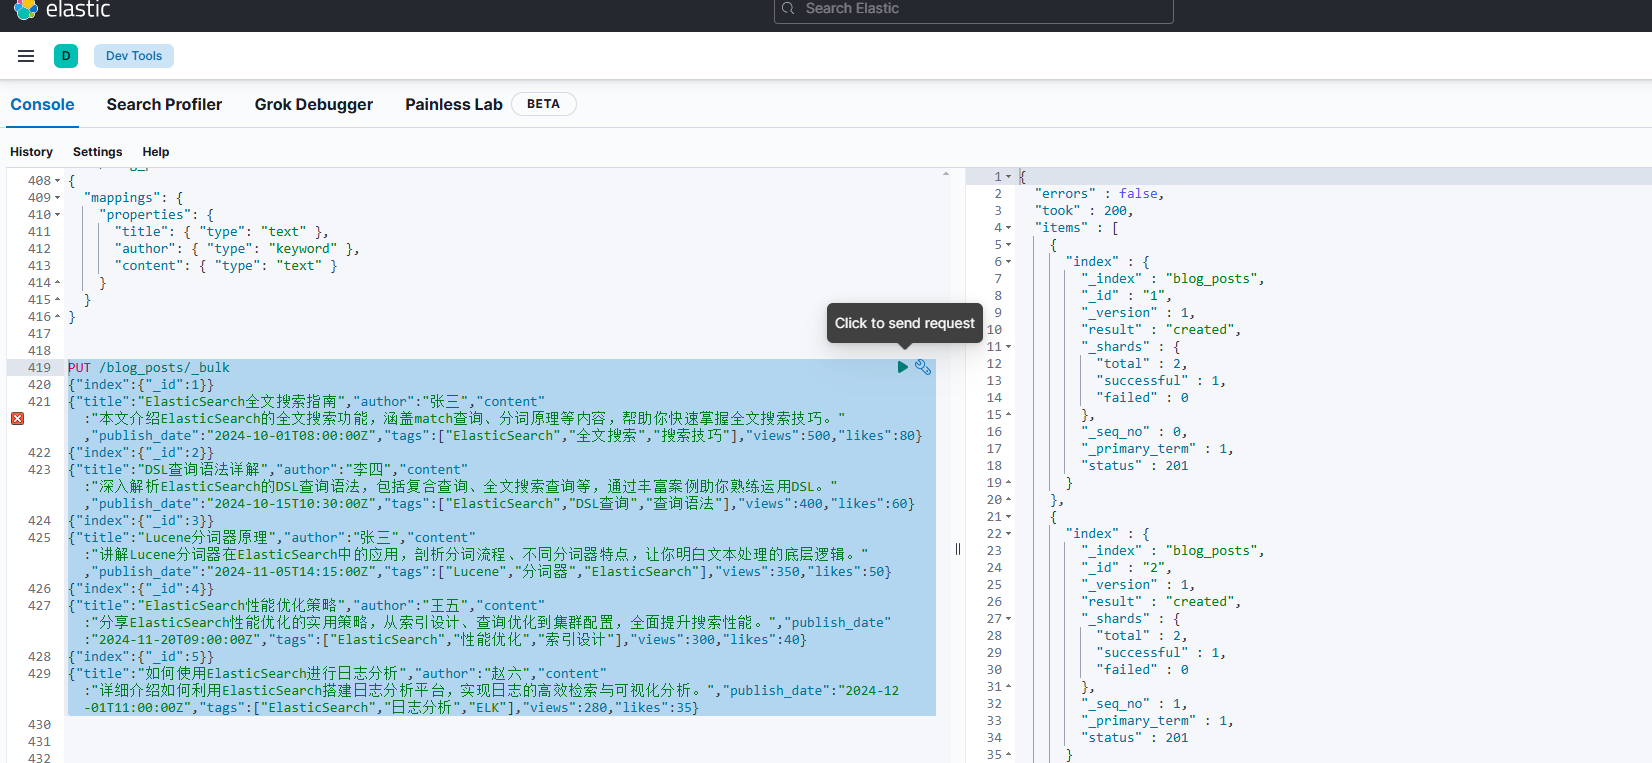
PUT /blog_posts/_bulk
{"index":{"_id":1}}
{"title":"ElasticSearch全文搜索指南","author":"张三","content":"本文介绍ElasticSearch的全文搜索功能,涵盖match查询、分词原理等内容,帮助你快速掌握全文搜索技巧。","publish_date":"2024-10-01T08:00:00Z","tags":["ElasticSearch","全文搜索","搜索技巧"],"views":500,"likes":80}
{"index":{"_id":2}}
{"title":"DSL查询语法详解","author":"李四","content":"深入解析ElasticSearch的DSL查询语法,包括复合查询、全文搜索查询等,通过丰富案例助你熟练运用DSL。","publish_date":"2024-10-15T10:30:00Z","tags":["ElasticSearch","DSL查询","查询语法"],"views":400,"likes":60}
{"index":{"_id":3}}
{"title":"Lucene分词器原理","author":"张三","content":"讲解Lucene分词器在ElasticSearch中的应用,剖析分词流程、不同分词器特点,让你明白文本处理的底层逻辑。","publish_date":"2024-11-05T14:15:00Z","tags":["Lucene","分词器","ElasticSearch"],"views":350,"likes":50}
{"index":{"_id":4}}
{"title":"ElasticSearch性能优化策略","author":"王五","content":"分享ElasticSearch性能优化的实用策略,从索引设计、查询优化到集群配置,全面提升搜索性能。","publish_date":"2024-11-20T09:00:00Z","tags":["ElasticSearch","性能优化","索引设计"],"views":300,"likes":40}
{"index":{"_id":5}}
{"title":"如何使用ElasticSearch进行日志分析","author":"赵六","content":"详细介绍如何利用ElasticSearch搭建日志分析平台,实现日志的高效检索与可视化分析。","publish_date":"2024-12-01T11:00:00Z","tags":["ElasticSearch","日志分析","ELK"],"views":280,"likes":35}
基础 match 查询
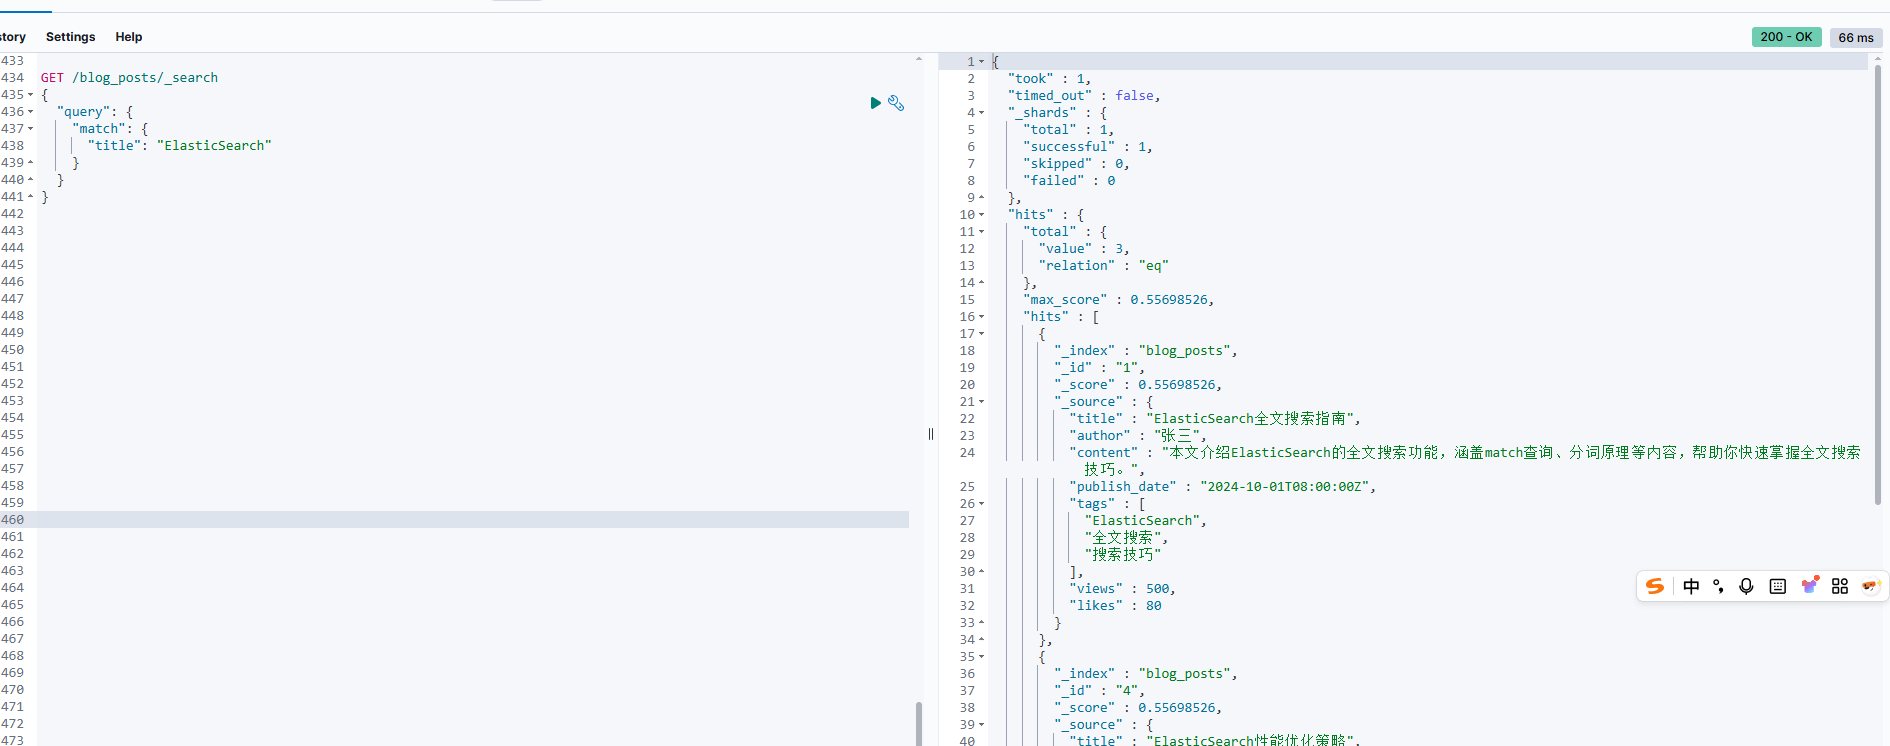
查询标题中包含 "ElasticSearch" 的文章:
GET /blog_posts/_search
{
  "query": {
    "match": {
      "title": "ElasticSearch"
    }
  }
}
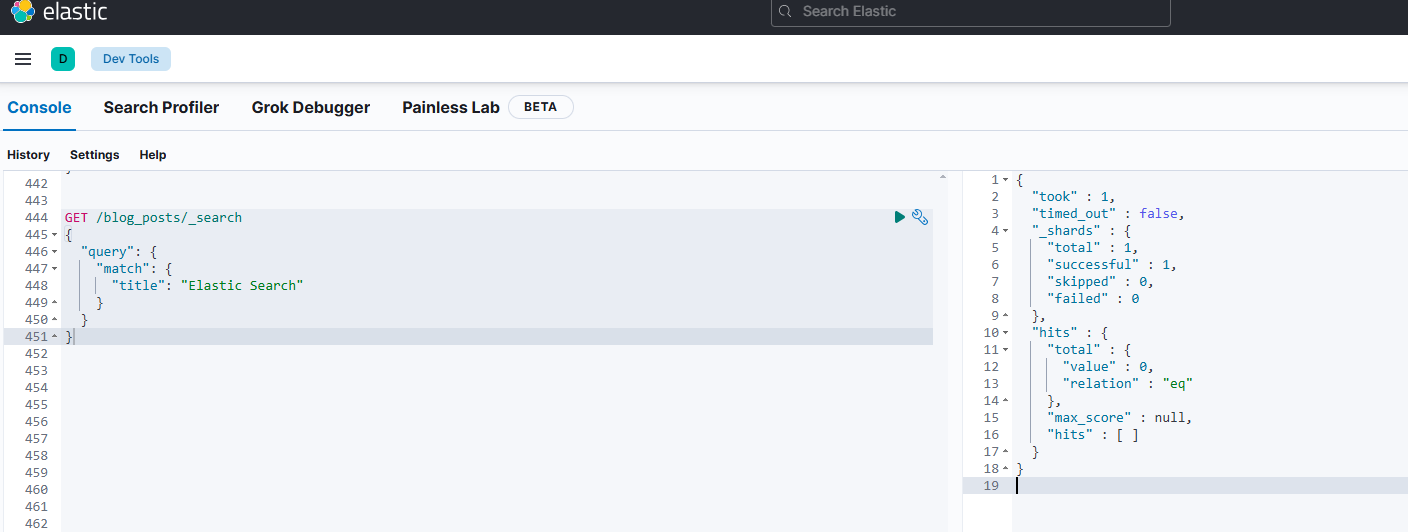
// 这个是查不出来的
GET /blog_posts/_search
{
  "query": {
    "match": {
      "title": "Elastic Search"
    }
  }
}
这个可以查询到结果
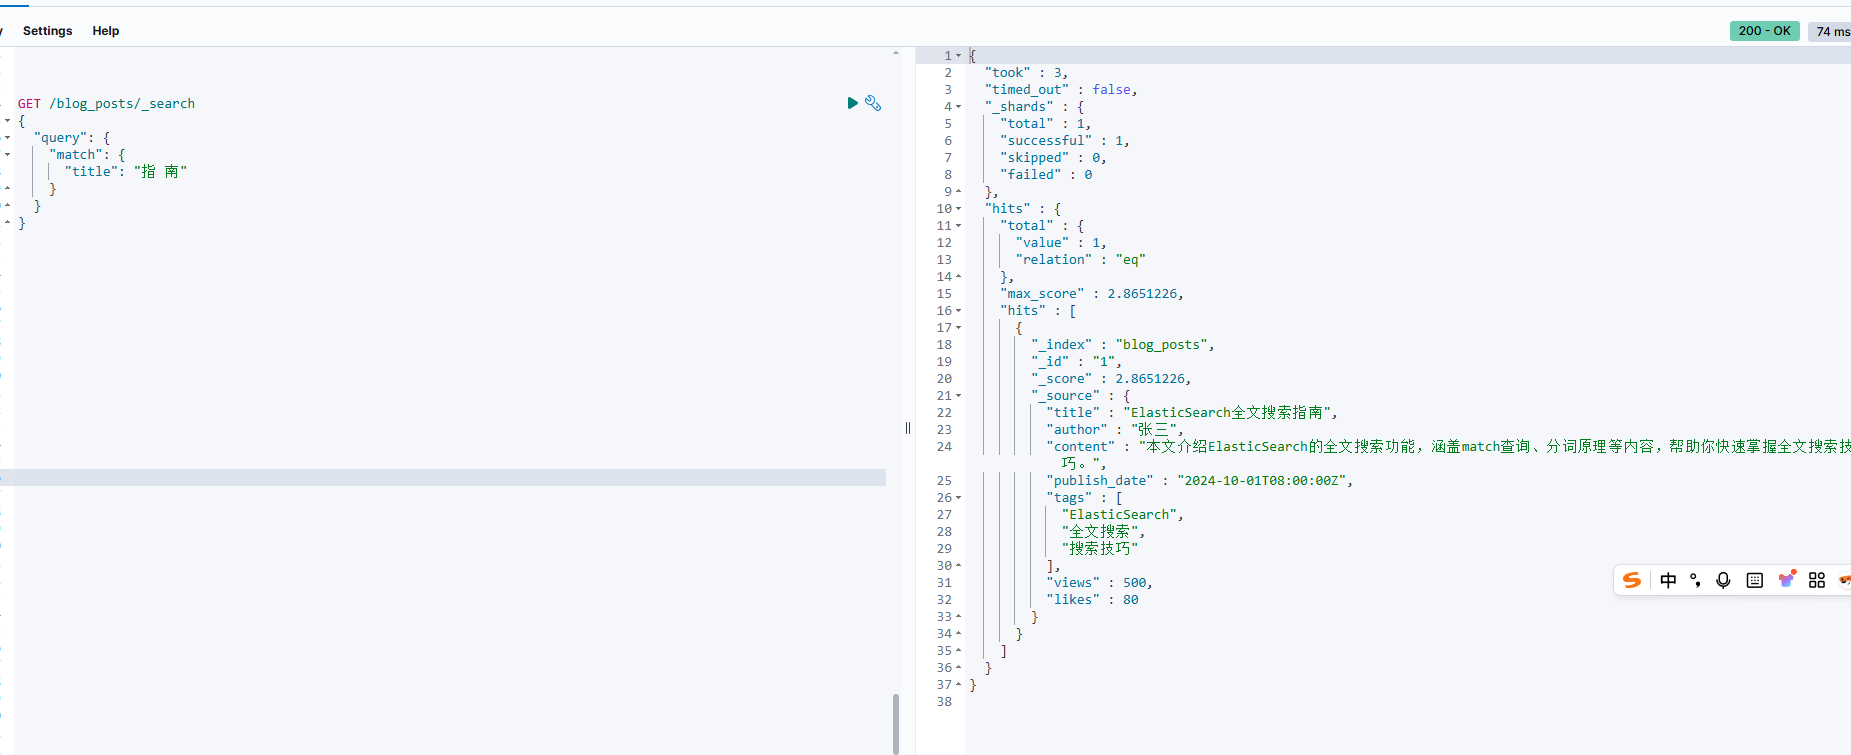
从这个可以看出来 中文分词和英文分词的规则是不一样的。所以在检索的时候也要注意,每个分词器也不一样。
分词效果验证
通过_analyze接口查看分词结果:
GET /blog_posts/_analyze
{
  "field": "title",
  "text": "ElasticSearch全文搜索指南"
}
输出结果(假设使用默认分词器):
{
  "tokens" : [
    {
      "token" : "elasticsearch",
      "start_offset" : 0,
      "end_offset" : 13,
      "type" : "<ALPHANUM>",
      "position" : 0
    },
    {
      "token" : "全",
      "start_offset" : 13,
      "end_offset" : 14,
      "type" : "<IDEOGRAPHIC>",
      "position" : 1
    },
    {
      "token" : "文",
      "start_offset" : 14,
      "end_offset" : 15,
      "type" : "<IDEOGRAPHIC>",
      "position" : 2
    },
    {
      "token" : "搜",
      "start_offset" : 15,
      "end_offset" : 16,
      "type" : "<IDEOGRAPHIC>",
      "position" : 3
    },
    {
      "token" : "索",
      "start_offset" : 16,
      "end_offset" : 17,
      "type" : "<IDEOGRAPHIC>",
      "position" : 4
    },
    {
      "token" : "指",
      "start_offset" : 17,
      "end_offset" : 18,
      "type" : "<IDEOGRAPHIC>",
      "position" : 5
    },
    {
      "token" : "南",
      "start_offset" : 18,
      "end_offset" : 19,
      "type" : "<IDEOGRAPHIC>",
      "position" : 6
    }
  ]
}
match 多个词
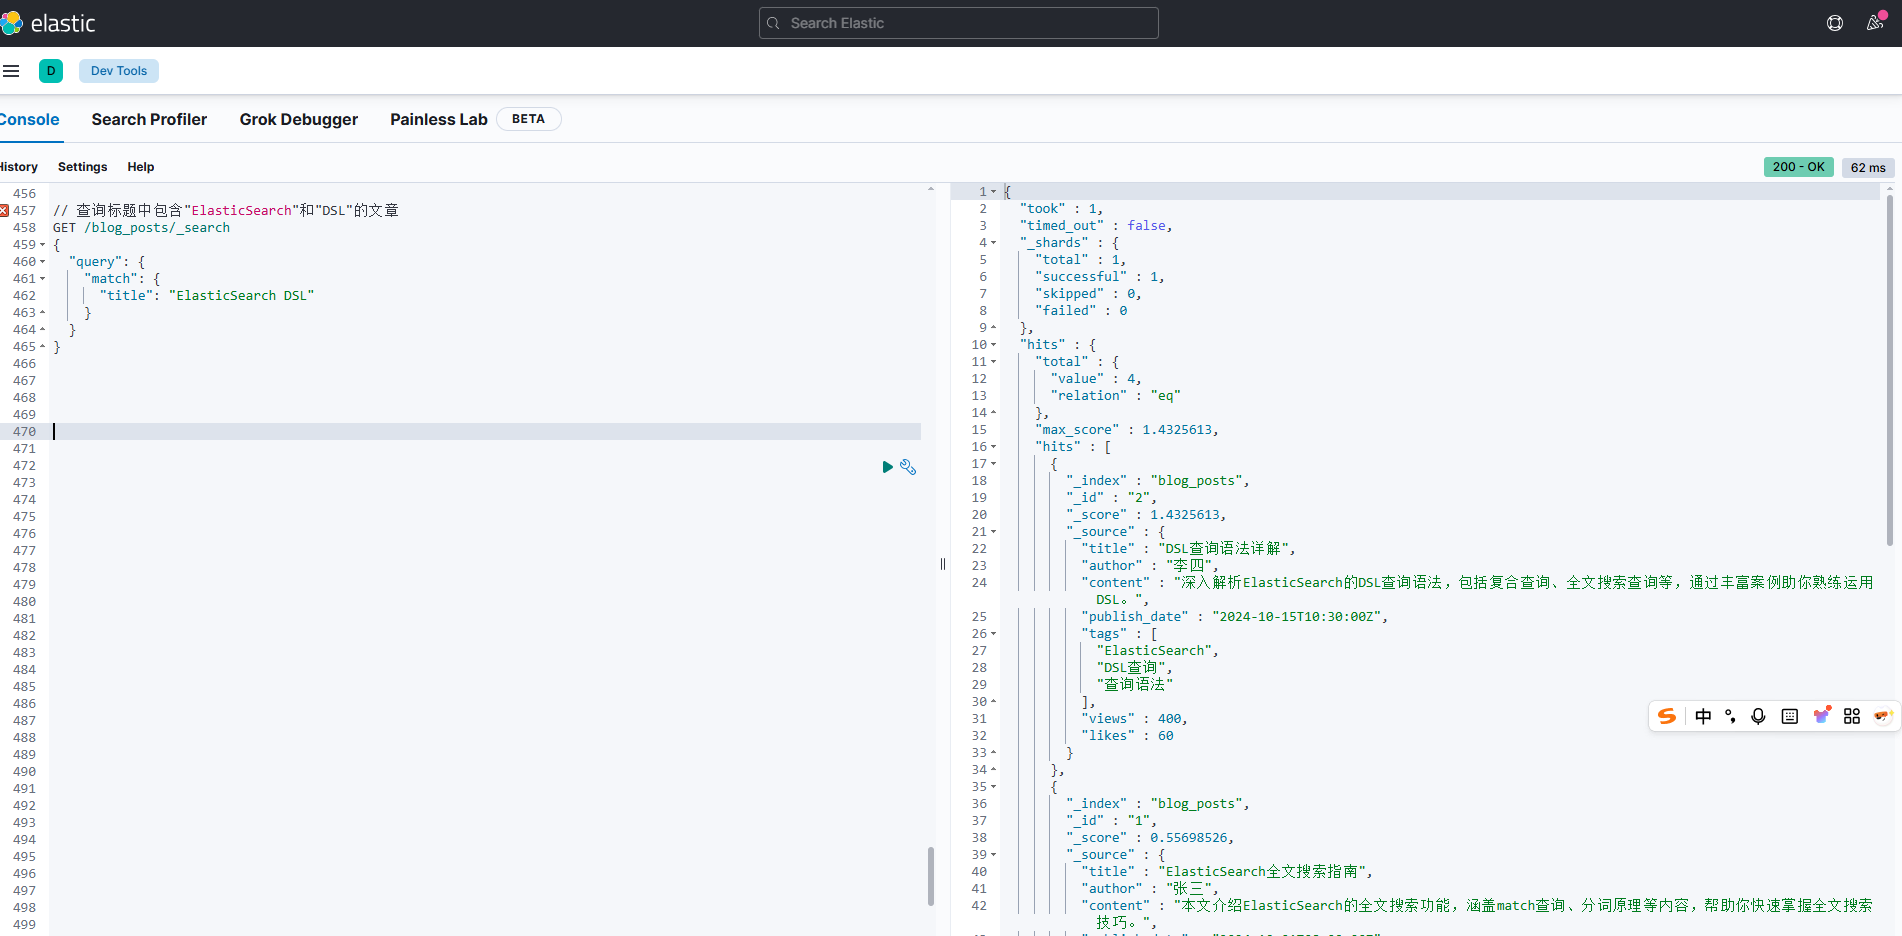
当查询包含多个词时,match查询会将所有词的分词结果进行组合搜索:
// 查询标题中包含"ElasticSearch"和"DSL"的文章
GET /blog_posts/_search
{
  "query": {
    "match": {
      "title": "ElasticSearch DSL"
    }
  }
}
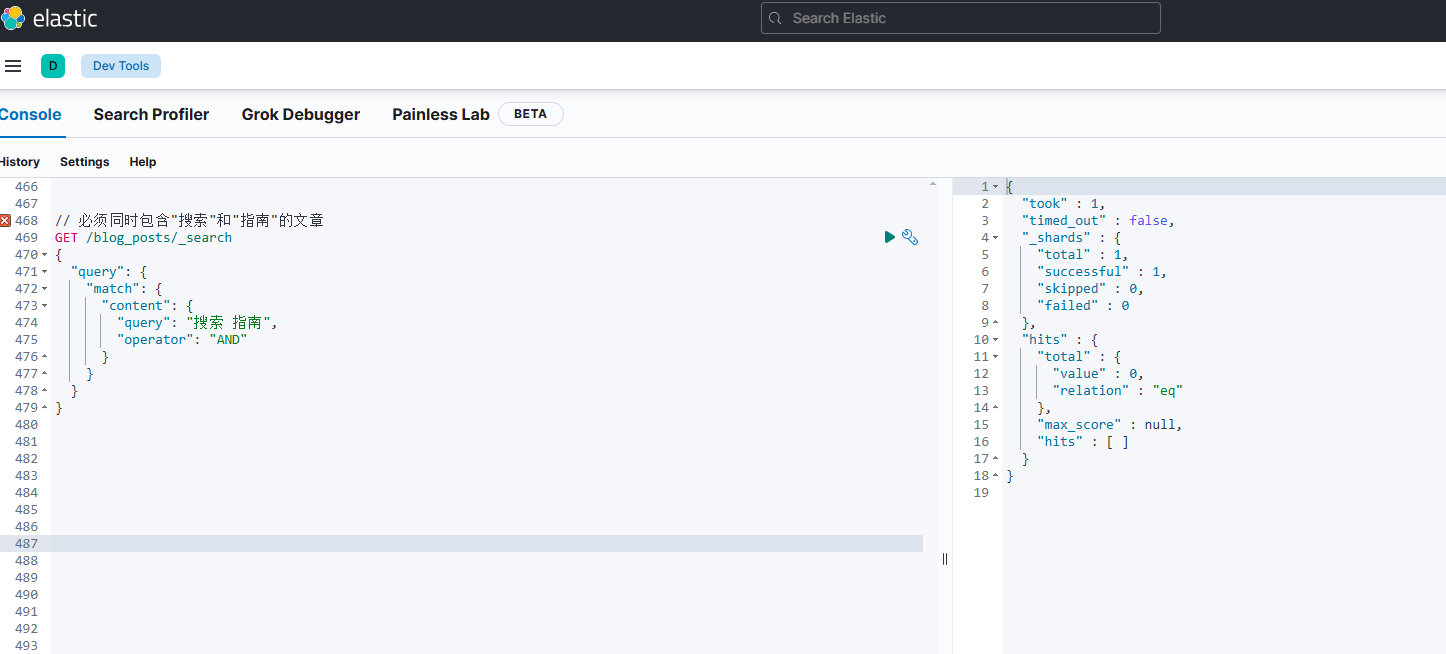
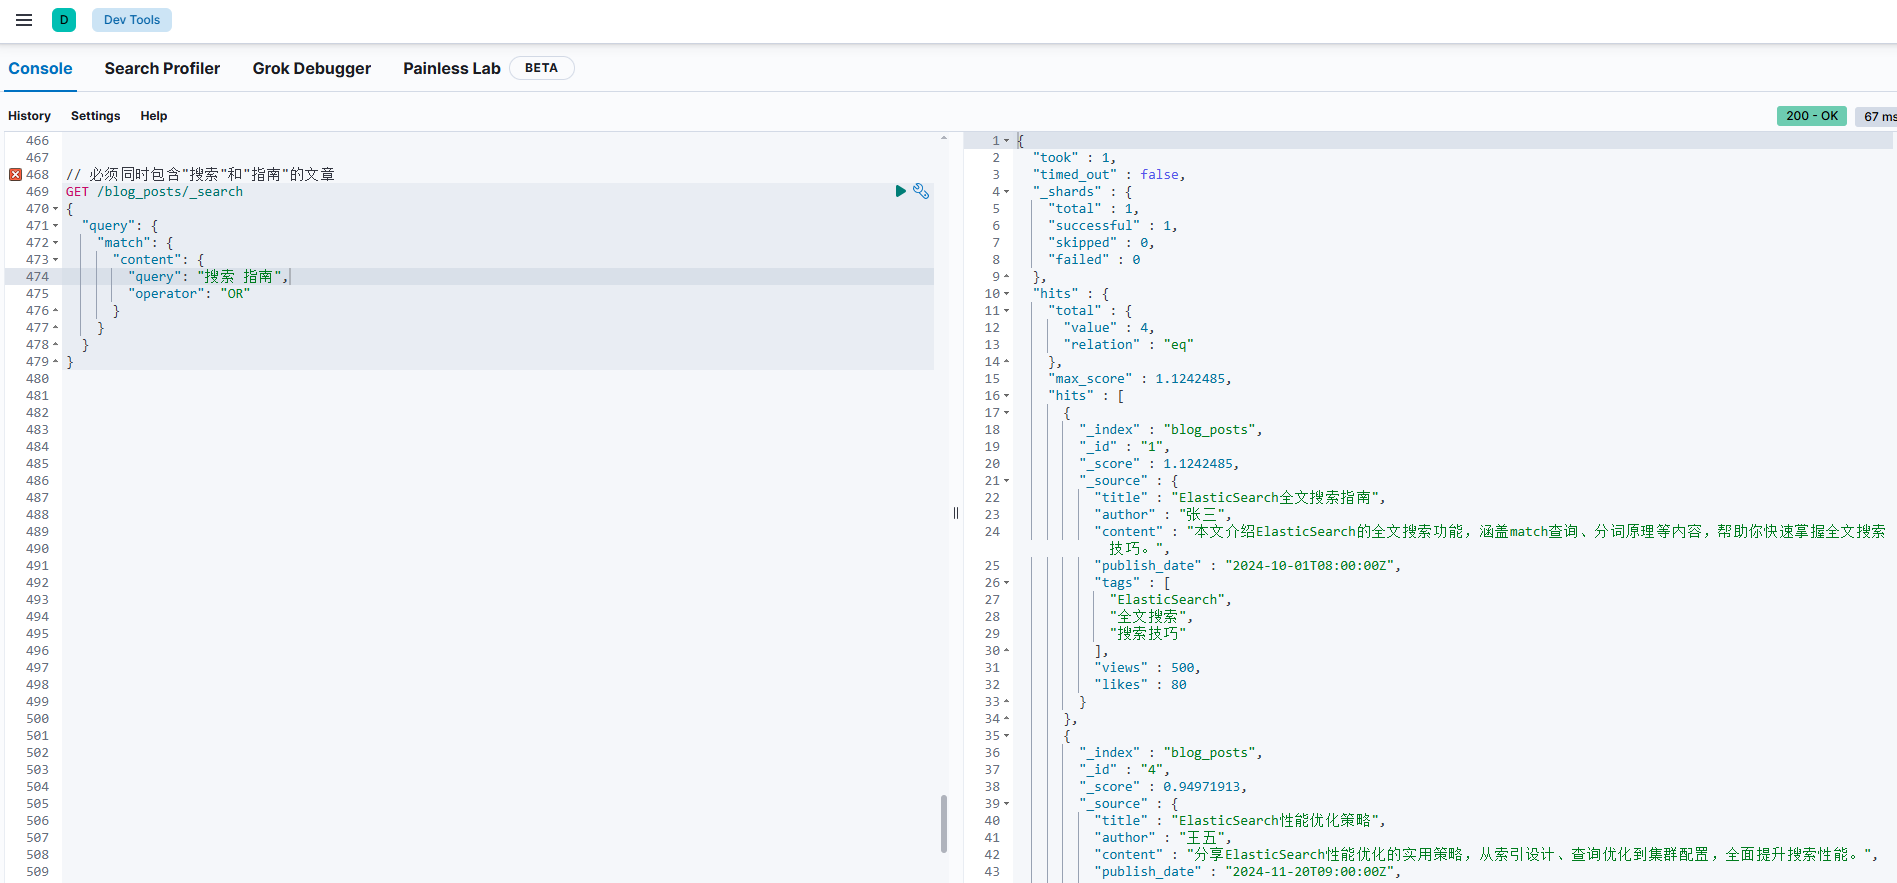
操作符控制(operator 参数)
OR(默认):匹配任意一个词的分词结果
AND:必须匹配所有词的分词结果
// 必须同时包含"搜索"和"指南"的文章
GET /blog_posts/_search
{
  "query": {
    "match": {
      "content": {
        "query": "搜索 指南",
        "operator": "AND"
      }
    }
  }
}

// 必须同时包含"搜索"和"指南"的文章
GET /blog_posts/_search
{
  "query": {
    "match": {
      "content": {
        "query": "搜索 指南",
        "operator": "OR"
      }
    }
  }
}
深入控制 match 的匹配精度
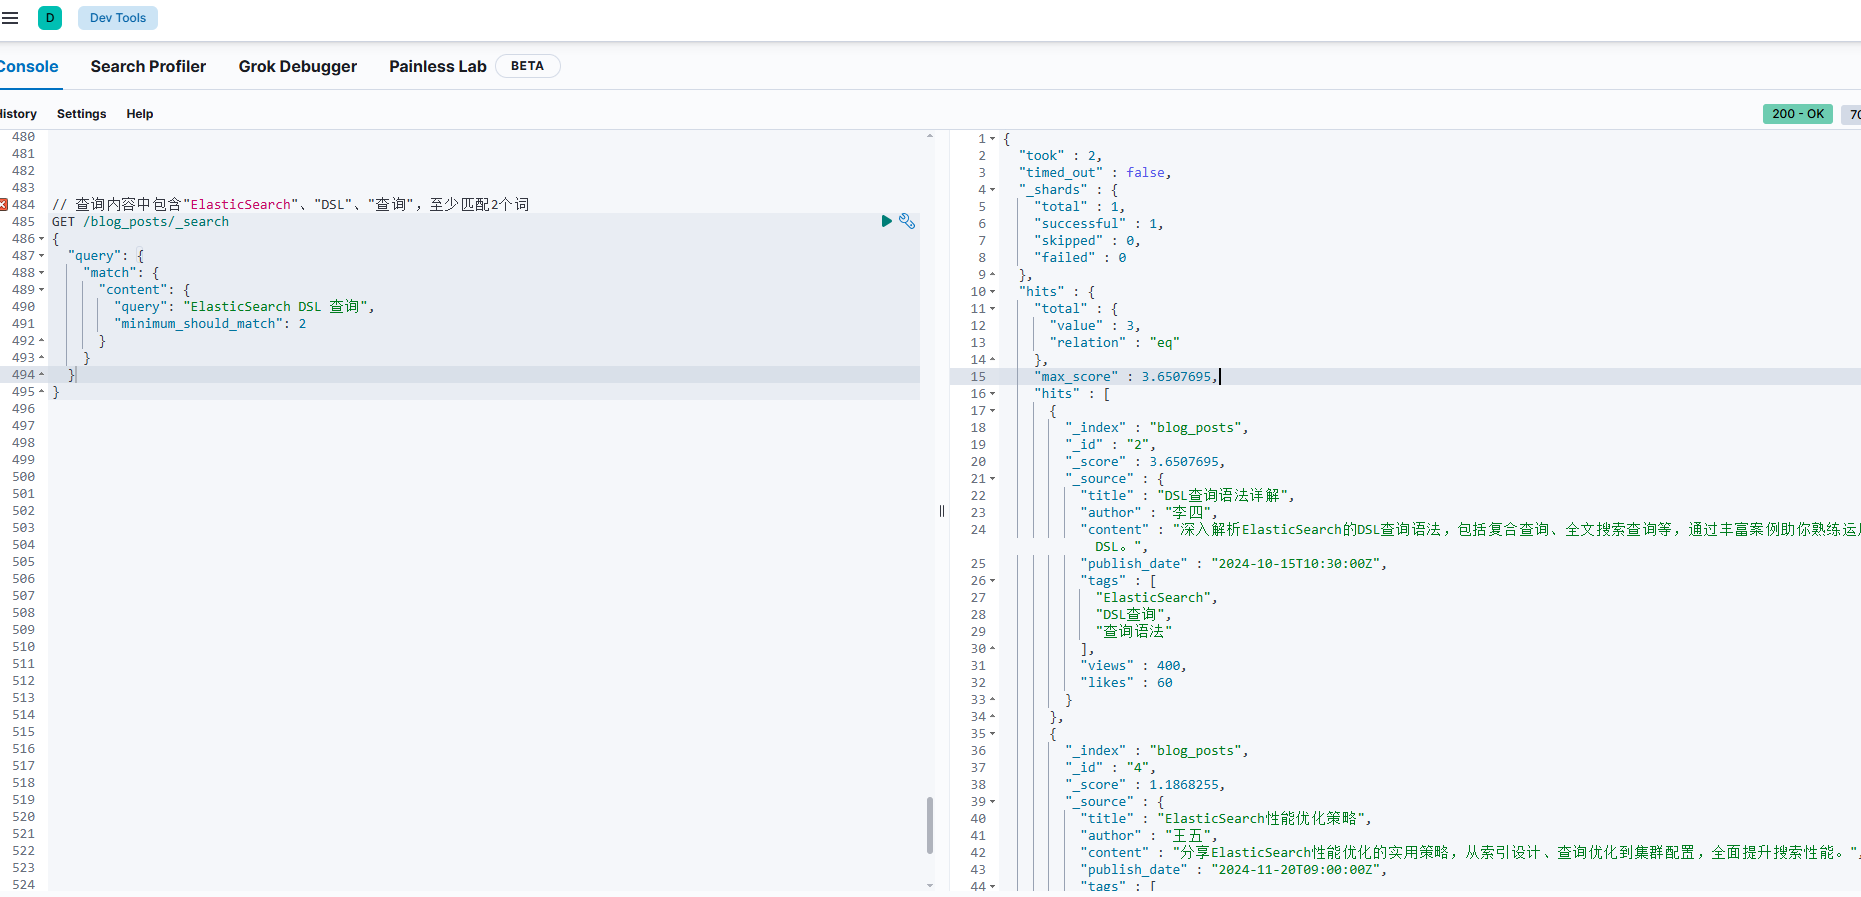
最小应该匹配数(minimum_should_match)
当使用match查询多个词时,可以通过minimum_should_match参数控制至少需要匹配的词数:
// 查询内容中包含"ElasticSearch"、"DSL"、"查询",至少匹配2个词
GET /blog_posts/_search
{
  "query": {
    "match": {
      "content": {
        "query": "ElasticSearch DSL 查询",
        "minimum_should_match": 2
      }
    }
  }
}
提升特定词的权重(boost)
通过boost参数可以提升某个词的相关性权重:
相关性得分基础:Elasticsearch 使用 TF-IDF(词频 - 逆文档频率)算法计算相关性得分。简单来说,某个词在文档中出现的频率越高(词频 TF),同时该词在整个索引中出现的文档数量越少(逆文档频率 IDF),那么这个词所在文档的相关性得分就越高。例如,在我们的示例数据中,“ElasticSearch” 在多篇文章中出现,而 “DSL” 仅在部分文章中出现,正常情况下,同时包含 “DSL” 的文章相关性得分会更高。
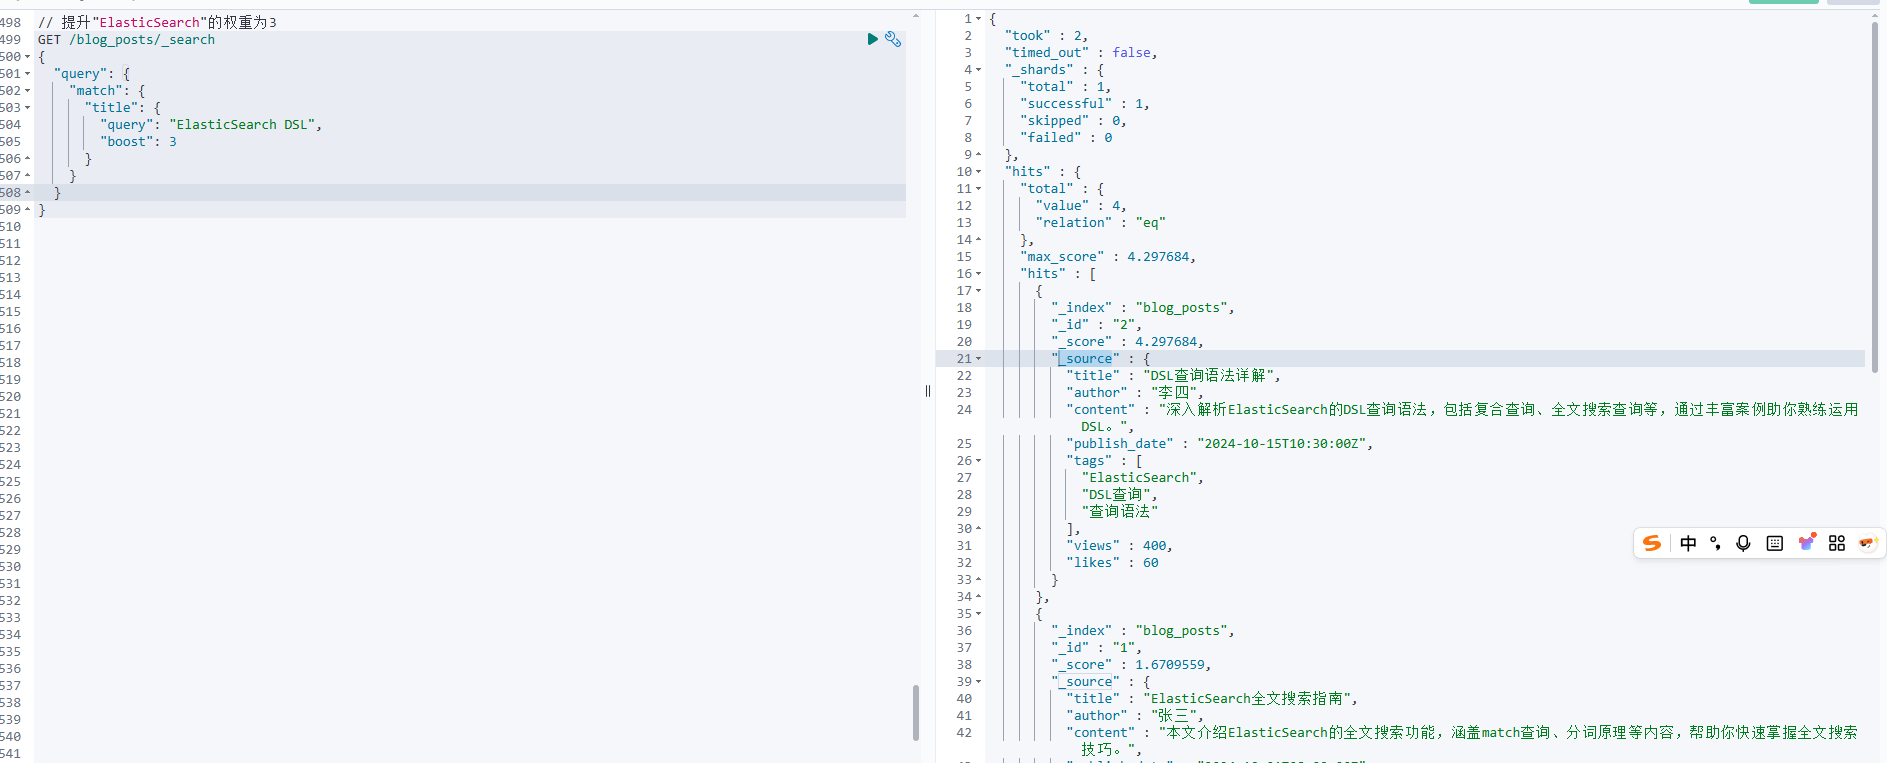
// 提升"ElasticSearch"的权重为3
GET /blog_posts/_search
{
  "query": {
    "match": {
      "title": {
        "query": "ElasticSearch DSL",
        "boost": 3
      }
    }
  }
}
其它 match 类型
match_phrase 查询
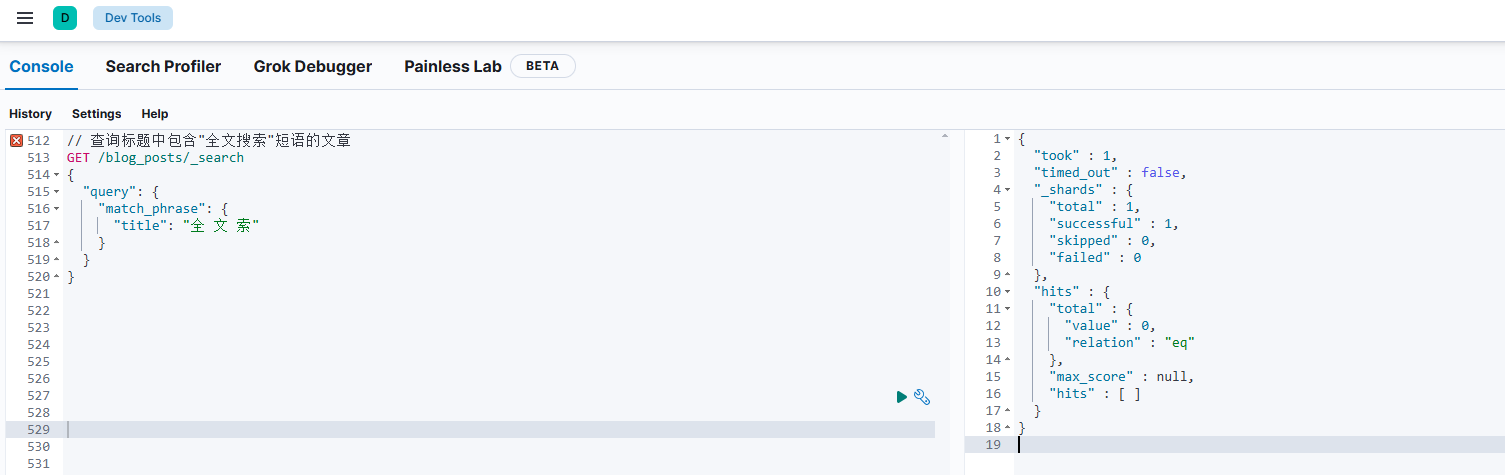
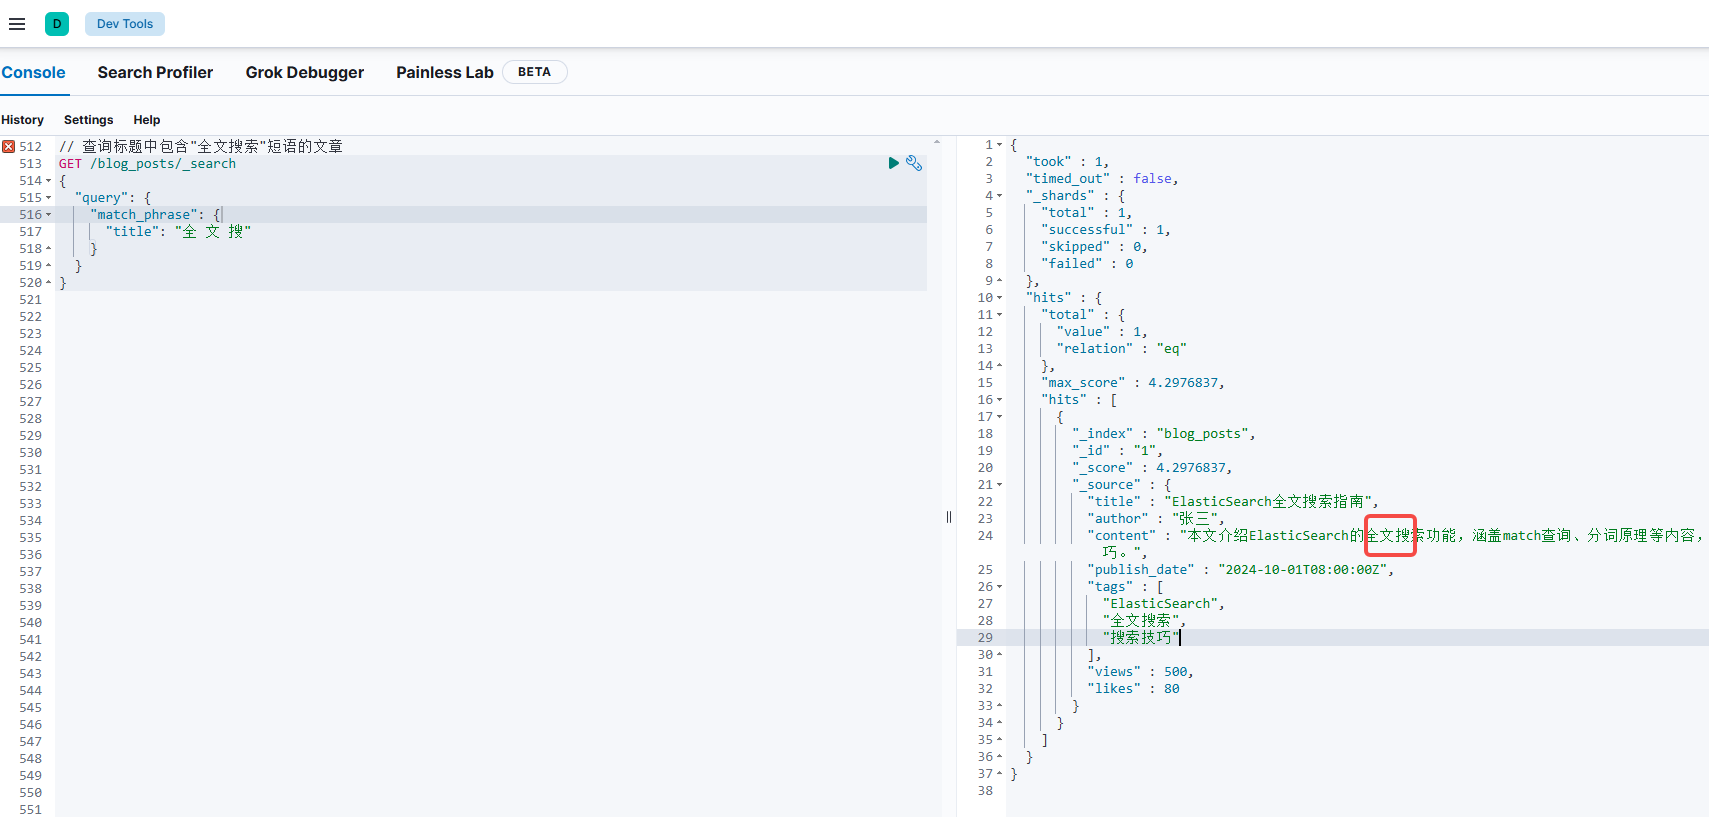
match_phrase查询要求多个词在文本中连续出现,并且顺序一致,常用于短语搜索:
// 查询标题中包含"全文搜索"短语的文章
GET /blog_posts/_search
{
  "query": {
    "match_phrase": {
      "title": "全文搜索"
    }
  }
}
滑动窗口(slop)
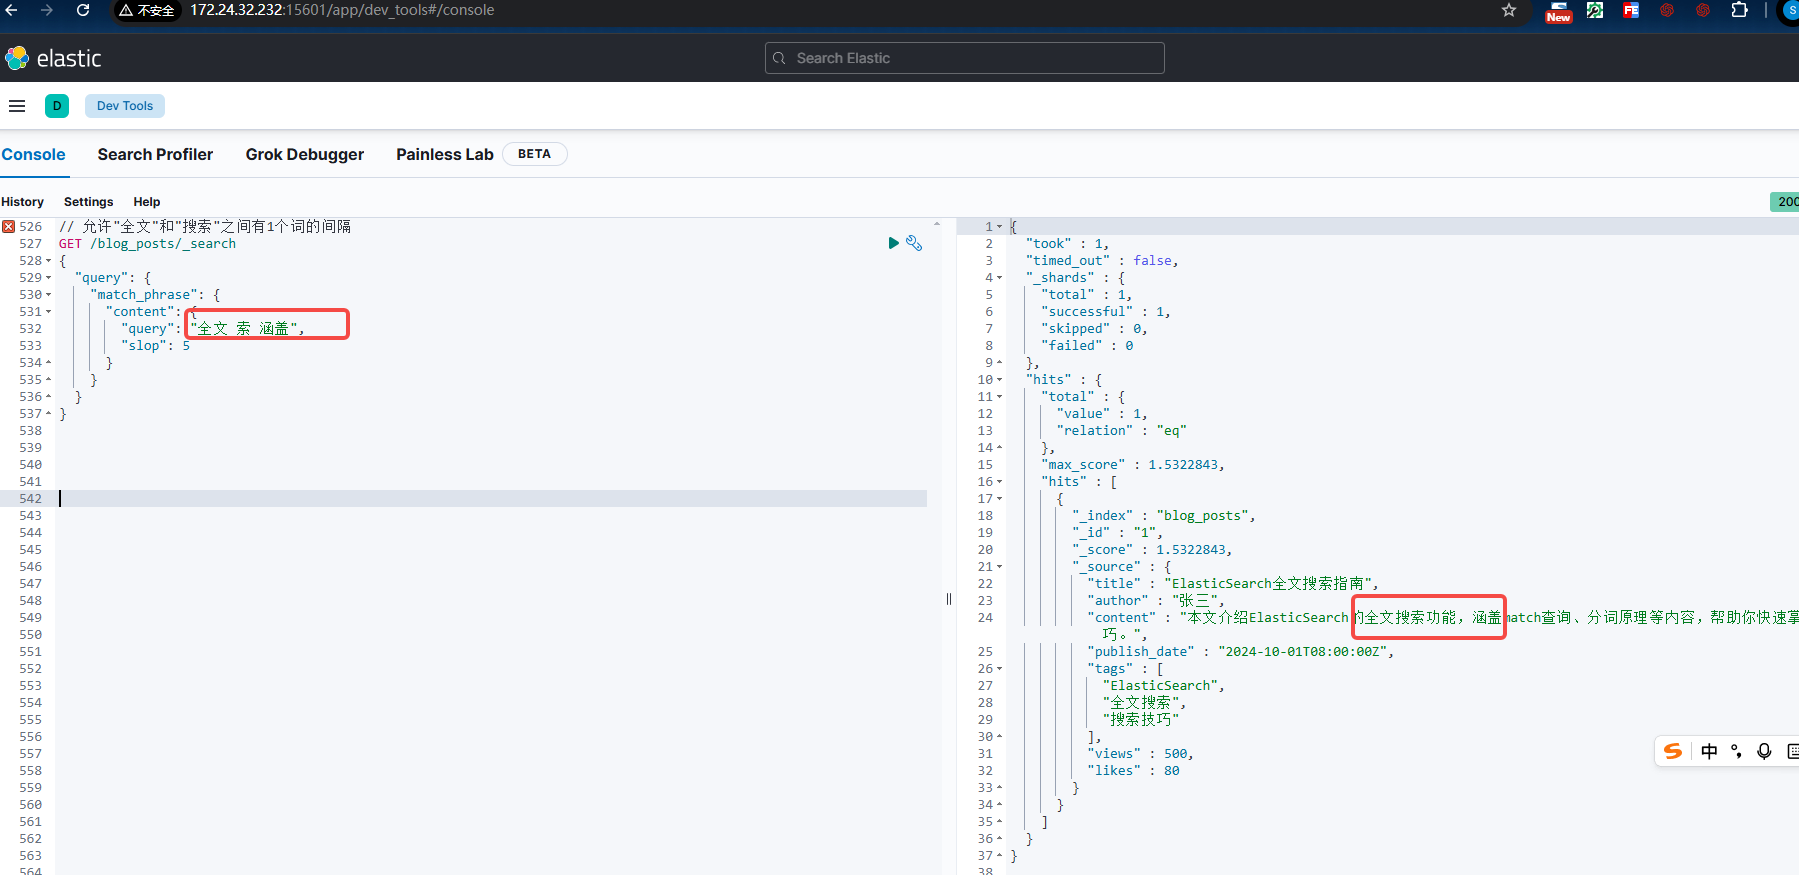
通过slop参数允许短语中的词之间存在间隔:
// 允许"全文"和"搜索"之间有1个词的间隔
GET /blog_posts/_search
{
  "query": {
    "match_phrase": {
      "content": {
        "query": "全文 索 涵盖",
        "slop": 5
      }
    }
  }
}
match_phrase_prefix 查询
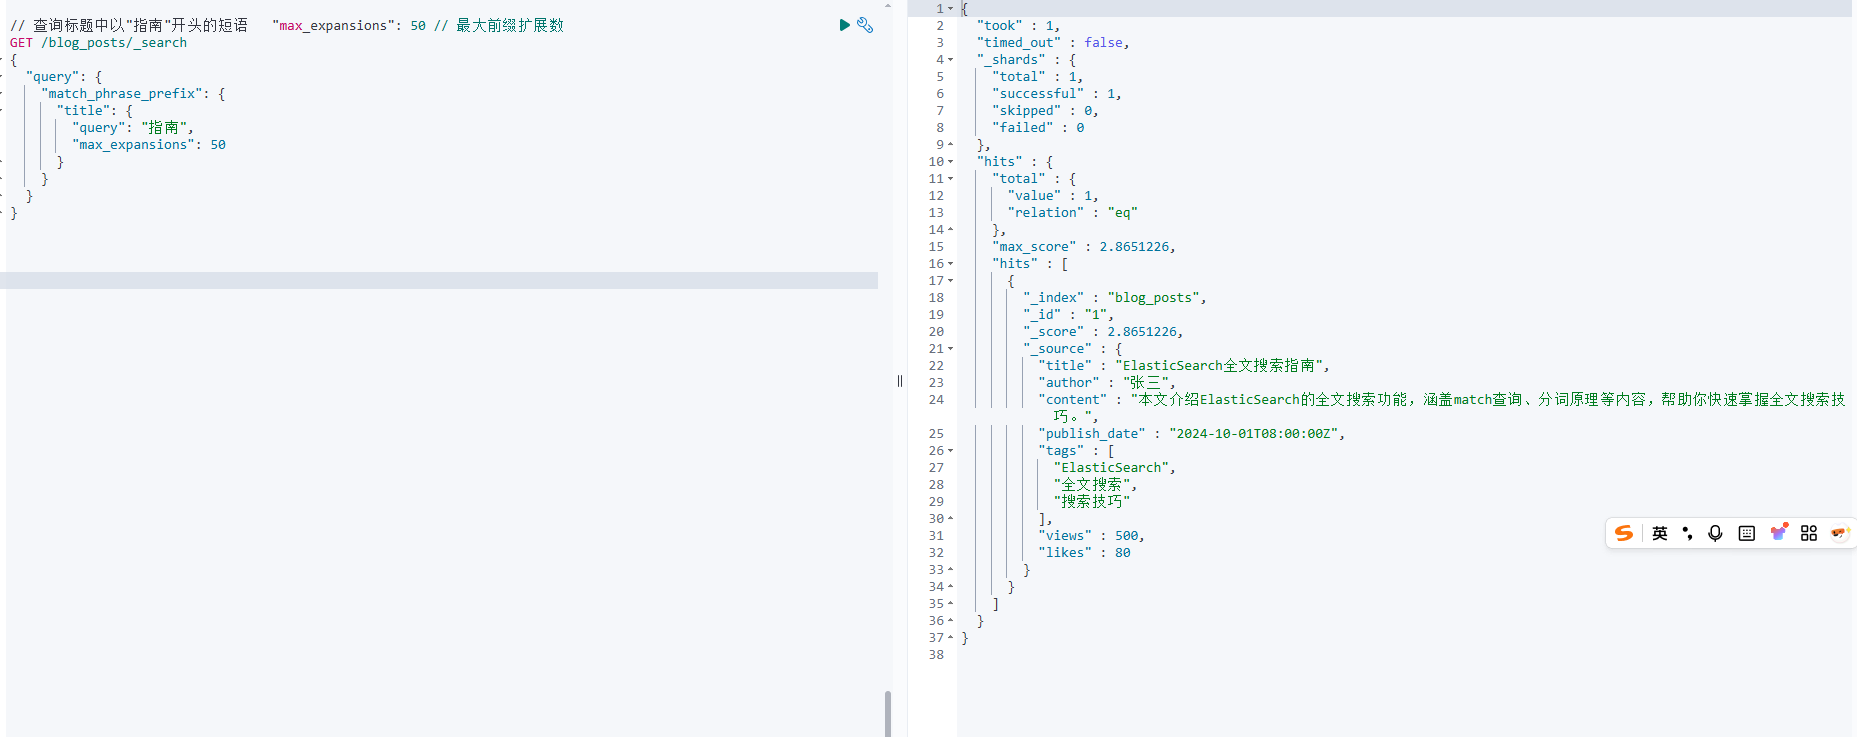
match_phrase_prefix是match_phrase的前缀版本,最后一个词会进行前缀匹配,适用于自动补全场景:
// 查询标题中以"指南"开头的短语   "max_expansions": 50 // 最大前缀扩展数
GET /blog_posts/_search
{
  "query": {
    "match_phrase_prefix": {
      "title": {
        "query": "指南",
        "max_expansions": 50
      }
    }
  }
}
Query String 类型查询
query_string查询支持更复杂的语法,类似于搜索引擎的搜索框语法,但需要注意潜在的语法错误风险。
query_string 基础用法
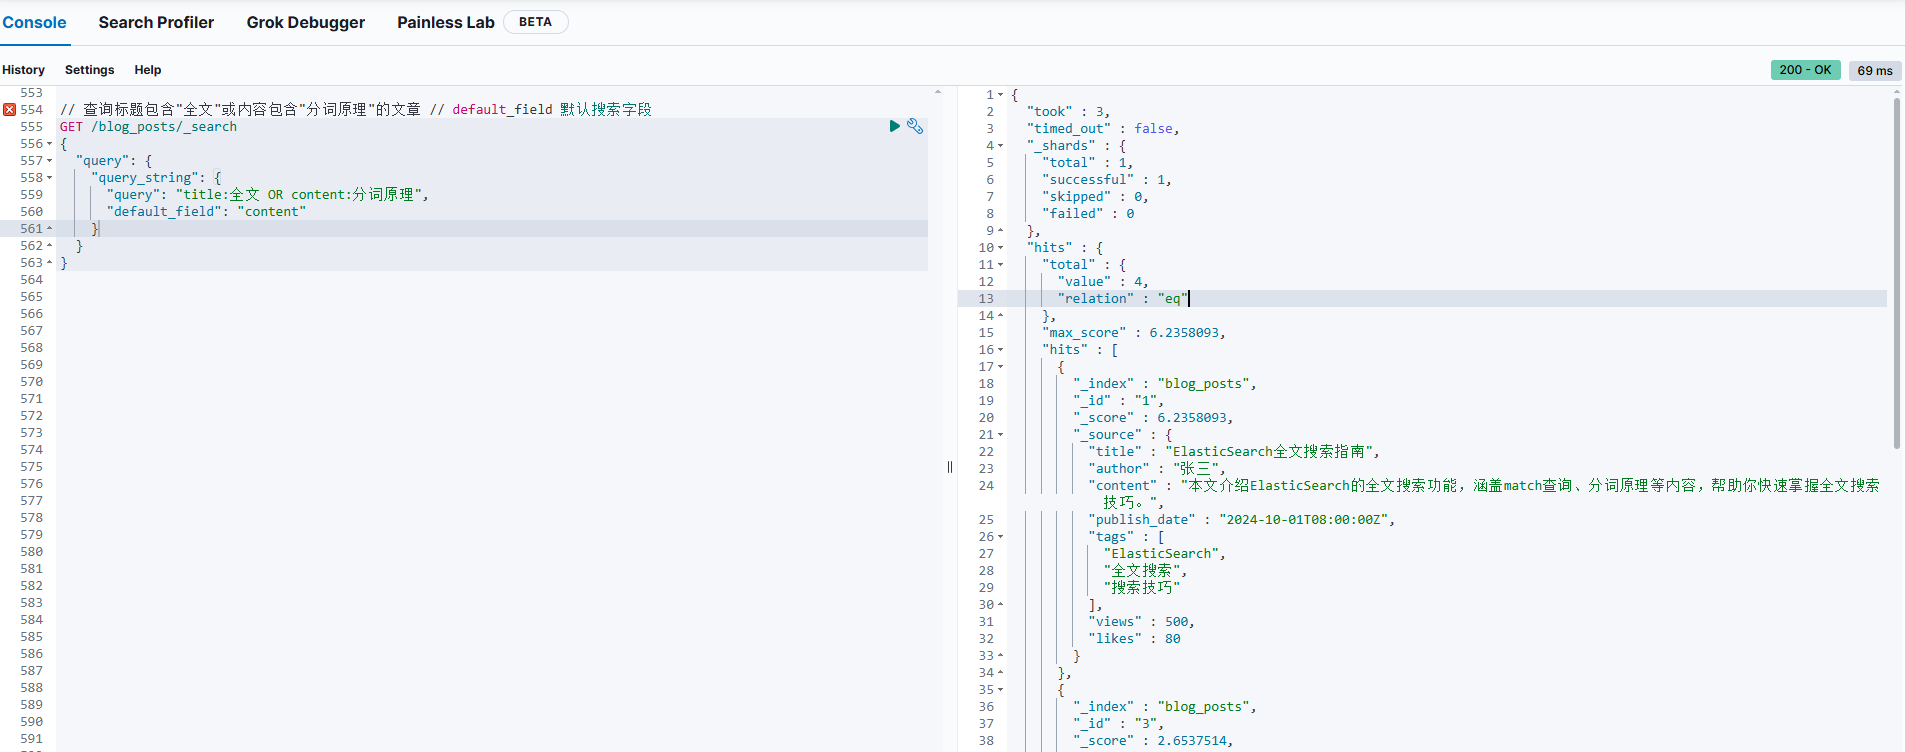
查询标题包含"全文"或内容包含"分词原理"的文章 // default_field 默认搜索字段
// 查询标题包含"全文"或内容包含"分词原理"的文章 // default_field 默认搜索字段
GET /blog_posts/_search
{
  "query": {
    "query_string": {
      "query": "title:全文 OR content:分词原理",
      "default_field": "content"
    }
  }
}
支持的语法
布尔操作符:AND、OR、NOT(必须大写)
字段限定:field:value
通配符:*(多个字符)、?(单个字符)
正则表达式:/regexp/
范围查询:[start TO end]
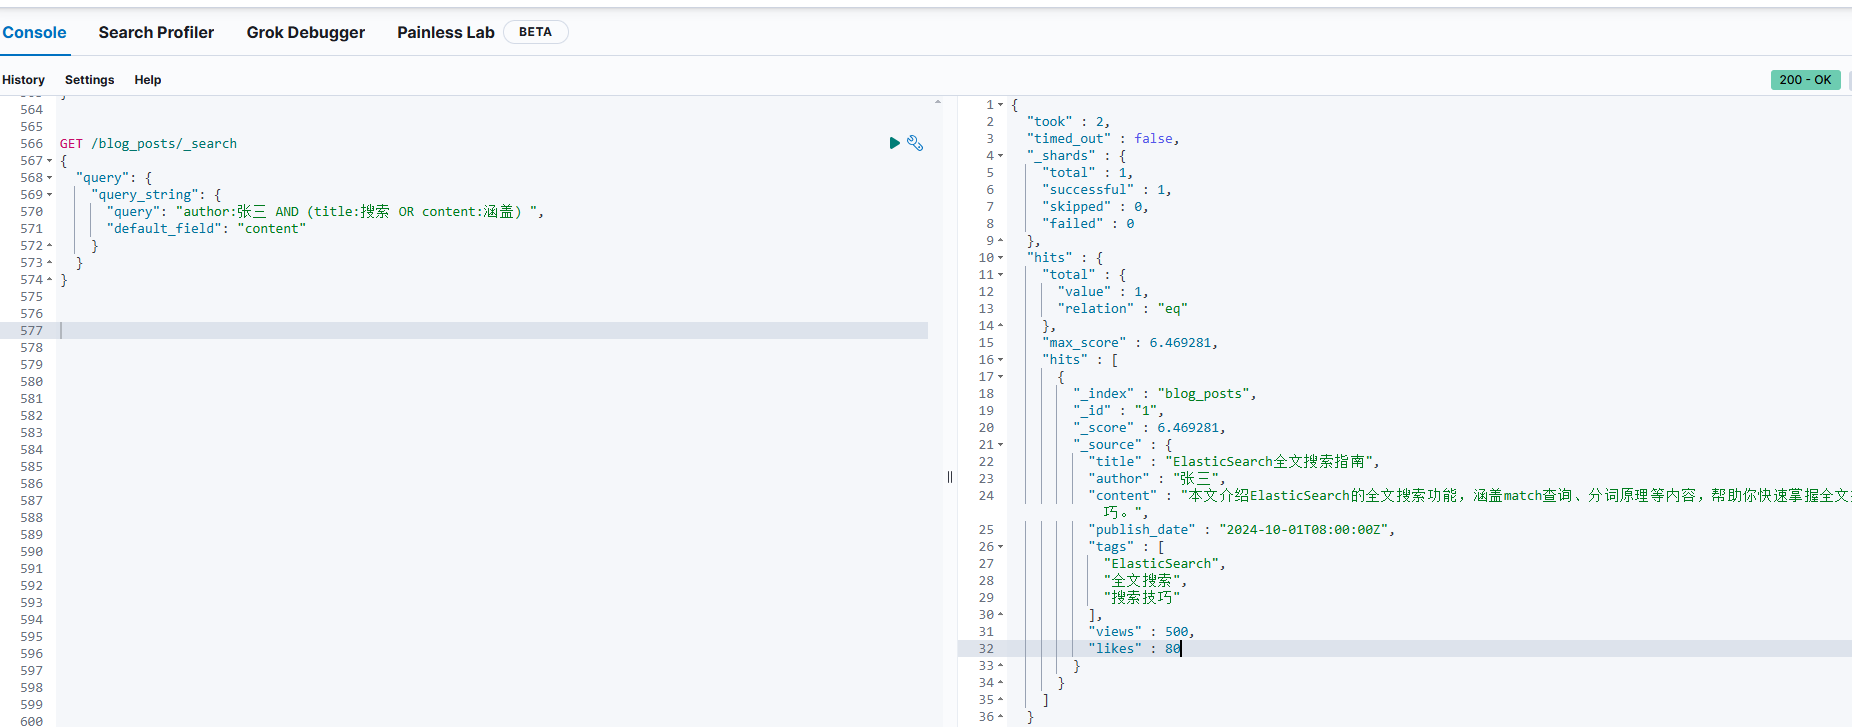
GET /blog_posts/_search
{
  "query": {
    "query_string": {
      "query": "author:张三 AND (title:搜索 OR content:涵盖) ",
      "default_field": "content"
    }
  }
}
simple_query_string 查询
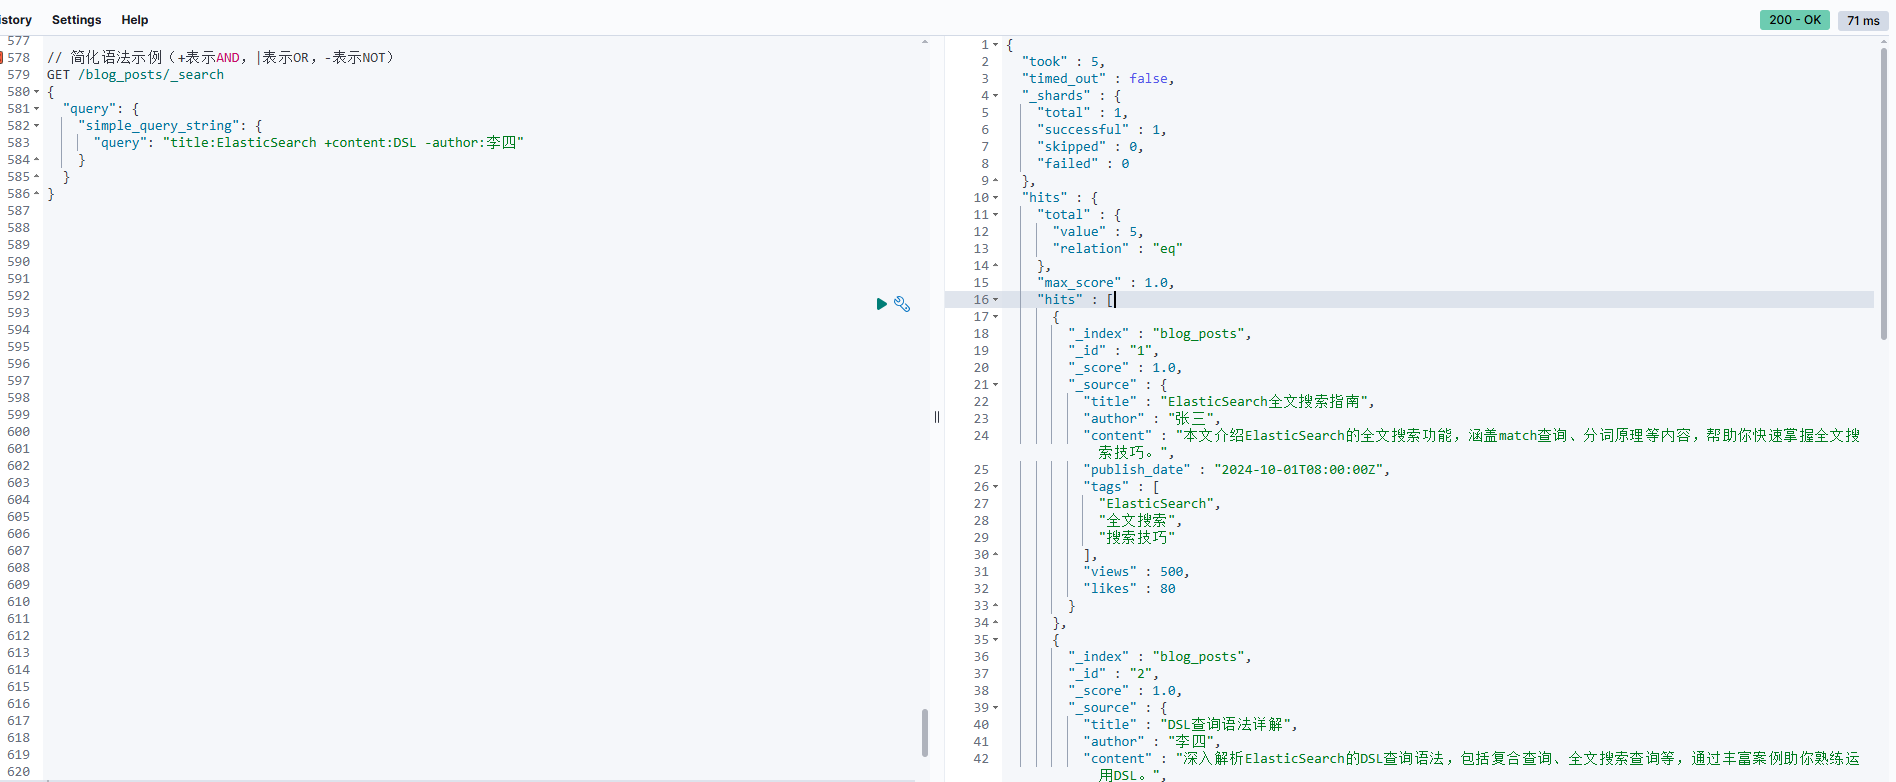
simple_query_string是query_string的简化版,语法更简单,且不会因语法错误导致查询失败:
// 简化语法示例(+表示AND,|表示OR,-表示NOT)
GET /blog_posts/_search
{
  "query": {
    "simple_query_string": {
      "query": "title:ElasticSearch +content:DSL -author:李四"
    }
  }
}
性能优化建议
避免使用 query_string:除非用户需要输入复杂语法,否则优先使用match系列查询,性能更优
合理设置分词器:根据语言特点选择合适的分词器(如中文推荐使用 IK 分词器)
利用 filter 缓存:将不影响分数的查询条件放入bool/filter中
控制结果集大小:使用size和from参数分页,或通过terminate_after提前终止
启用查询分析:通过explain=true分析查询性能瓶颈
基于官网ES8.18特性聊聊
1.1 语义搜索增强
ES 8.18 进一步优化了 semantic_text 字段类型,支持与 inference 管道结合使用,实现基于深度学习的语义匹配。例如,通过部署 ELSER 模型(Elastic Learned Sparse Encoder),可以将文本转换为语义向量,使 "人工智能" 和 "AI" 这类近义词获得更高的相关性得分:
PUT /articles
{
  "mappings": {
    "properties": {
      "content": {
        "type": "semantic_text",
        "model_id": "elser-v1"
      }
    }
  }
}
1.2 分词器性能优化
新版本对中文分词器(如 ik_max_word)的内存占用和分词速度进行了优化,在处理大规模文本时性能提升约 30%。可以通过以下方式测试分词效果:
GET /_analyze
{
  "tokenizer": "ik_max_word",
  "text": "ElasticSearch 8.18 全文搜索新特性"
}
1.3 查询规则(Query Rules)增强
ES 8.18 扩展了查询规则的条件表达式,支持更复杂的逻辑组合。例如,在电商场景中,可以根据用户行为动态调整搜索权重:
GET /products/_search
{
  "query_rules": [
    {
      "condition": {
        "match": {
          "category": "电子产品"
        }
      },
      "rule": {
        "function_score": {
          "query": {
            "match_all": {}
          },
          "functions": [
            {
              "field_value_factor": {
                "field": "sales",
                "modifier": "log1p"
              }
            }
          ]
        }
      },
      "priority": 10
    }
  ]
}
二、基础全文搜索查询实战
2.1 match 查询进阶用法
2.1.1 跨字段匹配(multi-match)
在 ES 8.18 中,multi-match 查询新增 best_fields 模式的优化算法,能更高效地处理多字段匹配:
GET /blog_posts/_search
{
  "query": {
    "multi_match": {
      "query": "ElasticSearch 性能优化",
      "fields": ["title", "content", "tags"],
      "type": "best_fields",
      "tie_breaker": 0.3  // ES 8.18 新增参数,控制次要字段的权重
    }
  }
}
2.1.2 模糊匹配优化
match 查询现在支持通过 fuzziness 参数更精细地控制模糊匹配程度,ES 8.18 对长文本的模糊计算进行了优化:
GET /users/_search
{
  "query": {
    "match": {
      "username": {
        "query": "johndoe",
        "fuzziness": "AUTO"  // ES 8.18 支持 AUTO 模式自动调整模糊度
      }
    }
  }
}
2.2 match_phrase 短语搜索增强
2.2.1 间隔查询(interval_query)
ES 8.18 新增 interval_query 用于精确控制词项位置关系,比传统 match_phrase 更灵活:
GET /news/_search
{
  "query": {
    "interval_query": {
      "content": {
        "match": {
          "phrase": {
            "slop": 2,
            "seq": [
              { "term": "人工智能" },
              { "term": "应用" }
            ]
          }
        }
      }
    }
  }
}
2.2.2 前缀短语搜索
match_phrase_prefix 查询新增 max_expansions 参数的默认值优化(从 50 提升至 100),更适合自动补全场景:
GET /products/_search
{
  "query": {
    "match_phrase_prefix": {
      "title": {
        "query": "apple",
        "max_expansions": 100
      }
    }
  }
}
复杂查询场景与性能优化
3.1 混合查询:语义搜索 + 传统搜索
ES 8.18 支持将语义搜索与传统全文搜索结合,通过 function_score 调整权重:
GET /documents/_search
{
  "query": {
    "function_score": {
      "query": {
        "bool": {
          "must": [
            {
              "semantic": {  // 语义搜索部分
                "field": "content",
                "query": "机器学习原理"
              }
            },
            {
              "match": {  // 传统搜索部分
                "title": "机器学习"
              }
            }
          ]
        }
      },
      "functions": [
        {
          "weight": 3  // 语义搜索权重更高
        }
      ]
    }
  }
}
3.2 性能优化最佳实践
3.2.1 字段数据缓存优化
ES 8.18 新增 field_data.cache.size 动态调整参数,可以通过以下命令优化高频查询字段:
PUT /_cluster/settings
{
  "persistent": {
    "field_data.cache.size": "30%",
    "field_data.cache.expire": "12h"
  }
}
3.2.2 查询分析与优化
使用 profile API 分析查询性能,ES 8.18 对分析结果进行了可视化优化:
GET /blog_posts/_search
{
  "query": {
    "match": {
      "content": "分布式搜索"
    }
  },
  "profile": true
}
3.3 大规模文本处理方案
3.3.1 分片查询优化
对于大规模索引,ES 8.18 优化了分片查询的协调机制,减少跨节点通信开销。建议根据数据量设置分片数:
PUT /large_text_index
{
  "settings": {
    "number_of_shards": 12,
    "number_of_replicas": 2,
    "index.query.bool.max_clause_count": 10000  // 处理复杂查询时增大此值
  }
}
官网资源与版本兼容性说明
从旧版本升级到 8.18 时,需注意:
match_phrase查询的slop参数默认行为略有调整,建议通过explain验证得分语义搜索相关功能(如
semantic_text)需要 X-Pack 许可证分词器配置文件格式有细微变化,需检查自定义分词器配置
评论区