




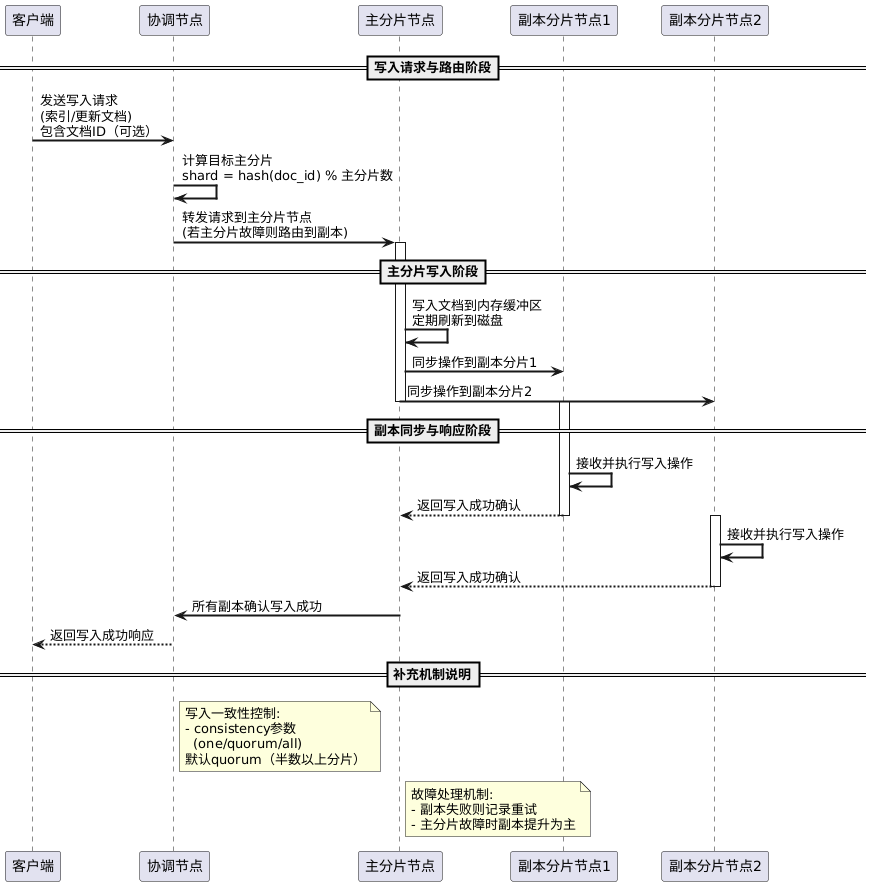
首先为了方便理解,我画了一个潦草的时序图,方便大家理解,不要纠结细节,意思到了就行。
剖析 Elasticsearch 数据落地的底层逻辑
一、请求启程:客户端与协调节点的协作
本篇我们还是用如图由3个节点组成的 ES 集群,节点1、节点2、节点3,每个节点上都分布着主分片和副本分片(具体分片数可配置,这里为方便理解,简化场景)。当你在客户端执行写入操作(比如新增一篇文档),流程第一步就是写入请求路由 。客户端先把请求发给协调节点(比如节点1 ,协调节点也可动态选举,这里假设固定节点1承担),要是操作带了文档 ID ,协调节点会用哈希算法算出该文档该去哪个主分片(公式大概是 shard = hash(doc_id) % 主分片数 )。这就像给快递分拨,每个文档都有专属“目的地”,要是主分片刚好故障,请求还能临时换路线,发给副本分片救急 。
二、主分片内存暂存与同步
到了主分片写入环节 ,假设计算出目标主分片在节点2上。主分片节点(节点2)先把文档丢进内存缓冲区——内存读写快,先让数据“暂住”这儿。不过 ES 会定时“打扫”缓冲区,把数据刷到磁盘的“段(segment)”里,这样数据就能被搜索到了。但主分片不搞“独苗苗”,它会赶紧把写入操作同步给副本分片(假设副本分片在节点3上 ),让副本也存一份,相当于给数据“做备份”。
三、副本响应:多节点的确认
副本分片(节点3)收到主分片(节点2)的同步请求后,会执行写入,完了给主分片回个“收到”的确认。这时候要看 ES 配置的一致性策略(比如默认的 quorum ,就是半数以上分片确认成功才算写入成 功)。因为集群有3个节点涉及分片(主+副本等情况,具体按实际分片数算,这里简单理解为满足多数确认) 不通版本可能有差异,8.x及之前的版本都是这样。等主分片(节点2)集齐足够多的确认,就会告诉协调节点(节点1)“成了”,协调节点再反馈给客户端,这时候你就知道数据写入成功啦。
四、兜底机制
要是同步过程中出问题咋办?别慌,ES 有故障处理 :副本同步失败会自动重试;要是主分片(节点2)挂了,副本分片(节点3)会直接“升级”成主分片,继续干活。就像团队里有人临时请假,其他人顶上,保证服务不断档。
其实 ES 写入流程,就是一群节点互相配合的“协作大戏”:协调节点(节点1)当“调度员”,主分片(节点2)和副本分片(节点3)当“存储员”,通过内存暂存、磁盘持久化、多副本同步,再加上故障时的自动切换,确保数据又快又稳地“安家”。弄懂这些,不管是优化 ES 写入性能(比如调整内存刷盘频率),还是排查写入故障,心里都能更有数。
你在使用 ES 时,遇到过写入相关的问题吗?比如写入慢、偶尔失败,欢迎评论区聊聊,咱们一起找解决办法~(本文基于通用流程,不同 ES 版本细节可能有差异,实际以所用版本为准哈)
评论区