




我画了一个简单的草图,来描述 ElasticSearch的持久化过程。我们一共分为了4个阶段 write -> refresh -> flush -> merge,
理解这些阶段,就能明白 为什么 ES 如何在 “写入速度”“可搜索性”“数据可靠性”“存储效率” 之间找平衡。比如,调整 Refresh 间隔可以 trade-off 实时性和写入性能;监控 Translog 大小能预防 Flush 延迟导致的风险。
在实际运维中,这些阶段的参数配置、状态监控,直接影响集群的稳定性和性能。下次遇到 ES 数据持久化相关问题(如数据延迟可见、磁盘 IO 过高 ),不妨从这几个阶段入手排查。
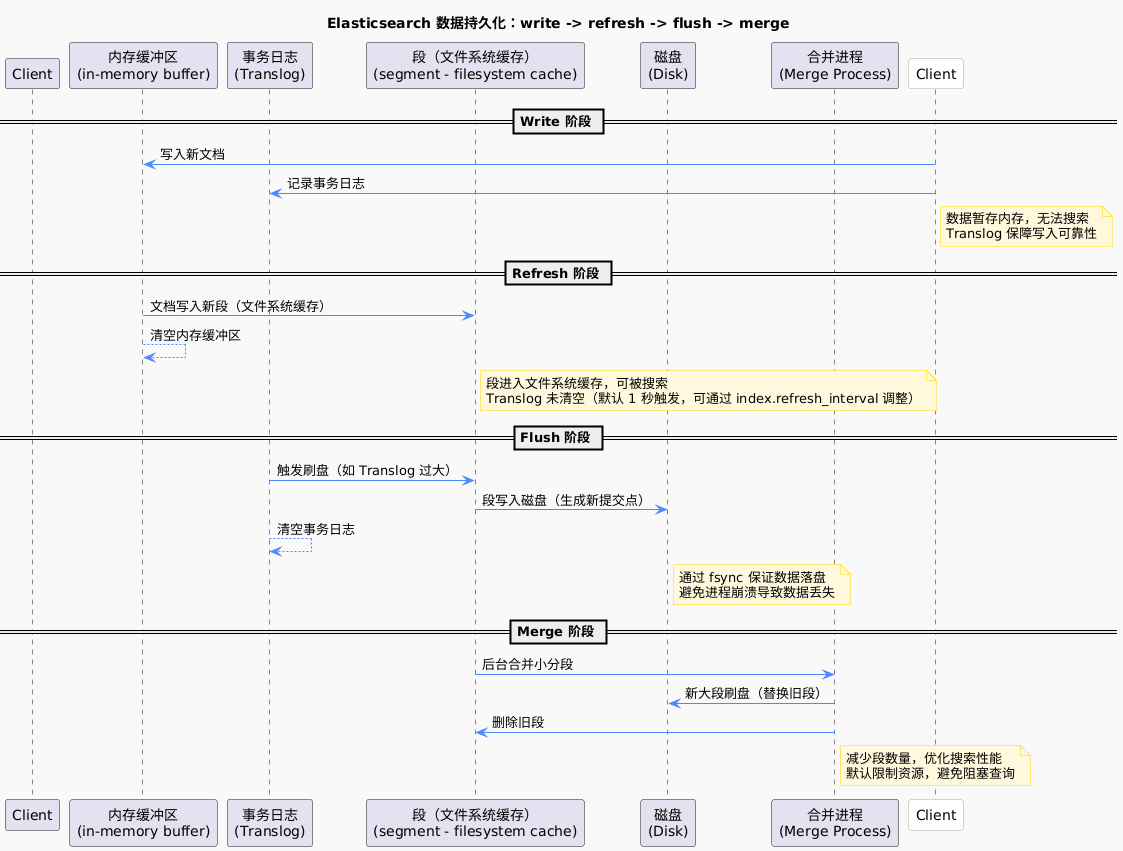
一、Write 阶段数据的暂存
当客户端写入新文档,ES 首先进入 Write 阶段 :
内存缓冲区暂存:文档先被写入 内存缓冲区(in-memory buffer) ,这是数据的 “临时停靠点”。内存操作速度快,能让写入更高效,但此时数据还未进入可搜索状态。
事务日志保障:同时,写入操作会记录到 事务日志(Translog) 。Translog 就像 “黑匣子”,即使 ES 进程意外崩溃,重启后也能通过它恢复未持久化的数据,保障写入的可靠性。这一步,数据虽 “暂存” 内存,但已有一层 “安全网” 兜底。
二、Refresh 阶段让数据 “可被搜索”
为了让写入的数据能被查询到,ES 会触发 Refresh 阶段 :
段的生成与缓存:内存缓冲区的数据会被写入到 文件系统缓存(segment - filesystem cache) ,形成新的 “段(segment)”。段进入文件系统缓存后,数据就具备了可搜索性。
(在此处不太理解的话,可以看我的入门篇ES的整体架构)
缓冲区清空:完成写入后,内存缓冲区会被清空,为下一轮写入腾出空间。值得注意的是,Refresh 默认 1 秒触发一次(可通过 index.refresh_interval 调整 ),此时 Translog 并未清空,仍保留着数据变更记录,继续保障可靠性。这一步,数据从 “不可搜索” 转为 “可搜索”,但还未真正持久化到磁盘。
三、Flush 阶段数据刷盘
虽然 Refresh 让数据可搜索,但要让数据真正 “稳固”,还需 Flush 阶段 :
触发条件:当 Translog 过大(或满足其他触发条件,如间隔时间到),ES 会触发 Flush。这是数据从缓存到磁盘的 “关键一跃”。
持久化到磁盘:文件系统缓存中的段会被写入 磁盘(Disk) ,生成新的 “提交点”,标志数据正式持久化。同时,Translog 会被清空,完成一轮 “写入 - 持久化” 的闭环。通过 fsync 机制,ES 确保数据真正落盘,避免进程崩溃导致数据丢失。这一步,数据才算真正 “扎根”,可靠性拉满。
四、Merge 阶段:优化存储的 “幕后工程”
随着写入不断进行,段的数量会越来越多,影响搜索性能。于是,ES 会在 Merge 阶段 进行 “幕后优化”:
合并小分段:后台进程会将多个小分段合并成 大分段 ,并写入磁盘。合并后,新的大分段会替换旧分段,旧分段被删除。
性能优化:减少段的数量,能降低搜索时需要扫描的文件数,提升搜索效率。不过,Merge 过程会占用磁盘 IO 和 CPU,ES 默认会限制其资源使用,避免影响查询性能。这一步,是 ES 对存储的 “自我优化”,让数据存储更高效。
五、思考题
有同学反馈说,ES服务端什么时候在哪个过程给客户端响应写入成功呢
其实客户端收到写入成功响应的阶段是在 Write 阶段完成事务日志(Translog)记录之后。为什么ES是这样设计呢。
先说答案,再说我们的思考。
ES 向客户端返回写入成功响应的时机是在 Write 阶段完成 Translog 持久化后,此时数据已被“安全记录”,但尚未进入可搜索或持久化状态。后续阶段(Refresh、Flush、Merge)均为后台异步处理,不影响客户端的写入响应流程,这一设计实现了写入性能、可靠性与可搜索性的平衡。
1. 写入成功响应的触发点:Write 阶段的 Translog 落盘
当客户端执行文档写入操作时,ES 的处理流程及响应时机如下:
内存缓冲区暂存:文档先写入内存缓冲区,此时数据尚未持久化,客户端未收到响应。
事务日志(Translog)记录:写入操作同时记录到 Translog,ES 会根据配置决定是否等待 Translog 落盘(通过
fsync操作)。若配置为
request级别(默认),则 Translog 落盘后,ES 立即向客户端返回 写入成功响应。若配置为
async或periodic,则可能在 Translog 异步落盘或周期性刷新时返回响应(但这种情况可能增加数据丢失风险)。
关键点:客户端收到写入成功响应时,数据仅暂存于内存缓冲区和 Translog,尚未经过 Refresh、Flush 或 Merge 阶段。此时数据已具备可靠性保障(Translog 可恢复),但尚未进入可搜索状态(需等待 Refresh)或持久化到磁盘(需等待 Flush)。
二、各阶段与数据状态的关系
三、为什么响应在 Write 阶段?
ES 设计上优先保证写入性能与可靠性的平衡:
性能角度:若等待数据可搜索(Refresh)或持久化(Flush)后再响应,会显著增加写入延迟,影响客户端体验。
可靠性角度:Translog 落盘后,即使 ES 崩溃,重启时也能通过 Translog 恢复数据,因此此时响应“写入成功”是安全的。
可搜索性权衡:数据可搜索需等待 Refresh(默认 1 秒),这是 ES 在“实时性”与“性能”间的妥协(可通过调整
refresh_interval优化)。
四、配置建议:平衡可靠性与性能
Translog 持久化策略(通过
index.translog.durability配置):request(默认):每次写入都等待 Translog 落盘,可靠性最高,适合金融等不能丢数据的场景。async:写入后不等待 Translog 落盘,性能最佳,但可能丢失最后一次异步落盘前的数据。periodic:每隔一段时间(由index.translog.sync_interval控制)落盘,折中方案。
Refresh 间隔调整:
若需要更高实时性,可缩短
refresh_interval(如设为 0.5 秒),但会增加 CPU 和 IO 开销。若写入量极大且对实时性要求不高,可延长间隔(如设为 30 秒),减少 Refresh 频率。
你在使用 ES 时,遇到过哪些与持久化相关的 “坑”?是写入后数据延迟搜索到,还是 Merge 过程引发性能波动?欢迎在评论区分享,一起聊聊 ES 持久化的那些事儿~(不同 ES 版本流程细节可能有差异,实际以所用版本为准哦)
评论区