




上次有个章节写完了,ES的持久化机制,主要分为4个步骤,【write->refresh->flush->merge】。其中在讲到write阶段的时候,出现了一个translog文件,translog 文件主要是记录数据写入的时候的事务操作。最后在flush阶段数据落盘后,将translog清空。 有同学问,translog是如何管理的呢,生成在哪里,我们这个章节,通过ES的部署的数据目录查看剖析一下
结合官网的文档 https://www.elastic.co/docs/reference/elasticsearch/index-settings/translog。
还是和之前风格一致能引用 官方文档的尽量引用官方文档。
在学习之前,我们先来自己安装的ES 的数据存储目录下看下都有哪些数据
一、存储目录剖析
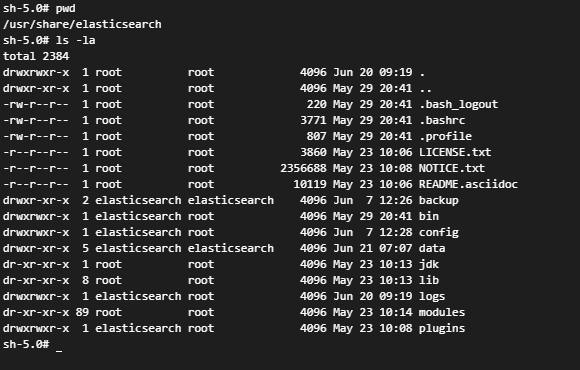
进入到data目录执行 tree命令
输出结果如下
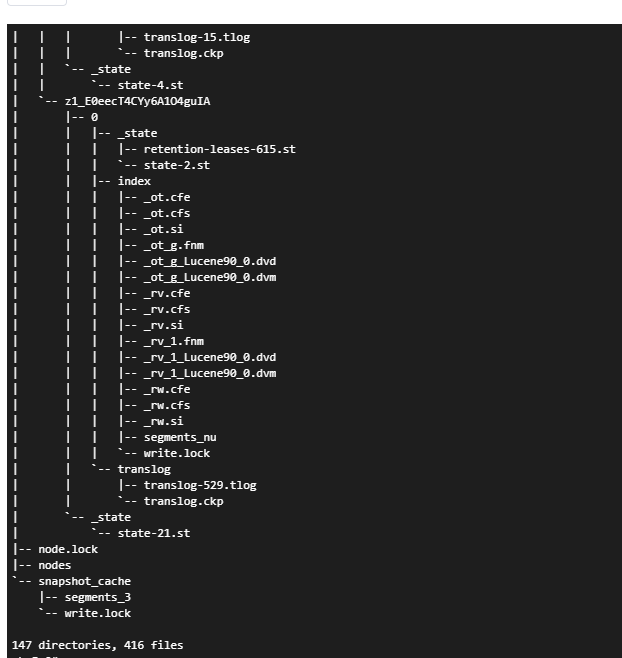
如果没有tree命令可以执行安装一个
/usr/share/elasticsearch/data/indices
/usr/share/elasticsearch/data/
├── indices
│   └── 5a6b7c8d9e0f1a2b3c4d5e6f  # 商品信息索引的UUID示例
│       ├── 0  # 分片0
│       │   ├── _state
│       │   │   └── state.json  # 存储分片0的状态信息
│       │   ├── segments_1  # 段文件,存储实际索引数据,数字代表版本
│       │   ├── segments_2
│       │   ├── translog
│       │   │   ├── translog-1  # translog文件,记录分片0的写入操作
│       │   │   └── translog-2
│       │   └── _commit  # 提交点文件目录
│       │       └── current  # 当前提交点文件,记录已持久化的段
│       ├── 1  # 分片1
│       │   ├── _state
│       │   │   └── state.json  # 存储分片1的状态信息
│       │   ├── segments_3
│       │   ├── segments_4
│       │   ├── translog
│       │   │   ├── translog-3
│       │   │   └── translog-4
│       │   └── _commit
│       │       └── current
│       └── _state
│           └── state.json  # 存储整个索引的状态信息
├── node.lock  # 确保单节点实例使用data目录的锁文件
├── nodes  # 记录节点相关信息的文件
└── snapshot_cache  # 快照缓存目录
不同版本的 Elasticsearch 在存储结构和机制上可能存在细微差异。某些旧版本或者特殊定制版本的 ES,可能在目录结构展示上有所不同,甚至可能将提交点相关信息以其他形式或位置存储。例如,早期版本的 ES 在文件命名和目录组织上与最新版本有所区别,新版本提交点信息并非存放在独立的
commit目录下。
随便找个索引可以看到最后
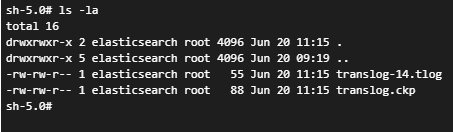
通过上面对 Elasticsearch 存储目录的拆分,大家大概能够了解到了ES的存储结构。
好接下来我们聊聊 整个data目录是 Elasticsearch 存储数据的核心位置,其中indices、node.lock、nodes和snapshot_cache各司其职,共同构建起数据存储的完整体系。
二、indices 目录:索引数据的 “大本营”
indices目录存放着 Elasticsearch 中所有索引的数据,每个索引以其唯一的 UUID 作为子目录名称(如5a6b7c8d9e0f1a2b3c4d5e6f),在这个示例中代表商品信息索引。每个索引 UUID 目录下又包含多个分片目录(如0、1),这是因为 Elasticsearch 通过分片机制将大索引拆分为多个小块,以提升数据处理和查询的效率。
2.1 分片目录:数据存储的基本单元
每个分片目录(如0、1)都是一个独立的数据存储单元,内部包含多个关键子目录和文件:
_state 子目录:其中的state.json文件记录着分片的详细状态信息,例如分片是否为主分片、副本分片,以及分片的当前状态(正常、异常等)。这些信息对于 Elasticsearch 集群管理分片的分配、故障转移至关重要。
段文件( segments_* ) :段是 Elasticsearch 存储实际索引数据的核心结构,文件名中的数字代表版本。段文件采用倒排索引结构,高效地组织数据,以支持快速的全文检索、聚合等操作。随着数据的写入和更新,新的段文件会不断生成,旧的段文件在合并后可能被删除。
translog 子目录:存放着该分片的事务日志文件(如translog-1、translog-2)。translog 记录了所有尚未持久化到磁盘的写入操作,是保障数据可靠性的关键。它采用预写日志(WAL)机制,确保即使在系统崩溃的情况下,也能通过回放 translog 恢复数据,避免数据丢失。
三、translog 详解(此处查找的资料比较少,我直接把官网文档翻译过来了)
Translog 设置
对Lucene的更改仅在Lucene提交时才会持久化到磁盘,而Lucene提交是一项相对开销较大的操作,因此无法在每次索引或删除操作后都执行。如果在一次提交后到下一次提交前发生了更改,那么在进程退出或硬件故障的情况下,这些更改会被Lucene从索引中移除。
由于对每次单独的更改都执行Lucene提交的开销过大,因此每个分片副本还会将操作写入其事务日志(即translog)。所有索引和删除操作在经过内部Lucene索引处理后、被确认之前,都会被写入translog。如果发生崩溃,在分片恢复时,那些已被确认但尚未包含在上一次Lucene提交中的近期操作将从translog中恢复。
Elasticsearch的Flush操作是执行Lucene提交并启动新的translog生成的过程。Flush会在后台自动执行,以确保translog不会变得过大,因为过大的translog会导致在恢复时重放其操作需要耗费大量时间。translog的大小永远不会超过磁盘大小的1%。虽然很少有必要,但也可以通过API手动执行Flush操作 。
Translog 设置
只有当translog被同步(fsynced)并提交时,translog中的数据才会持久化到磁盘。在发生硬件故障、操作系统崩溃、JVM崩溃或分片故障的情况下,自上次translog提交以来写入的任何数据都将丢失。
下面是重点
默认情况下,
index.translog.durability设置为request,这意味着只有在主分片和每个已分配的副本分片上的translog都成功同步并提交后,Elasticsearch才会向客户端报告索引、删除、更新或批量请求成功。如果将index.translog.durability设置为async,那么Elasticsearch只会每隔index.translog.sync_interval配置的时间间隔对translog进行同步和提交,这意味着在节点恢复时,在崩溃前执行的任何操作都可能会丢失。
以下是可动态更新的每个索引的设置,用于控制translog的行为:
index.translog.sync_interval:无论是否有写入操作,translog同步到磁盘并提交的频率。默认值为5秒。不允许设置小于100毫秒的值。
index.translog.durability:控制是否在每次索引、删除、更新或批量请求后对translog进行同步和提交。该设置接受以下参数:
request(默认值):每次请求后都进行同步和提交。在发生硬件故障的情况下,所有已确认的写入操作都已提交到磁盘。
async:每隔sync_interval在后台进行同步和提交。在发生故障的情况下,自上次自动提交以来的所有已确认写入操作都将被丢弃。
index.translog.flush_threshold_size:translog存储所有尚未安全持久化到Lucene中的操作(即不属于Lucene提交点的操作)。尽管这些操作可用于读取,但如果分片停止并需要恢复,就需要重放这些操作。此设置用于控制这些操作的最大总大小,以防止恢复过程耗时过长。一旦达到最大大小,就会执行一次Flush操作,生成一个新的Lucene提交点。默认值为10GB。
四、其他关键目录与文件
node.lock 文件:它的作用是确保同一时间只有一个 Elasticsearch 节点实例使用data目录。当节点启动时,会尝试创建该文件,如果文件已存在,说明有其他节点正在使用该目录,当前节点启动会失败,以此避免数据冲突和损坏。
nodes 文件:记录了 Elasticsearch 节点的相关信息,如节点的唯一标识、角色(主节点、数据节点等)、节点的配置等。这些信息在节点启动和集群成员管理中发挥着重要作用,帮助节点与其他节点进行通信和协作。
snapshot_cache 目录:用于缓存 Elasticsearch 的快照数据。快照是对索引数据的备份,缓存这些数据可以提高后续快照操作(如创建、恢复快照)的性能,减少数据读取和处理时间
评论区