




Elastic Stack生态全景解析与场景应用实践
Elastic Stack作为当前最流行的分布式数据处理平台,已从单纯的搜索工具发展为覆盖数据采集、处理、存储、分析和可视化的完整生态。本文将从生态组件、技术演进、最佳实践三个维度,带您全面认知Elastic Stack的能力边界与应用场景。
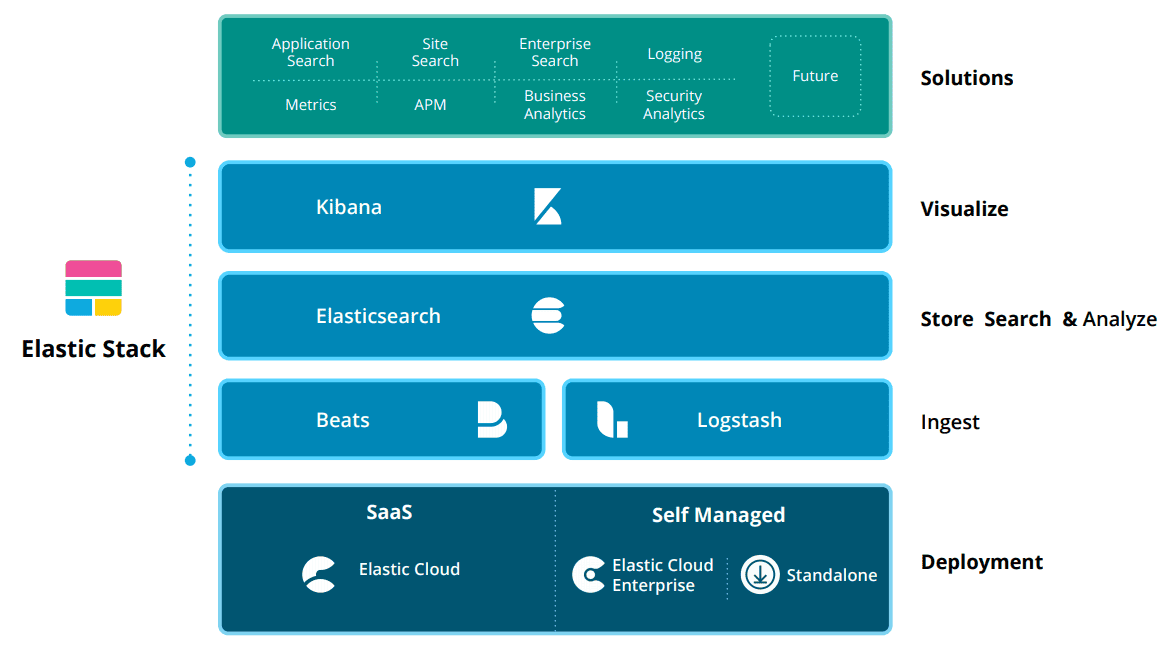
一、Elastic Stack核心生态组件揭秘
Elastic Stack的经典组合由四大核心组件构成,它们各司其职又紧密协同,形成数据处理的闭环体系。
1. Beats:轻量级数据采集先锋
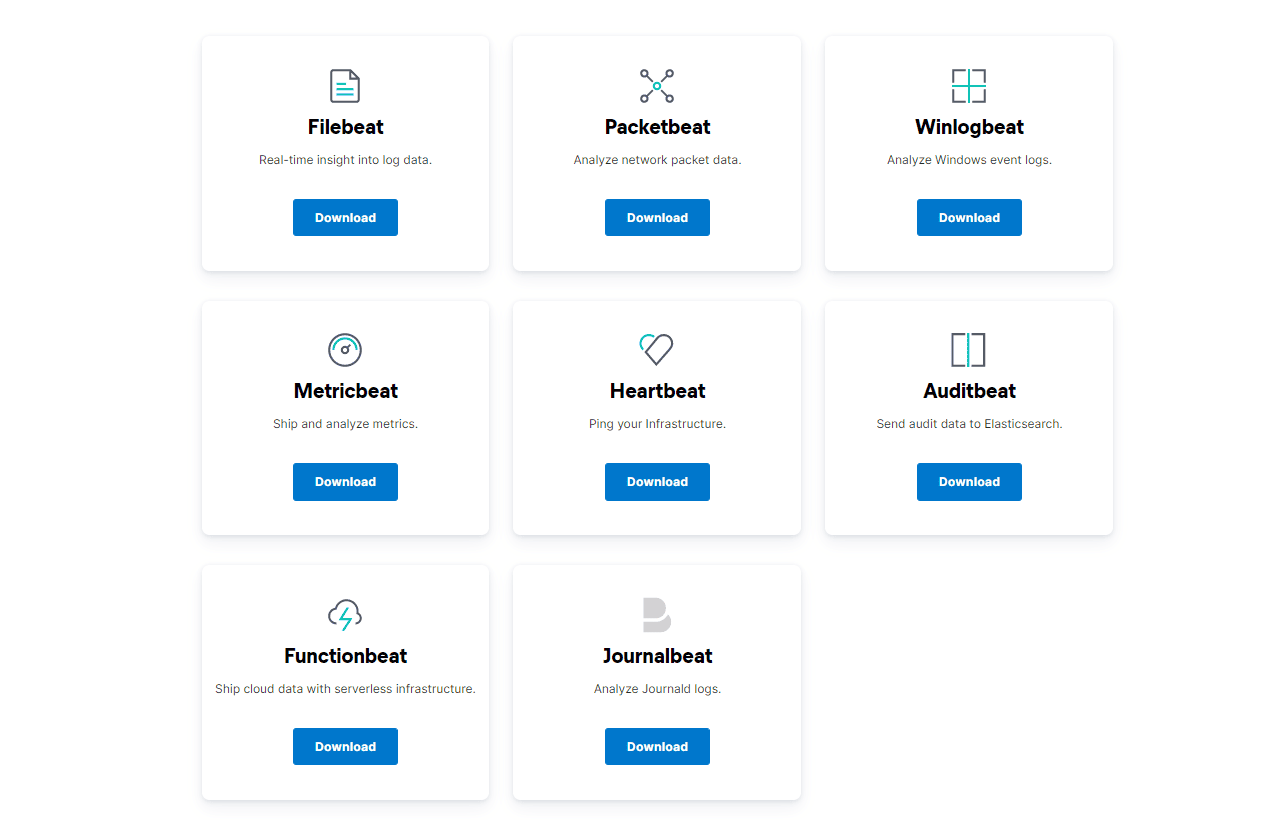
Beats是基于Go语言开发的轻量级采集器家族,以"低资源消耗、高稳定性"为设计核心,可从各类数据源实时采集数据并发送至Logstash或Elasticsearch。其家族成员包括:
Filebeat:日志文件采集器,替代传统的Logstash Forwarder
Metricbeat:系统与应用指标采集器,监控CPU、内存、磁盘等资源
Packetbeat:网络流量分析器,捕获并解析网络数据包
Winlogbeat:Windows事件日志采集器,兼容Windows生态
Heartbeat:服务可用性监控器,检测API或服务的响应状态
2. Logstash:数据处理的智能管道
Logstash作为动态数据收集管道,通过"输入-过滤-输出"的插件机制实现数据的复杂处理:
多源接入:支持从Beats、数据库、消息队列等50+数据源采集数据
智能转换:内置200+过滤器插件,可完成JSON解析、字段提取、数据脱敏等操作
可靠传输:通过持久化队列实现"至少一次交付",支持TLS加密传输
弹性扩展:基于JVM的架构可通过水平扩展应对流量波动
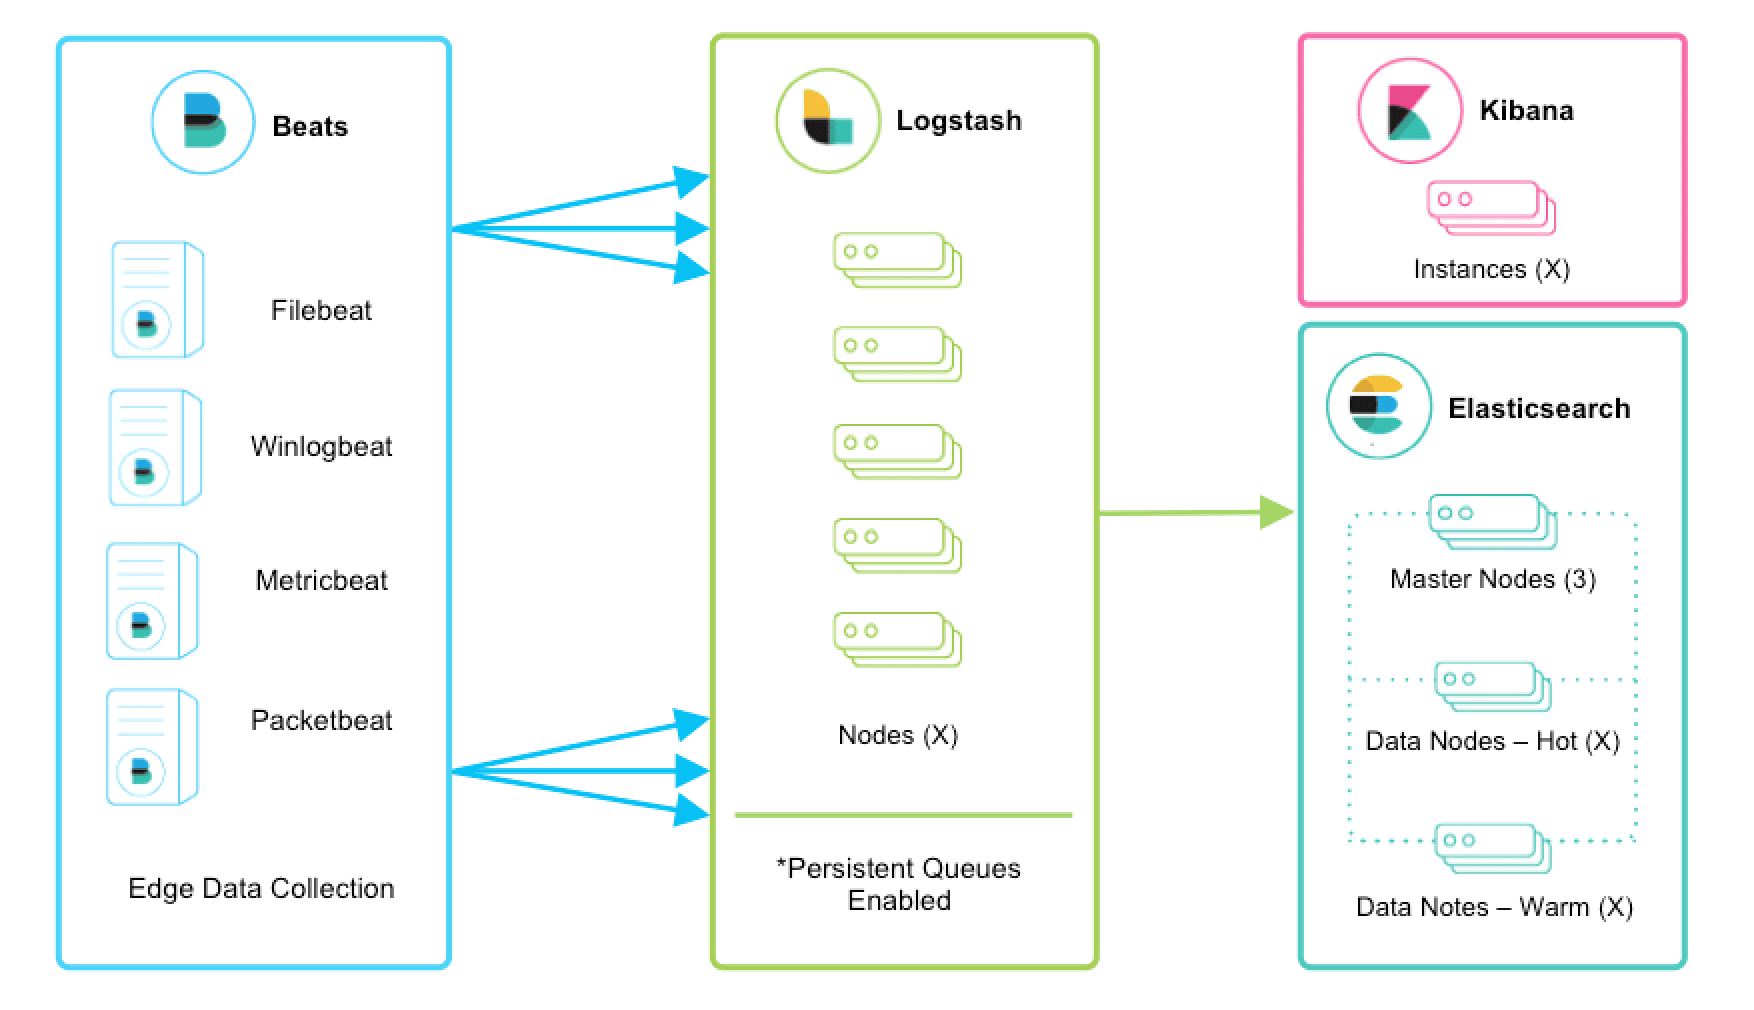
Logstash的部署和使用可以分为安装部署、配置文件编写、启动服务以及实际使用这几个主要步骤,以下是详细介绍:
安装部署
Logstash支持在多种操作系统上安装,以下以常见的Linux系统(CentOS 7为例)和Windows系统为例说明:
Linux系统(CentOS 7):
下载安装包:从Elastic官方网站下载对应版本的Logstash安装包,例如使用
wget命令下载:
wget https://artifacts.elastic.co/downloads/logstash/logstash-7.17.0.tar.gz
2. **解压安装包**:使用`tar`命令解压下载的安装包到指定目录,比如`/usr/share/`:
tar -zxvf logstash-7.17.0.tar.gz -C /usr/share/
3. **赋予权限**:进入解压后的目录,赋予Logstash可执行权限:
cd /usr/share/logstash-7.17.0
chmod +x bin/logstash
Windows系统:
下载安装包:在Elastic官网下载Windows版本的Logstash安装包(.zip格式)。
解压安装包:将下载的.zip文件解压到想要安装的目录,比如
C:\Program Files\logstash-7.17.0。
配置文件编写
Logstash通过配置文件来定义数据的输入、过滤和输出,配置文件通常以.conf为后缀,常见的配置如下:
简单日志采集并输出到Elasticsearch:
# 输入部分,监听5044端口接收Beats发送的数据
input {
    beats {
        port => 5044
    }
}
# 过滤部分,这里可以为空,不进行过滤操作
filter {
}
# 输出部分,将数据发送到本地的Elasticsearch
output {
    elasticsearch {
        hosts => ["localhost:9200"]
        index => "logstash-%{+YYYY.MM.dd}"
    }
}
上述配置表示从Beats接收数据,不进行过滤直接发送到本地运行在9200端口的Elasticsearch,索引命名格式为logstash-年.月.日 。
带有过滤操作(如解析JSON日志):
input {
    file {
        path => "/var/log/myapp/*.log"
        start_position => "beginning"
        sincedb_path => "/dev/null"
    }
}
filter {
    json {
        source => "message"
    }
}
output {
    elasticsearch {
        hosts => ["localhost:9200"]
        index => "myapp-logs-%{+YYYY.MM.dd}"
    }
}
该配置会读取/var/log/myapp/目录下的日志文件,将日志内容解析为JSON格式后,发送到本地Elasticsearch,索引名为myapp-logs-年.月.日 。
启动服务
Linux系统:在Logstash安装目录的
bin目录下,使用以下命令启动Logstash:
./bin/logstash -f path/to/your/config.conf
其中-f参数表示指定配置文件路径,运行后会在终端看到Logstash的启动日志,确认是否正常启动。
Windows系统:打开命令提示符,进入Logstash安装目录的
bin目录,运行以下命令:
logstash -f path/to/your/config.conf
同样,根据命令行输出的日志信息判断启动是否成功。
实际使用
数据采集:按照配置文件中输入部分的设定,Logstash会从指定的数据源采集数据。例如,当配置从文件采集时,确保文件路径正确且有读取权限;配置从Beats接收数据时,Beats端要正确配置并发送数据到Logstash指定端口。
数据过滤:如果配置了过滤插件,Logstash会对采集到的数据进行相应处理。比如使用
mutate插件修改字段内容,或者使用grok插件解析非结构化日志。可以通过在Elasticsearch中查看索引数据,来验证过滤操作是否符合预期。数据输出:处理后的数据会按照输出配置发送到目标位置。如果输出到Elasticsearch,可以在Kibana中创建可视化图表来分析这些数据;如果输出到文件,检查对应文件是否生成以及数据格式是否正确。
在实际使用过程中,可能还需要对Logstash进行监控,了解其运行状态(如CPU、内存使用情况,队列积压等),可以借助Elastic Stack中的Metricbeat等工具来实现。 同时,若出现问题,可以通过查看Logstash的日志文件(默认在安装目录的logs目录下)来排查错误原因。
3. Elasticsearch:分布式搜索与分析引擎
Elasticsearch作为生态核心,提供分布式存储与实时搜索能力:
分布式架构:自动分片与副本机制,支持PB级数据存储
实时搜索:基于倒排索引实现毫秒级检索,支持复杂聚合分析
多模态数据:原生支持文本、数值、地理空间、时序等数据类型
水平扩展:无需停机即可添加节点,集群规模可动态调整
4. Kibana:数据可视化与交互中枢
Kibana作为Elasticsearch的可视化前端,提供全方位的数据交互能力:
可视化仪表盘:支持折线图、柱状图、地图等20+可视化组件
探索与分析:通过Kibana Query Language (KQL) 进行交互式查询
机器学习功能:内置异常检测、预测分析等AI能力(需X-Pack)
应用集成:支持APM、Logs、Metrics等多场景应用界面
X-Pack:企业级功能扩展包
X-Pack作为Elastic的商业扩展包,为企业用户提供以下增强功能:
二、从日志系统演进看Elastic Stack的架构进化
Elastic Stack的能力迭代在日志收集系统的演进中体现得尤为明显,其架构发展经历了三个典型阶段。
1. 基础架构:Beats+Elasticsearch+Kibana
这是最简化的日志处理架构,适合中小规模场景:
Beats(日志采集) → Elasticsearch(存储检索) → Kibana(可视化)
优势:架构简单、部署快速,资源消耗低
场景:小型应用日志分析、临时测试环境
局限:缺乏复杂数据处理能力,不支持多源数据整合
2. 标准架构:Beats+Logstash+Elasticsearch+Kibana
引入Logstash后形成完整的数据处理管道:
Beats → Logstash(解析/过滤) → Elasticsearch → Kibana
核心改进:
数据处理能力:通过Logstash过滤器实现日志解析(如JSON、Nginx日志格式转换)
缓冲机制:基于磁盘的自适应缓冲系统应对流量峰值
多源支持:可同时接入数据库、消息队列等其他数据源
路由策略:支持按条件将不同日志路由至不同索引
3. 企业架构:Beats+MQ+Logstash+Elasticsearch+Kibana
在标准架构基础上引入消息队列(如Kafka、RabbitMQ):
Beats → MQ(缓冲) → Logstash集群 → Elasticsearch集群 → Kibana
企业级优势:
流量削峰:MQ缓冲应对日志突发流量,保护后端系统
解耦架构:采集层与处理层分离,支持独立扩展
数据持久化:MQ提供额外的数据持久化层,避免采集丢失
多租户支持:通过Topic隔离不同业务线日志,实现资源隔离
架构演进对比表
三、Elastic Stack最佳实践与场景方案
1. 日志收集系统深度实践
日志采集策略
采集节点部署:每50-100台应用服务器配置1个Beats采集节点
日志保留策略:按重要程度分级存储(核心日志保留180天,普通日志保留30天)
采集频率:关键业务日志实时采集,非核心日志可设置5-10秒采集间隔
性能优化要点
Logstash管道优化:
# 示例:优化JSON日志解析性能 filter { json { source => "message" add_error_tag => ["json_invalid"] skip_on_invalid_json => true } }Elasticsearch索引设计:
按天/按周创建索引,避免单索引过大
核心索引设置5主分片+1副本,非核心索引设置3主分片+0副本
使用ILM(索引生命周期管理)自动执行索引滚动与删除
2. Metric收集与APM性能监控
系统指标监控方案
采集层:Metricbeat采集服务器CPU、内存、磁盘IO等指标
存储层:Elasticsearch时序数据存储(TSDB)优化配置
# elasticsearch.yml 时序数据优化 index.codec: best_compression index.routing.allocation.total_shards_per_node: 3可视化层:Kibana内置的System Metrics仪表盘
应用性能监控(APM)
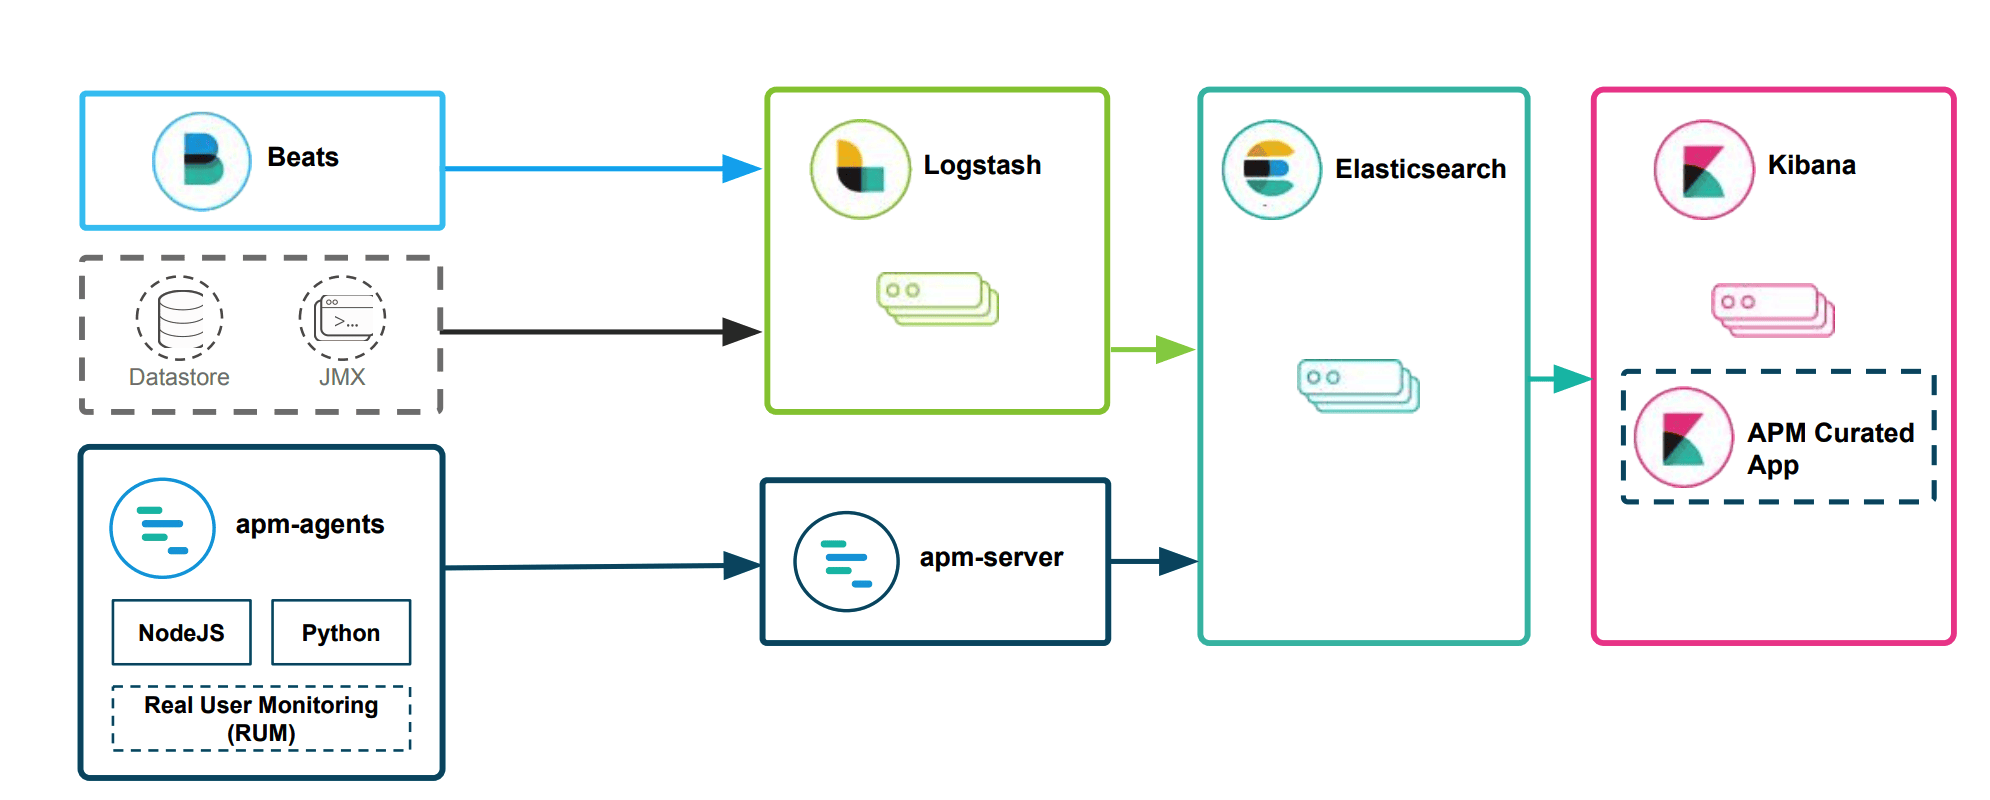
APM解决方案通过三端协同实现全链路追踪:
前端采集:RUM(Real User Monitoring)采集浏览器端性能数据
服务端探针:支持Java、Python、Node.js等12+语言的APM Agent
分布式追踪:基于OpenTelemetry协议实现跨服务调用链追踪
异常检测:通过机器学习自动识别响应时间突增、错误率升高等异常
3. 多数据中心高可用方案
双活数据中心架构
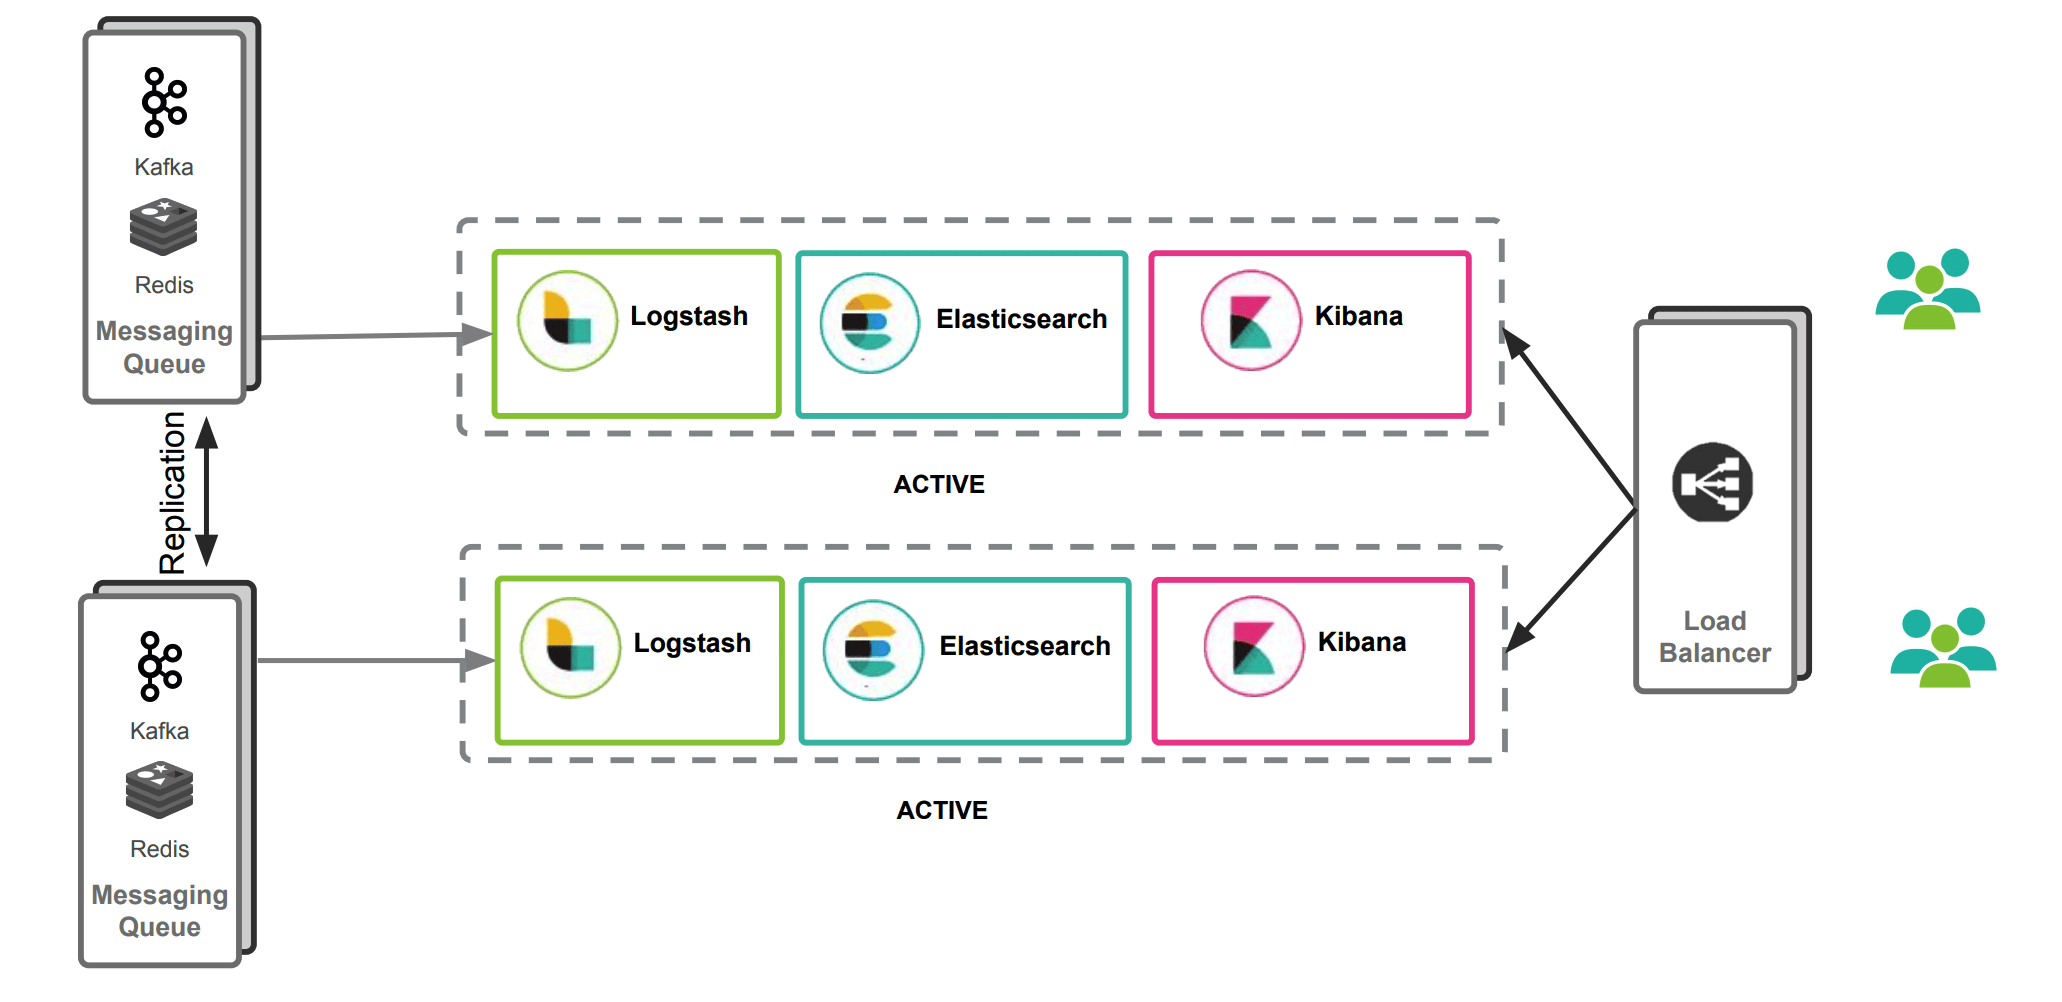
数据复制:通过Elasticsearch Cross Cluster Replication (CCR) 实现跨中心数据同步
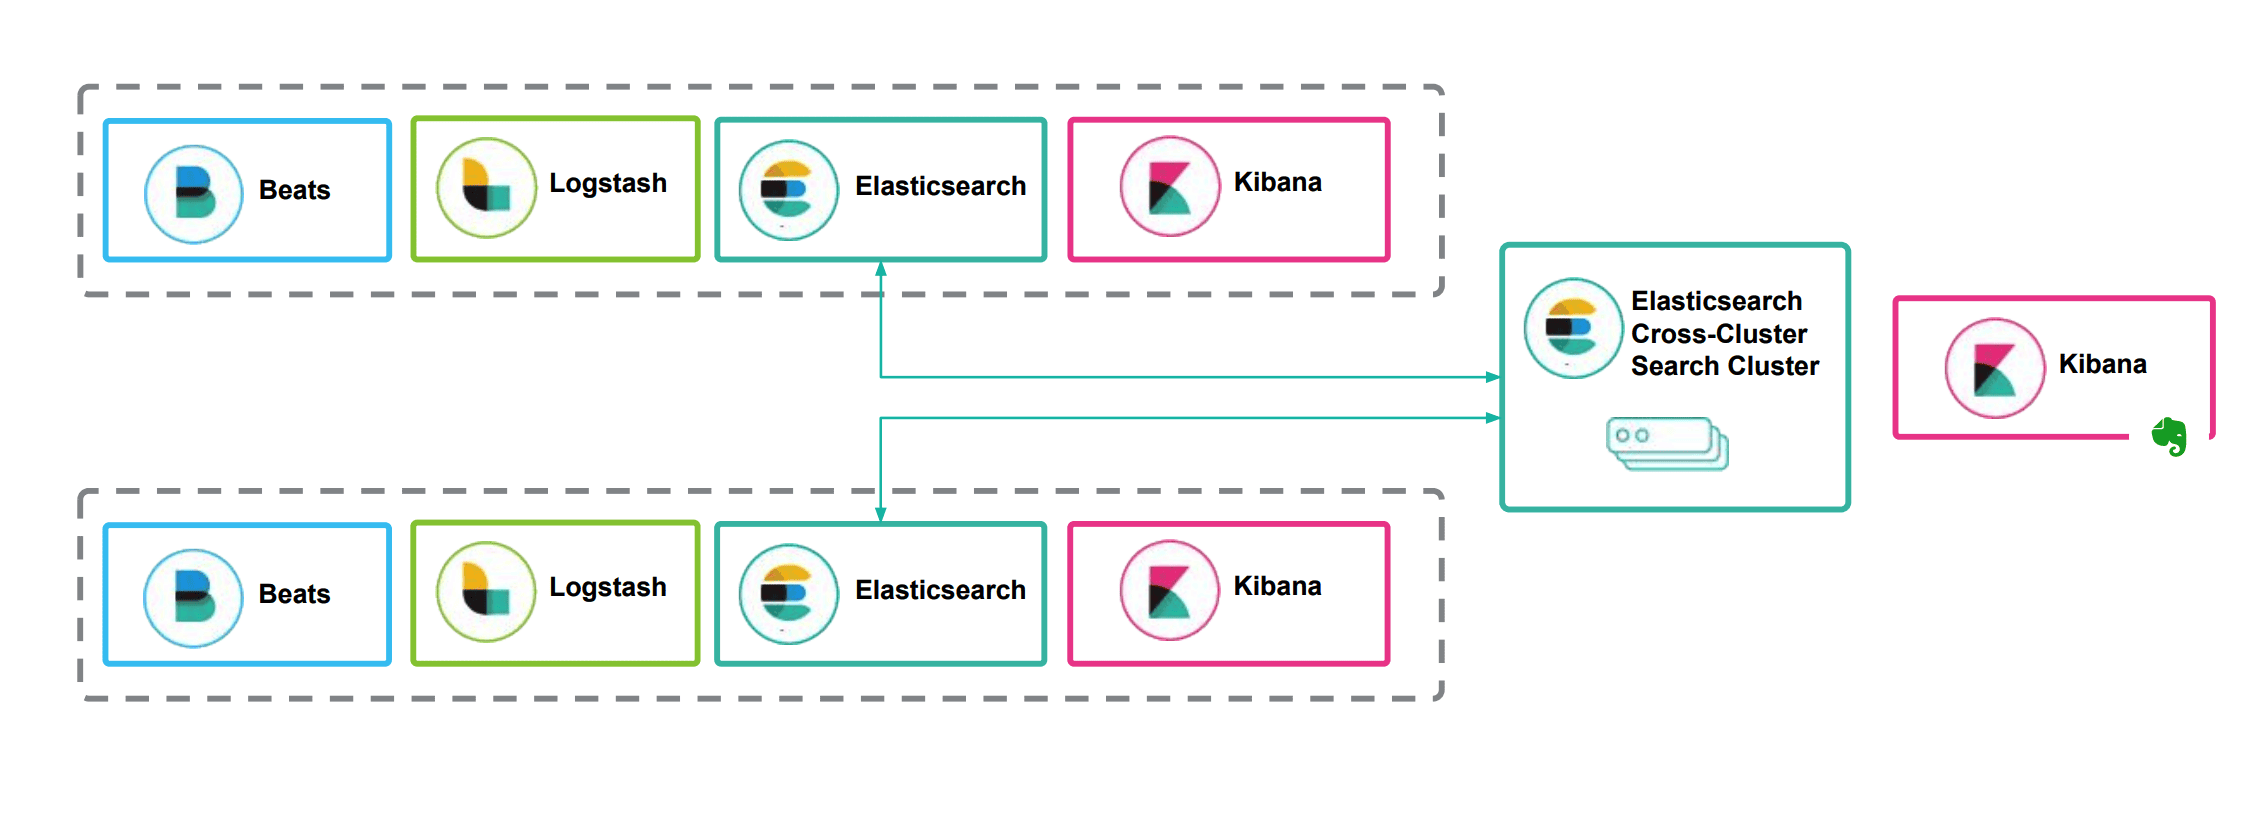
故障转移:利用ELK的客户端负载均衡能力,自动切换至可用数据中心
容灾策略:
跨数据中心距离建议<50ms网络延迟
每个数据中心至少部署3个Elasticsearch主节点
关键业务设置3副本,实现"两地三中心"容灾
多集群数据聚合方案
对于跨国企业或多分支机构场景:
边缘集群:各分支机构部署独立ELK集群,处理本地数据
中央集群:通过Logstash聚合各边缘集群数据,实现全局分析
查询优化:使用Elasticsearch Federation API实现跨集群查询
四、生态扩展与生态周边
Elastic Stack的开放性使其能够与众多技术栈集成:
容器生态:与Kubernetes深度集成,支持DaemonSet部署Beats,StatefulSet部署Elasticsearch
BI工具:Tableau、Power BI可直接连接Elasticsearch作为数据源
ETL工具:与Apache Flink、Spark Streaming集成实现实时数据处理
安全生态:与SIEM系统对接,实现安全事件分析与响应
评论区