




【原理篇】3. 聊聊 MySQL 的索引结构
在学习本篇文章之前建议大家可以参考一下这个文章
最近和同行交流技术面试经历,发现不少面试官爱问 “跳表和 B + 树有什么区别”。这个问题乍一听专业感拉满,可细究起来却藏着不少值得探讨的地方。正好借着这个话题,今天我就以一个开发者的视角,聊聊 MySQL 的索引结构,以及为什么说理解索引不能停留在 “数据结构对比” 的表面。
某些面试官在考察数据结构时,若仅仅将跳表与 B + 树做表面化对比,而忽略两者本质上的应用场景差异,这种提问方式可能暴露三大认知偏差,甚至让技术讨论陷入形式主义的误区对 “跳表与 B + 树对比”就是典型的脱离场景的 “伪对比”
B+树与跳表对比
将跳表与 B + 树强行放在同一维度对比,本质上是对 “存储介质决定数据结构设计” 这一核心原则的漠视。B + 树的每一个设计细节(如节点大小与磁盘块对齐、强制平衡的分裂合并机制),都是为了解决磁盘 I/O 的高延迟问题,其核心矛盾是 “用树高换 I/O 次数”;而跳表的随机层高、多层链表结构,完全服务于内存环境下的指针快速跳转,其设计哲学是 “用概率平衡换实现简洁”。
若面试官只关注 “两者都是分层索引” 的表面共性,却不问 “为何 B + 树需要节点分裂而跳表依赖随机数”“为何 Redis 不选 B + 树做 Sorted Set”,这种对比就像比较 “汽车轮胎与自行车轮胎的花纹差异”,却忽略两者服务于完全不同的交通工具 —— 看似在考察技术,实则暴露了对 “数据结构是场景解决方案” 这一本质的认知缺位。
第一次被问到跳表和 B + 树的区别时,我还真花了不少时间整理两者的异同:B + 树是多路平衡搜索树,跳表是基于概率的多层链表;一个为磁盘设计,一个适合内存环境…… 这些答案确实没错。
B + 树
B + 树的每个设计细节,都写满了对磁盘特性的妥协与对抗。还记得我第一次深入研究 InnoDB 存储引擎时,被它 4KB 的节点大小惊到了 —— 这和磁盘块的大小完美契合。这不是巧合,而是开发者们为了减少磁盘 I/O 次数做出的精心设计。在磁盘读写以毫秒计算的世界里,B + 树通过多叉树结构压缩树高,用强制平衡的分裂合并机制保证每次查询的 I/O 次数稳定在 O (log n)。
我曾参与过一个电商项目的数据库优化,当时有张订单表数据量突破了千万级。由于索引设计不合理,一次普通的范围查询都要花费好几秒。后来我们调整了索引结构,利用 B + 树叶节点链表的特性,将查询性能提升了数十倍。这个经历让我深刻体会到,B + 树的叶节点链表不仅仅是一个数据结构设计,更是为范围查询量身定制的 “高速公路”。
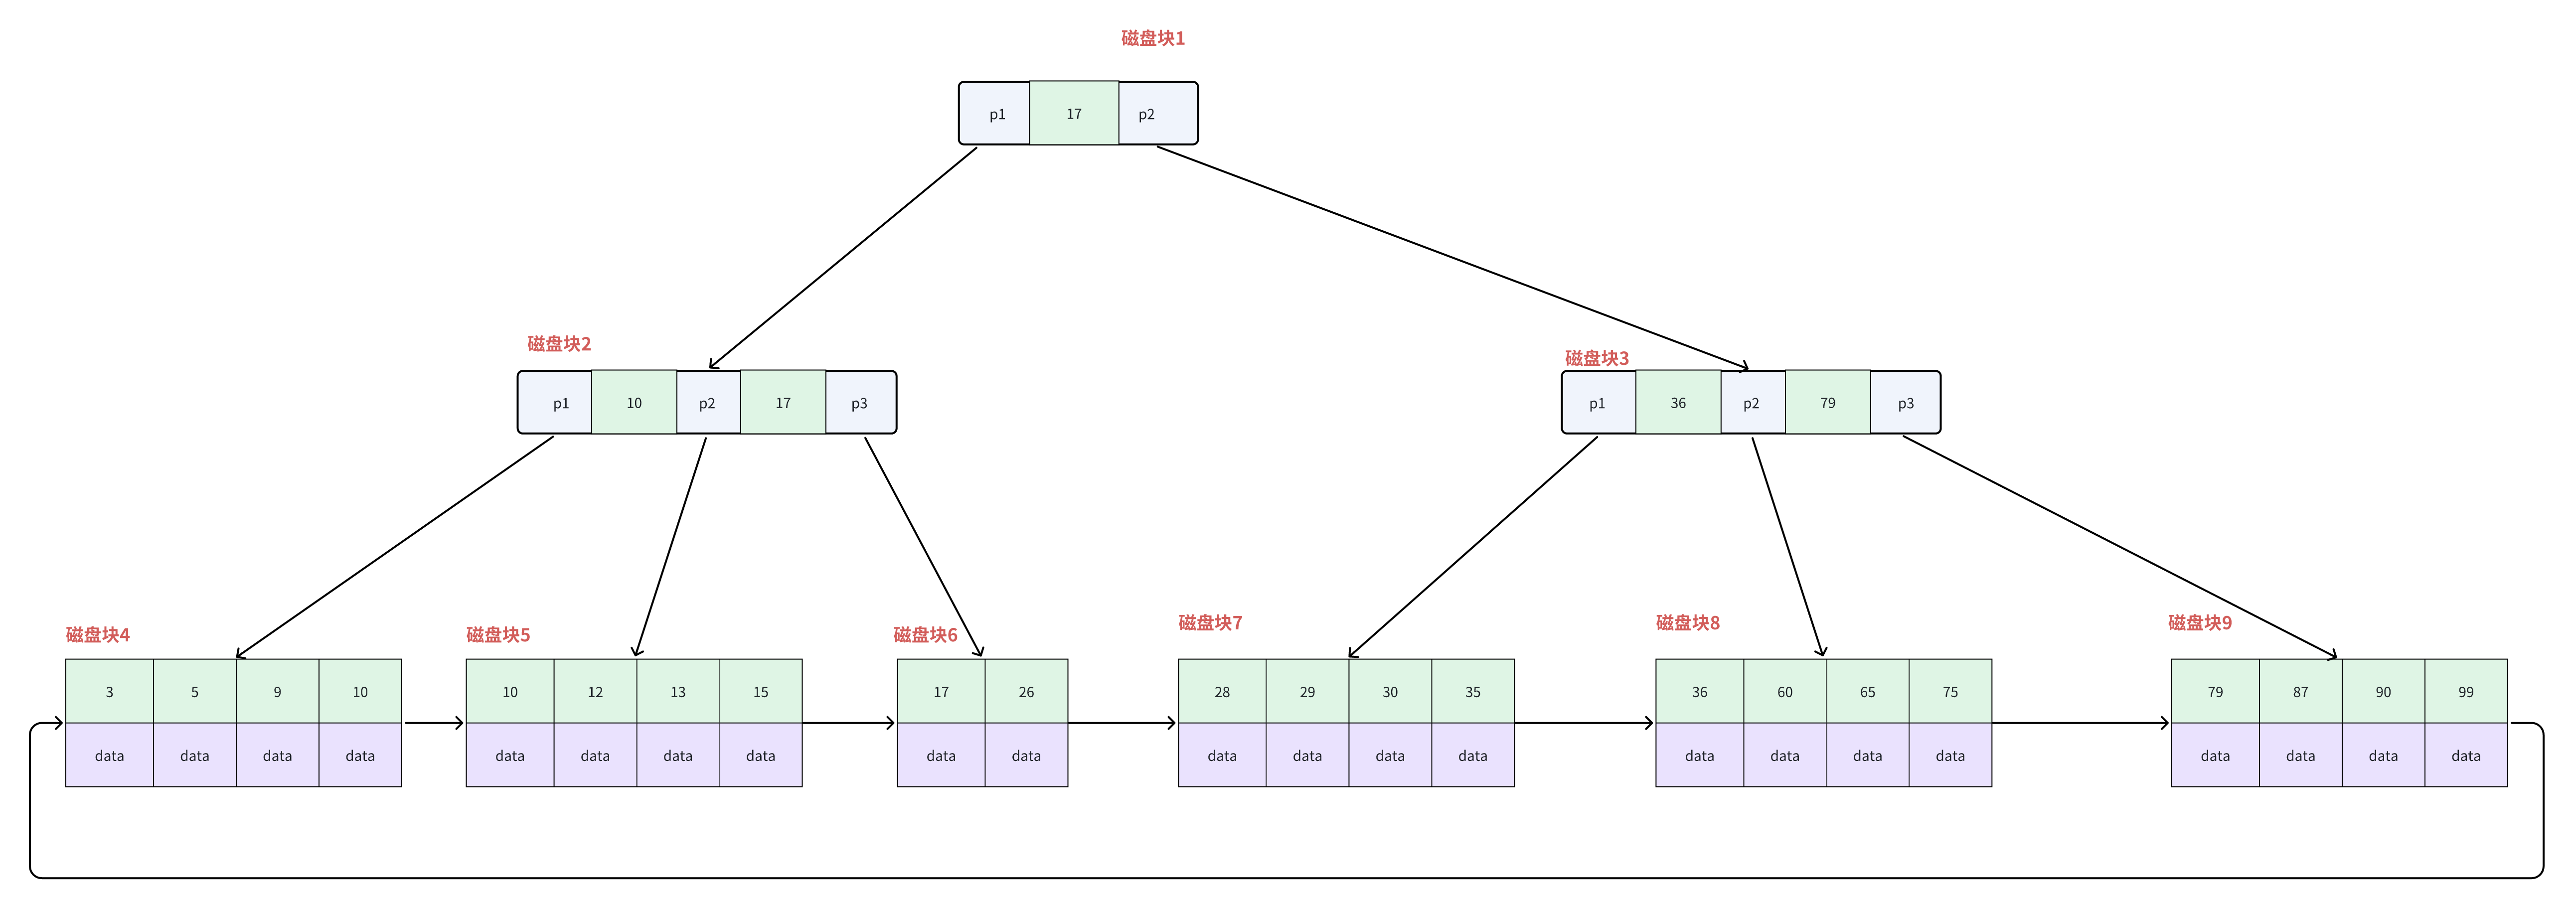
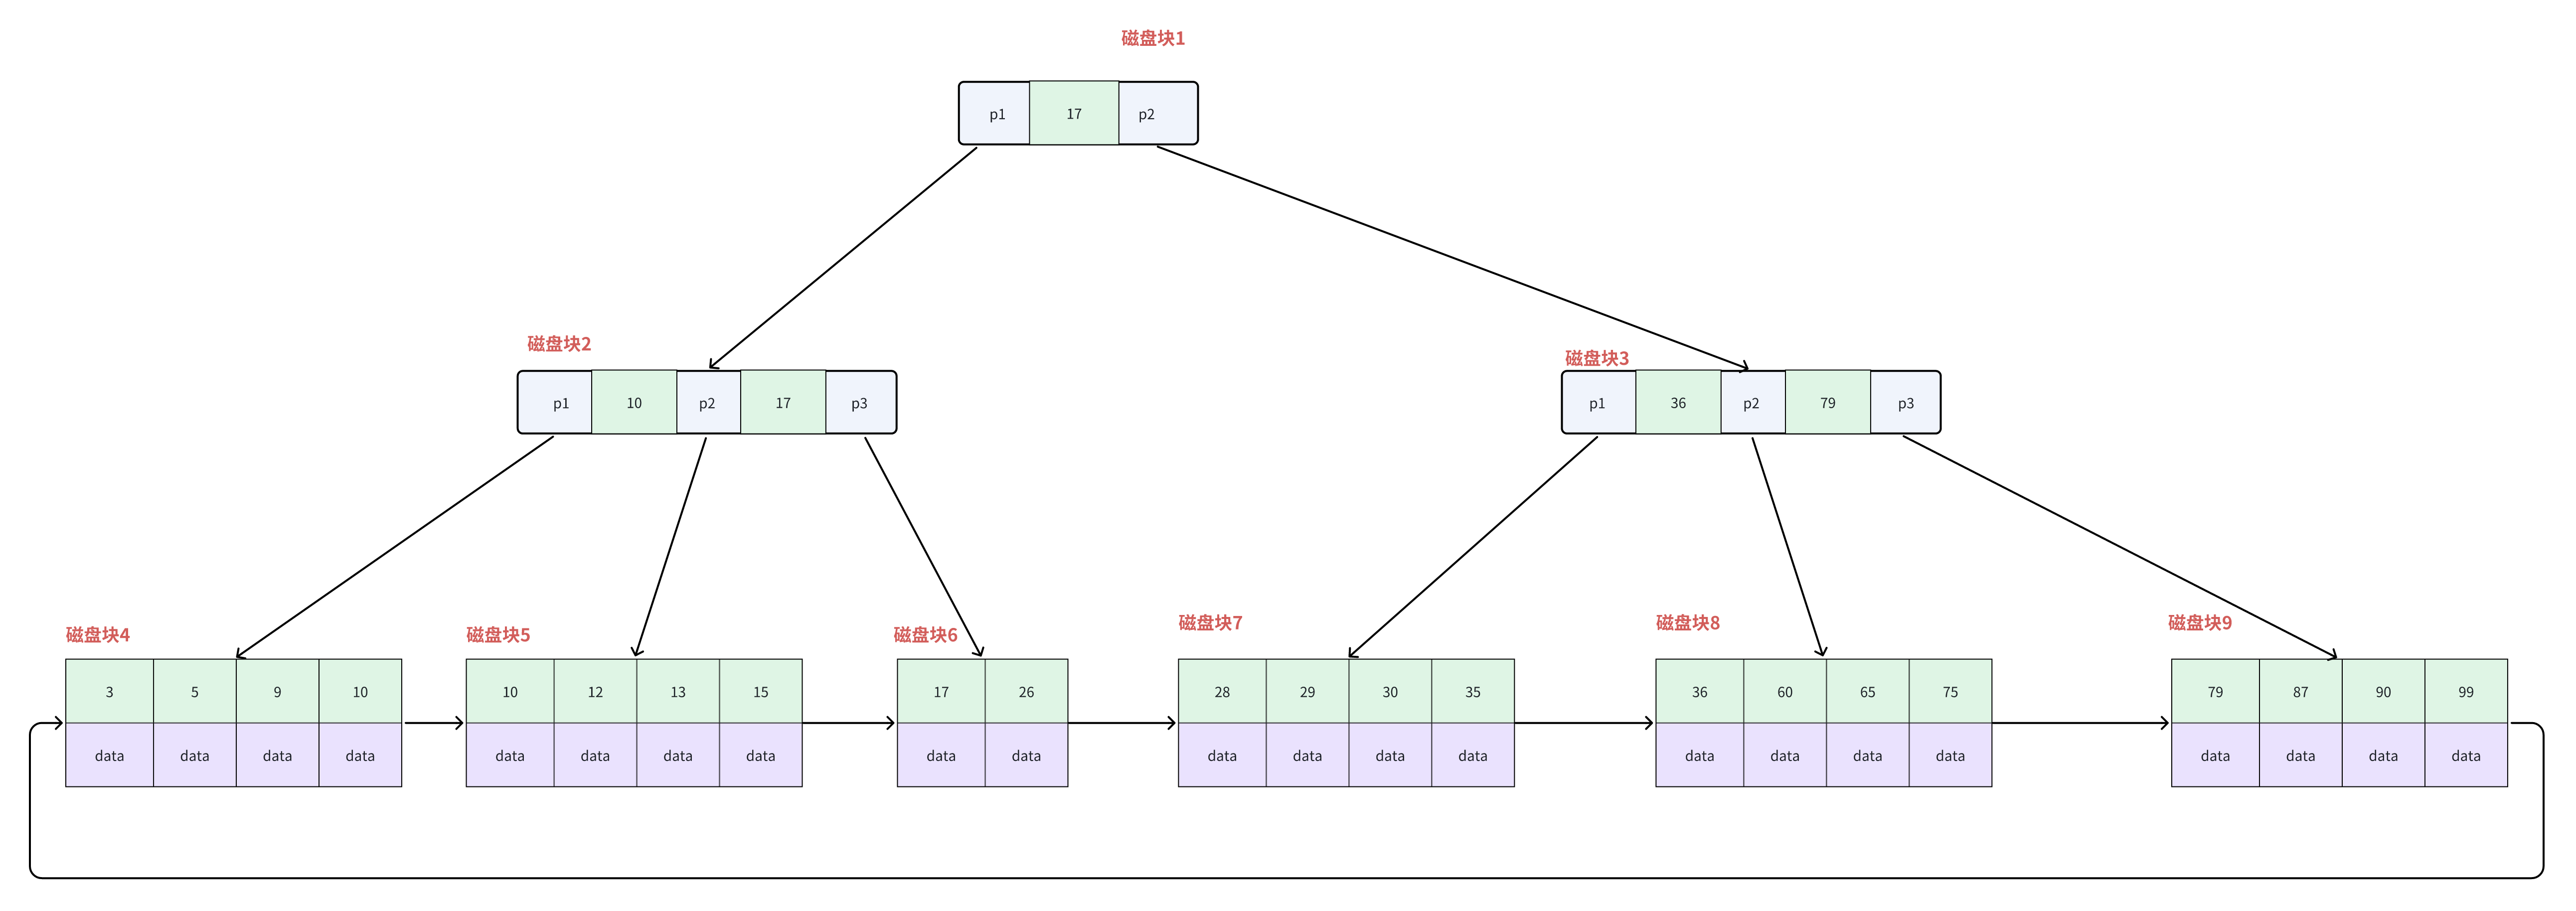
每一个节点就是每一页数据,在节点的存储空间一定的前提下,B树包含了索引值和数据值,而B+树只包含索引值,这就意味着B+树可以存更多的索引。当存储的数据量很大时同样会导致B树的深度较大,增大查询时的磁盘I/O次数,进而影响查询效率。在B+树中,所有数据记录节点都是按照键值大小顺序存放在同一层的叶子节点上,而非叶子节点上只存储索引值信息,这样可以大大加大每个节点存储的索引值数量,降低B+树的高度
InnoDB的底层数据结构就是B+树,其中主页节点是常驻内存的,检索的方式同B树,但是载入内存的大小就减少了很多,对比B树,它的优点如下:
非叶子节点data,只存储索引,可以放更多的索引
所有叶子节点之间都有一个链指针(顺序访问指针,可以提高访问的性能),比如检索大于36的数据,通过索引找到36所在的位置之后,然后直接读取指针就可以拿到全部数据
数据记录都存放在叶子节点中(磁盘)中,只有找到之后才加载到内存中
InnoDB存储引擎页的默认大小是16KB,一般表的主键类型是int,也就是4bytes或者bigint 8bytes,按照bigint来计算,指针类型也一般为6bytes,也就是说根节点一个页中大概存储16KB/(8B+6B)=1170个键值,假设叶子节点的一个页(主要存data的节点)的数据大小为1kb,那么大概就可以存16kb/1kb = 16条数据。也就是说,如果B+树的索引高度为3,那么可以维护的记录数量为1170 1170 16 = 21902400条数据,当数据量超过2000w条的时候,mysql的性能会急剧下降。实际情况中每个节点可能不能填充满,因此在数据库中,B+Tree的高度一般都在2 ~ 4层。MySQL的InnoDB存储引擎在设计时是将根节点常驻内存的,也就是说查找某一键值的行记录时最多只需要1~3次磁盘I/O操作
B+树的索引是存在父子节点冗余的,就是因为这些冗余索引,索引就可以提高了数据检索的速度。就算是全表扫描也是直接走的叶节点之间的指针
跳表
反观 Redis 中的跳表,它的设计哲学完全是另一套逻辑。我在开发实时排行榜功能时,用到了 Redis 的 Sorted Set,也因此深入研究了跳表的实现。它不需要像 B + 树那样严格维持平衡,而是通过抛硬币决定节点层高的 “随机艺术”,在平均情况下同样实现了 O (log n) 的查询效率。这种 “概率平衡” 在内存环境中不仅可行,还带来了更简单的实现和更快的插入删除操作。
有一次线上 Redis 出现性能抖动,排查发现是某个热点 Key 的频繁更新导致跳表层高失衡。这让我意识到,虽然跳表的设计足够巧妙,但脱离实际业务场景去空谈数据结构,很容易忽略这些隐藏的风险。
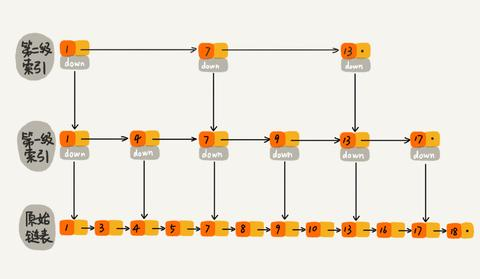
多层索引结构
最底层(第 0 层)是完整的有序链表,包含所有节点
上层索引是下层的 "稀疏采样",每个节点随机决定是否晋升到更高层
顶层索引仅包含少量节点,形成 "快速通道"
给面试官和开发者的建议
如果我是面试官,比起问 “跳表和 B + 树的区别”,我更愿意聊:“在设计一个火车票查询系统时,你会如何选择索引结构?如果数据量从千万增长到十亿,又该如何调整?” 这种问题才能真正考察候选人对技术的理解深度和工程实践能力。
作为开发者,我们也应该跳出 “背答案” 的思维定式。下次遇到索引优化问题时,不妨多问自己几个为什么:为什么 MySQL 的非叶子节点只存索引不存数据?为什么 Redis 的跳表层高概率设为 0.5?当我们开始从场景需求倒推技术选型时,才算真正入门了数据库开发。
技术世界没有绝对的优劣,只有适不适合。
评论区