




ElasticSearch 详解:从认知到实战的全栈知识体系
Elasticsearch 是一个基于 Lucene 的分布式、实时搜索与分析引擎,广泛应用于日志分析、全文检索、数据监控等场景。它不仅是现代大数据架构中的核心组件之一,更是构建实时搜索平台不可或缺的一环。
本篇文章将带你系统性地梳理 ElasticSearch 的学习路径,从基础概念、安装部署、核心功能、底层原理,到性能优化和大厂实践,构建一套完整的知识体系。
一、初识 ElasticSearch:建立全局认知
ES详解 - 认知:ElasticSearch基础概念
在正式使用 Elasticsearch 前,我们需要理解它的基本概念:
节点(Node):一个运行中的 Elasticsearch 实例。
集群(Cluster):由多个节点组成的数据集合。
索引(Index):类似于数据库中的“表”,是文档的逻辑容器。
文档(Document):以 JSON 格式存储的基本数据单元。
分片(Shard)与副本(Replica):实现高可用和水平扩展的核心机制。
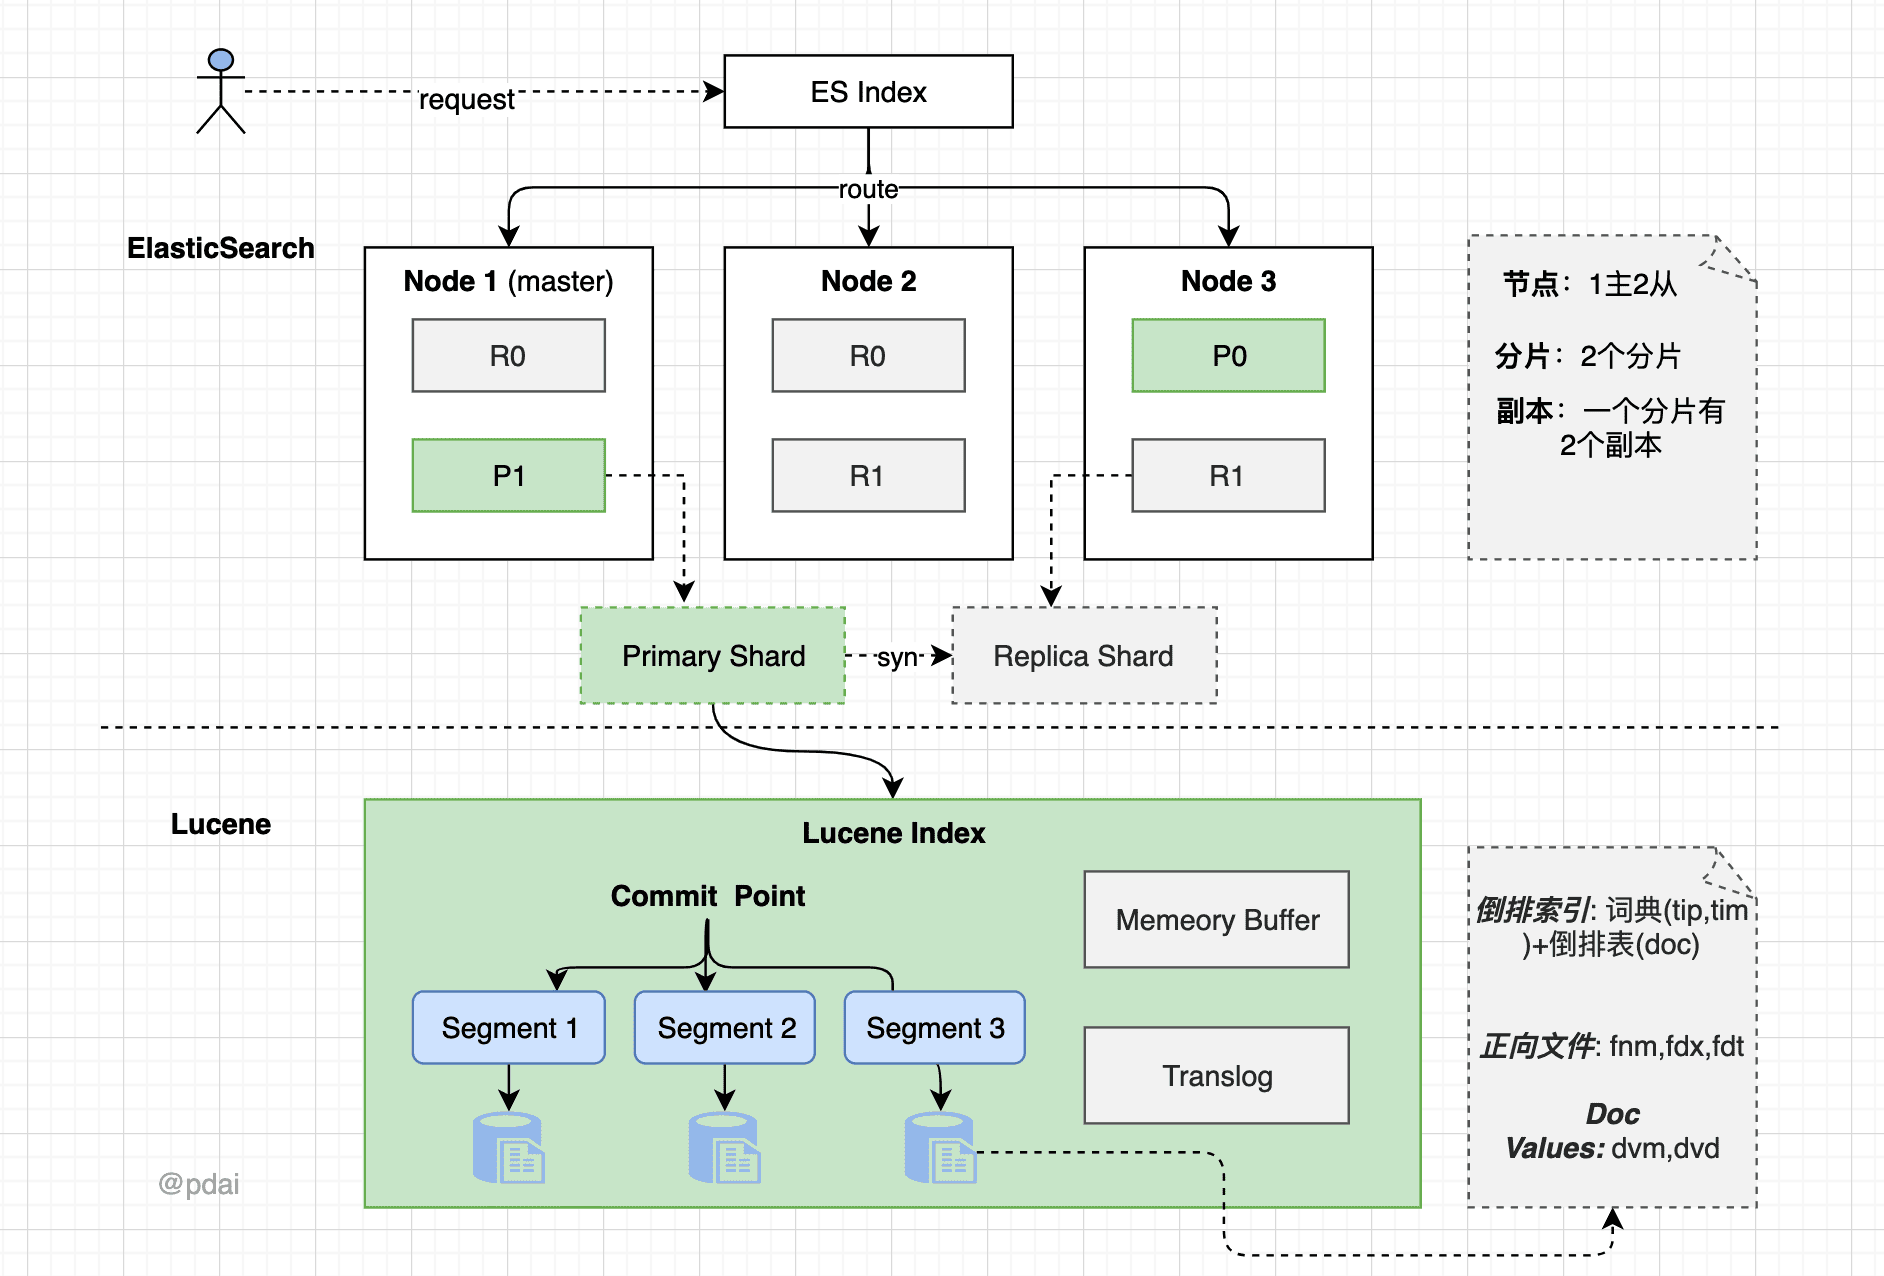
掌握这些概念有助于我们更好地理解其工作原理和应用场景。
ES详解 - 认知:Elastic Stack生态和场景方案
Elasticsearch 通常与其他组件共同构成 Elastic Stack(即 ELK Stack):
Logstash:用于日志采集、过滤和传输;
Kibana:可视化界面,用于查询展示和仪表盘构建;
Beats:轻量级数据采集器(如 Filebeat、Metricbeat 等);
Elastic Agent:新一代统一代理工具,集成 Beats 与部分 Logstash 功能。
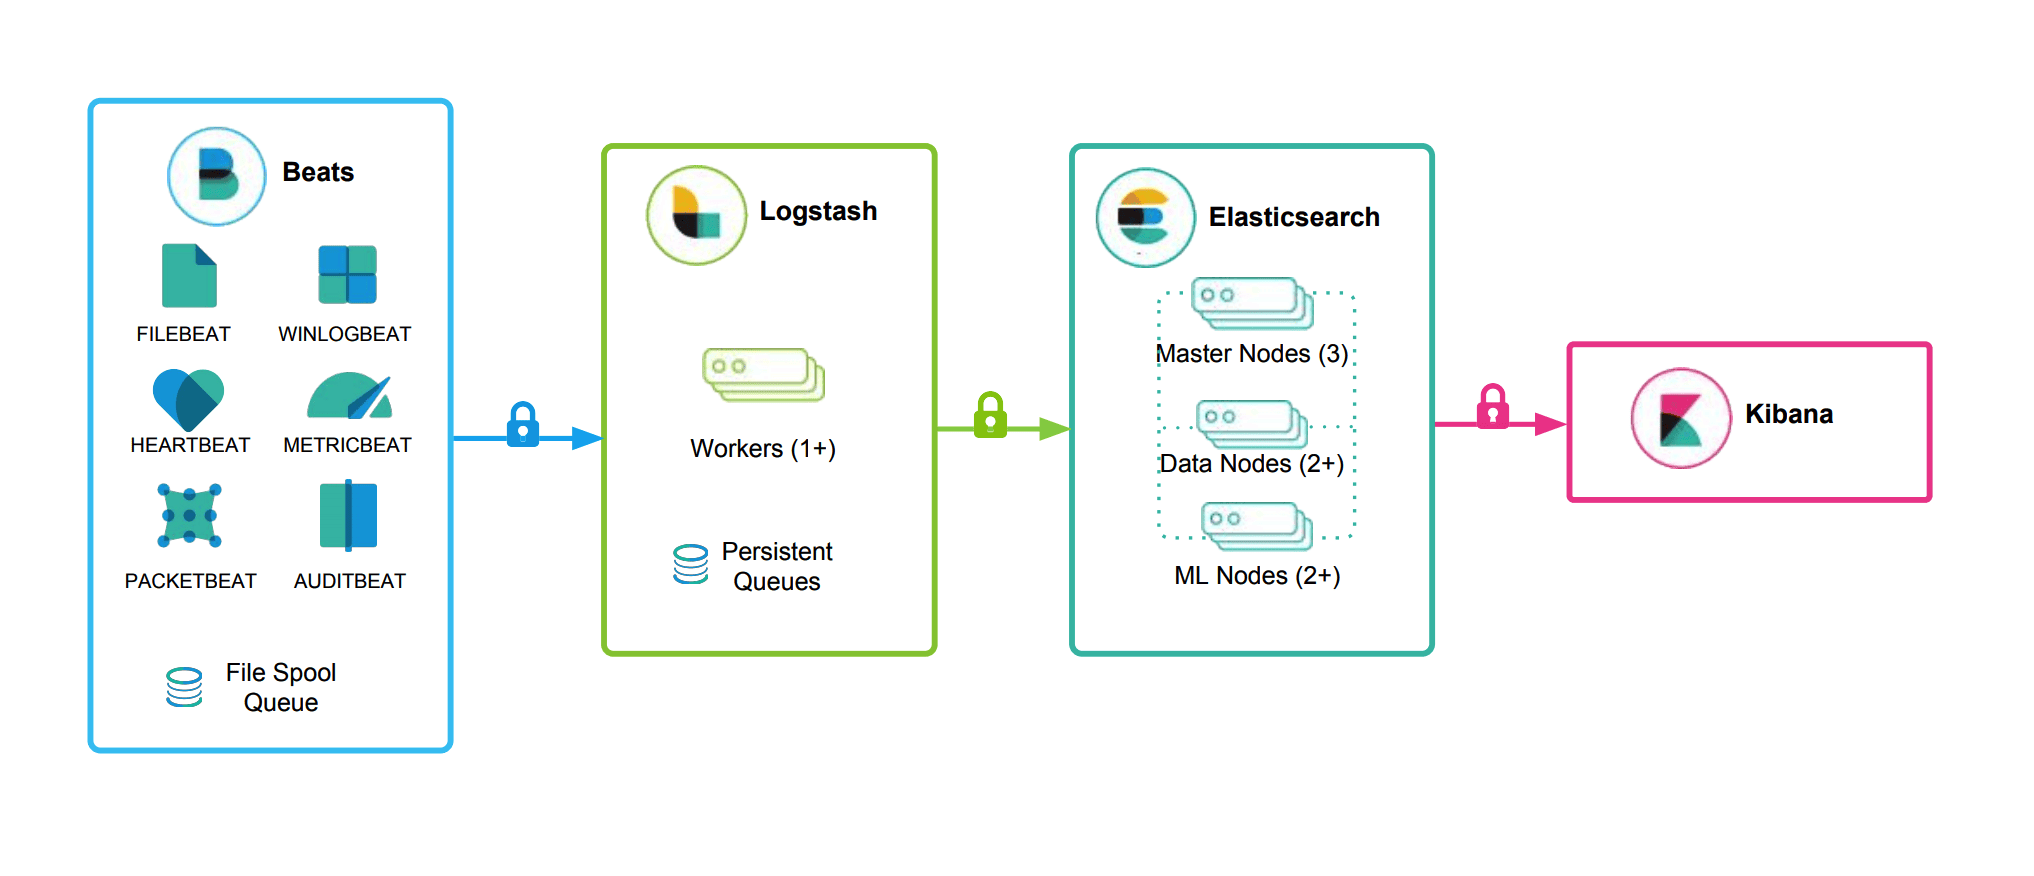
典型应用场: Elastic Stack(ELK 等组件组成的生态 )的数据流转与应用架构图,各部分作用及流程如下:
“多源数据采集 → 针对性处理 / 转发 → Elasticsearch 存储 → Kibana 可视化分析及 APM 专项应用” ,实现从数据产生到可观测、可分析的闭环,用于日志管理、应用性能监控、指标分析等场景 。
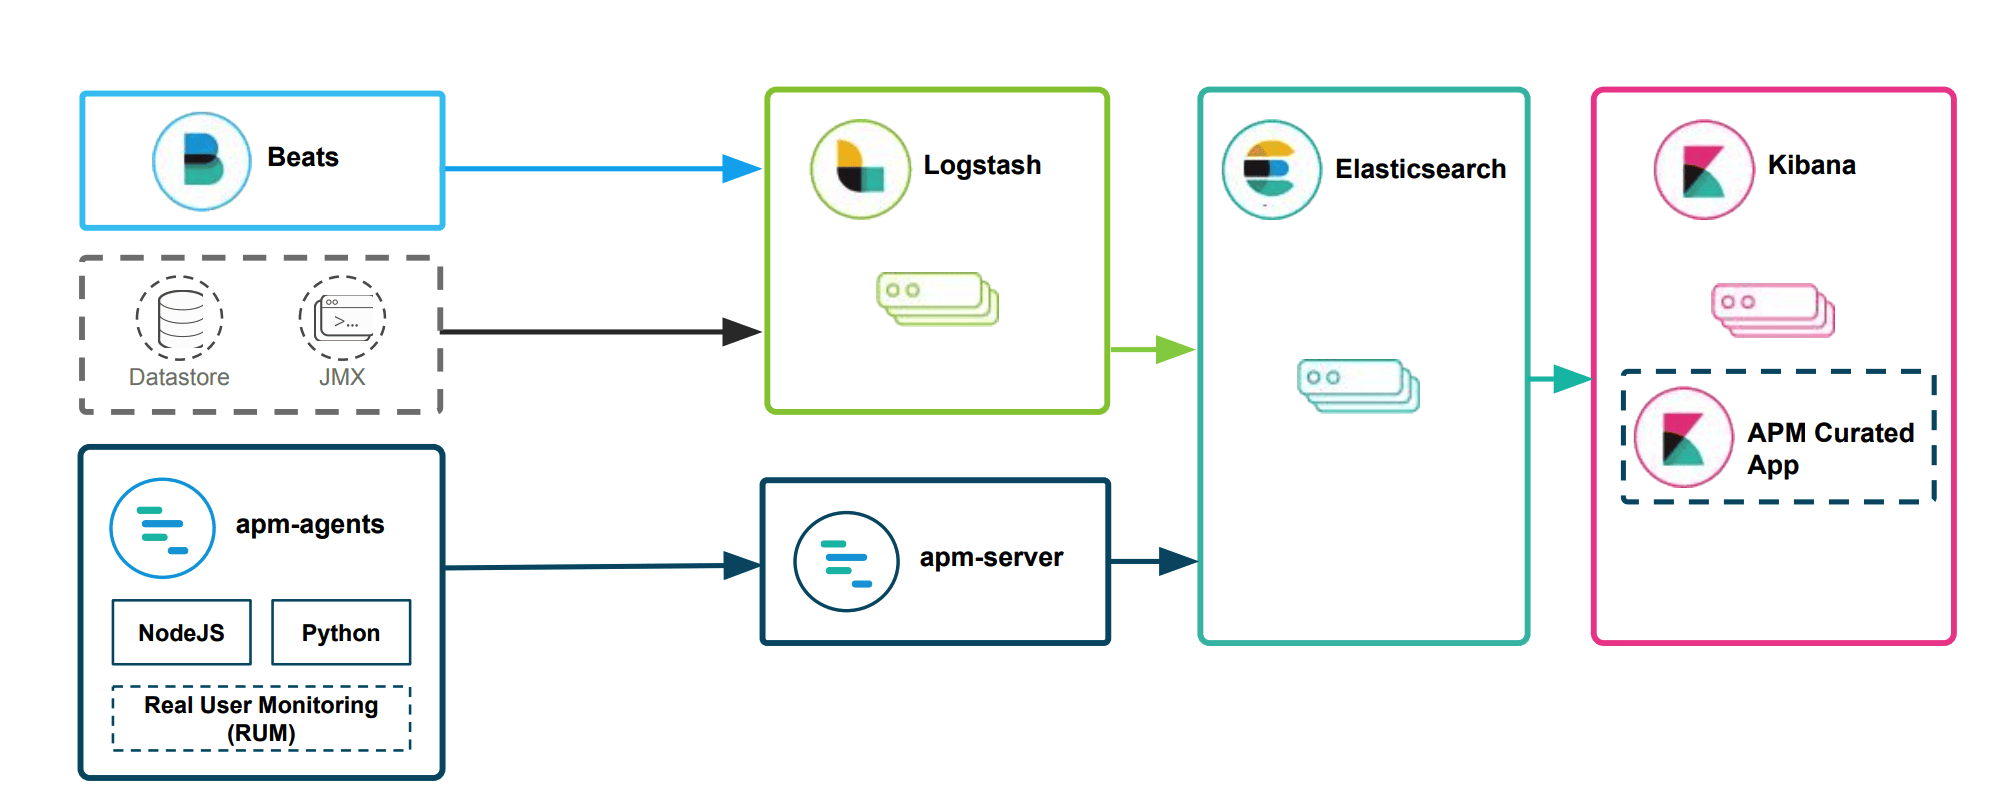
数据采集层
Beats:轻量级数据采集器家族(如 Filebeat 采集日志、Metricbeat 采集指标等 ),从服务器、设备等源头采集各类数据(日志、 metrics 等 ),作为数据输入的一种方式。
Datastore + JMX:代表其他数据源,比如数据库(Datastore )的日志、指标,或通过 JMX(Java 管理扩展 )采集 Java 应用的性能数据,和 Beats 共同作为原始数据入口。
apm - agents:应用性能监控(APM )探针,嵌入 NodeJS、Python 等应用代码里,采集应用调用链路、性能指标(如响应时间、错误 ),还支持 Real User Monitoring(RUM ,真实用户监测,采集前端用户交互性能数据 ),专注于应用性能数据采集。
数据处理与传输层
Logstash:数据处理管道,接收 Beats、Datastore/JMX 过来的数据,可做解析、过滤、 enrichment(比如给日志加字段 )等复杂处理,再转发给 Elasticsearch 。
apm - server:专为 APM 设计的服务,接收 apm - agents 上报的应用性能数据,做初步校验、转换,然后推送给 Elasticsearch ,是 APM 数据的 “中转站”。
数据存储与检索层
Elasticsearch:分布式搜索引擎与存储,接收 Logstash、apm - server 处理后的数据,进行索引、存储,支持快速检索、聚合分析,是整个架构的 “数据中心”。
数据可视化与应用层
Kibana:可视化与交互平台,对接 Elasticsearch ,可基于存储的数据搭建 Dashboard(如日志分析看板、APM 性能看板 ),用于查询、可视化、分析数据。
APM Curated App:Kibana 中针对 APM 场景的预置应用,基于 Elasticsearch 里的 APM 数据,提供开箱即用的应用性能分析界面(比如调用链追踪、性能瓶颈定位 ),让 APM 数据的可视化、分析更便捷。
评论区