




如今数据库五花八门厂家繁多,我们有没有思考过每种数据库为什么都有自己的执行引擎,数据库引擎的执行本质是什么?上次我在写MySQL的优化的时候,忽然想到了这个问题,今天我们来探讨一下。
1. 数据库引擎的多样性为何各有千秋?
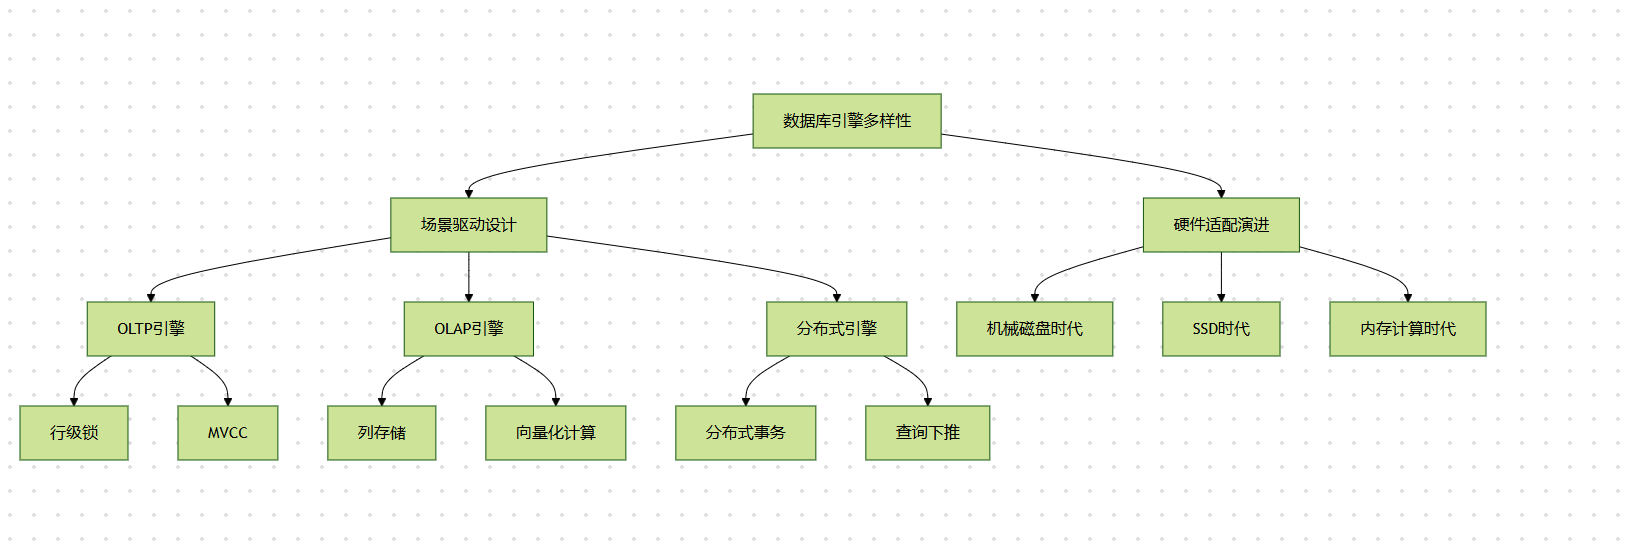
不同数据库(如MySQL、PostgreSQL、MongoDB、ClickHouse)之所以设计独特的执行引擎,本质是为了适配差异化的业务场景需求与硬件技术演进。
场景驱动的设计差异OLTP数据库如MySQL InnoDB强调事务一致性与高并发,因此执行引擎注重行级锁、MVCC、崩溃恢复等机制;OLAP数据库如ClickHouse聚焦海量数据分析,执行引擎采用列存储、向量化计算、数据分片等架构;分布式数据库(如TiDB)则需解决跨节点数据一致性,执行引擎集成分布式事务(如2PC)、查询下推等特性。
硬件适配的技术迭代:
传统机械磁盘时代,引擎优化聚焦减少随机I/O(如B+树索引);
固态硬盘(SSD)普及后,部分引擎(如RocksDB)弱化B+树层级,改用LSM树结构提升写入性能;
内存数据库(如Redis)则抛弃磁盘持久化引擎,直接在内存中处理数据,通过异步落盘保证可靠性。
2. 数据库引擎的执行本质从逻辑到物理的“翻译官”
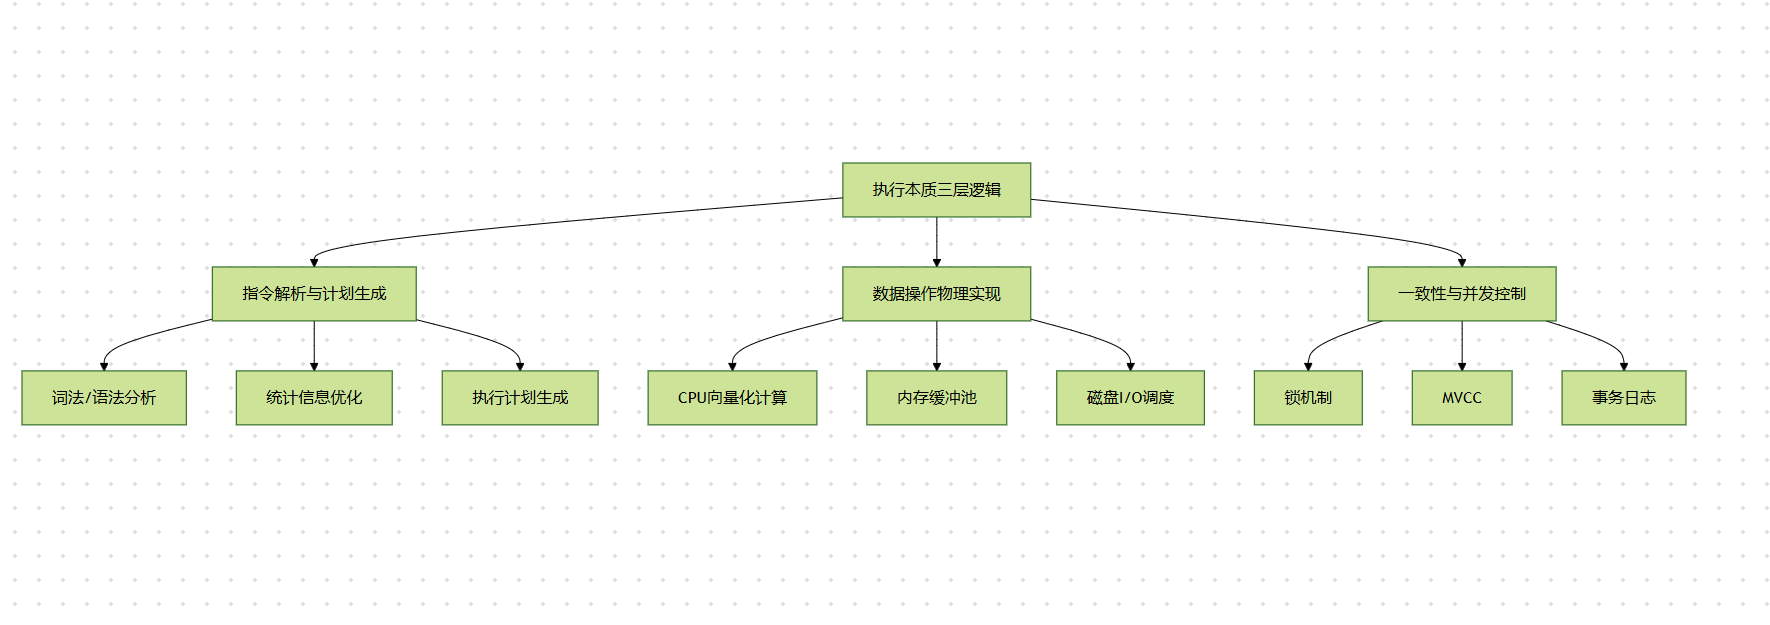
无论何种数据库,执行引擎的核心使命都是将用户的逻辑操作(如SQL、NoSQL指令)转化为底层硬件可执行的物理操作,并在性能、可靠性、成本之间找到平衡点。其执行本质可拆解为三层逻辑:
1. 指令解析与执行计划生成从人话到机器语言的翻译
解析阶段:
引擎首先对输入指令进行词法分析(如拆分SQL关键字)、语法校验(如括号匹配)和语义验证(如表/字段存在性)。以MySQL为例,SELECT * FROM users WHERE age>18会被解析为抽象语法树(AST),并验证users表与age字段的合法性。优化阶段:
执行引擎的优化器基于统计信息(如表行数、索引选择性)生成执行计划。例如:若
age字段有索引,优化器估算走索引扫描的成本(如I/O次数、CPU运算量);若全表扫描成本更低(如表数据量极小),则选择直接遍历数据页。
案例:不同引擎的优化策略差异
MySQL优化器侧重成本估算(基于历史统计信息),而PostgreSQL的优化器支持更复杂的启发式优化(如并行查询规划);
MongoDB的执行引擎对JSON查询进行特定优化(如利用BSON索引快速定位文档)。
2. 数据操作的物理实现:硬件资源的高效调度器
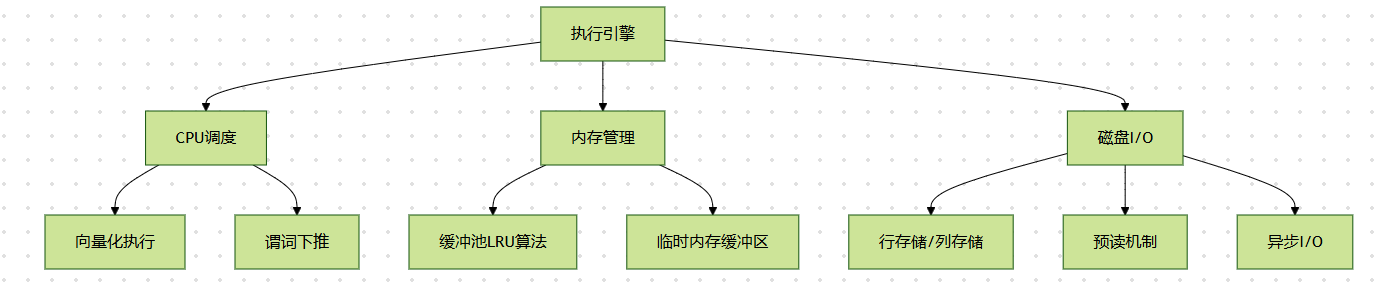
执行引擎的核心能力在于协调CPU、内存、磁盘等硬件资源,以最低成本完成数据操作。
CPU层面计算逻辑的高效执行
向量化执行(Vectorized Execution)将数据按列批量处理(如每批1000行),减少函数调用开销,典型如ClickHouse的执行引擎;
谓词下推(Predicate Pushdown)将过滤条件(如
WHERE age>18)下推到存储层执行,避免上层传输无效数据(如Hive查询引擎对HDFS数据的过滤)。
内存层面数据处理的高速通道
缓冲池(Buffer Pool)缓存热点数据页,减少磁盘I/O。例如InnoDB的缓冲池采用LRU-K算法,区分“短期热点”与“长期热点”数据;
临时内存管理排序、JOIN等操作使用专用缓冲区(如MySQL的Sort Buffer),超出阈值时溢出到磁盘(影响性能)。
磁盘层面持久化与I/O优化
存储格式适配行存储引擎(如InnoDB)将一行数据连续存储,适合OLTP场景;列存储引擎(如Parquet)按列分组,适合OLAP聚合查询;
I/O调度策略机械磁盘场景下,引擎通过预读(Read-Ahead)机制将随机I/O转化为顺序I/O(如InnoDB的
innodb_read_ahead_threshold参数控制预读页数)。
3. 数据一致性与并发控制:可靠性的底层保障
执行引擎必须在多用户并发访问时保证数据正确性,同时最大化吞吐量。
锁机制与MVCC
锁粒度优化:OLTP引擎(如InnoDB)采用行级锁,减少并发冲突;OLAP引擎(如Druid)多为读多写少场景,采用表级锁简化实现;
MVCC(多版本并发控制):通过版本链实现非阻塞读,如InnoDB在RR隔离级别下,读操作访问事务开始时的数据版本,避免被写操作阻塞。
事务与日志系统
ACID特性实现:通过redo日志(持久性)、undo日志(原子性)、锁机制(隔离性)保证事务可靠性;
崩溃恢复:引擎启动时通过重做日志(Redo Log)恢复未提交事务,通过回滚日志(Undo Log)撤销异常事务(如InnoDB的Crash Recovery机制)。
三、从MySQL看执行引擎的共性与特性
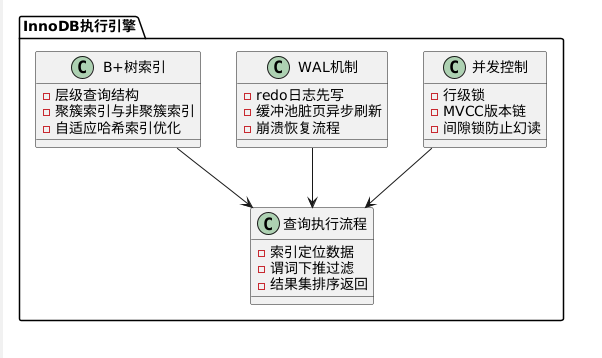
以MySQL InnoDB引擎为例,其执行本质体现了多数OLTP引擎的核心逻辑:
索引驱动的查询执行:
通过B+树索引定位数据(如SELECT * FROM t WHERE id=1通过主键索引直接定位数据页),若索引缺失则触发全表扫描;WAL(Write-Ahead Logging)机制:
先写日志再写数据,确保崩溃后可恢复。例如更新数据时,先将redo日志写入磁盘,再修改缓冲池中的数据页,最终异步刷新脏页;自适应哈希索引(Adaptive Hash Index):
自动对高频访问的B+树节点构建哈希索引,将O(log n)的查询复杂度降至O(1),提升热点数据访问效率。
评论区