




本章我们探讨一下 官网的优化器成本模型是基于成本估算,那么我们本文聊聊什么是优化器成本模型。
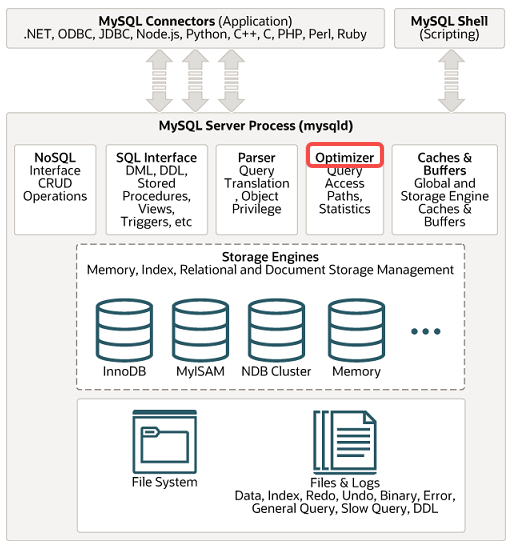
根据mysql的整体架构(官网图18.3 可插拔存储引擎的MySQL架构),我们应该是属于此章节内容 。
根据MySQL 8.0 官方文档,MySQL 对成本的估算有一套默认的常数设定,例如,读取一个页面的成本默认设为 1.0,读取并检测一条记录是否符合搜索条件的成本默认是 0.2。在计算全表扫描的成本时,MySQL 会使用聚簇索引占用的页面数来计算 I/O 成本,并且不区分非叶子节点和叶子节点。对于单表查询,优化器会找出所有可能的执行方案,对比它们的成本,选择成本最低的方案作为执行计划。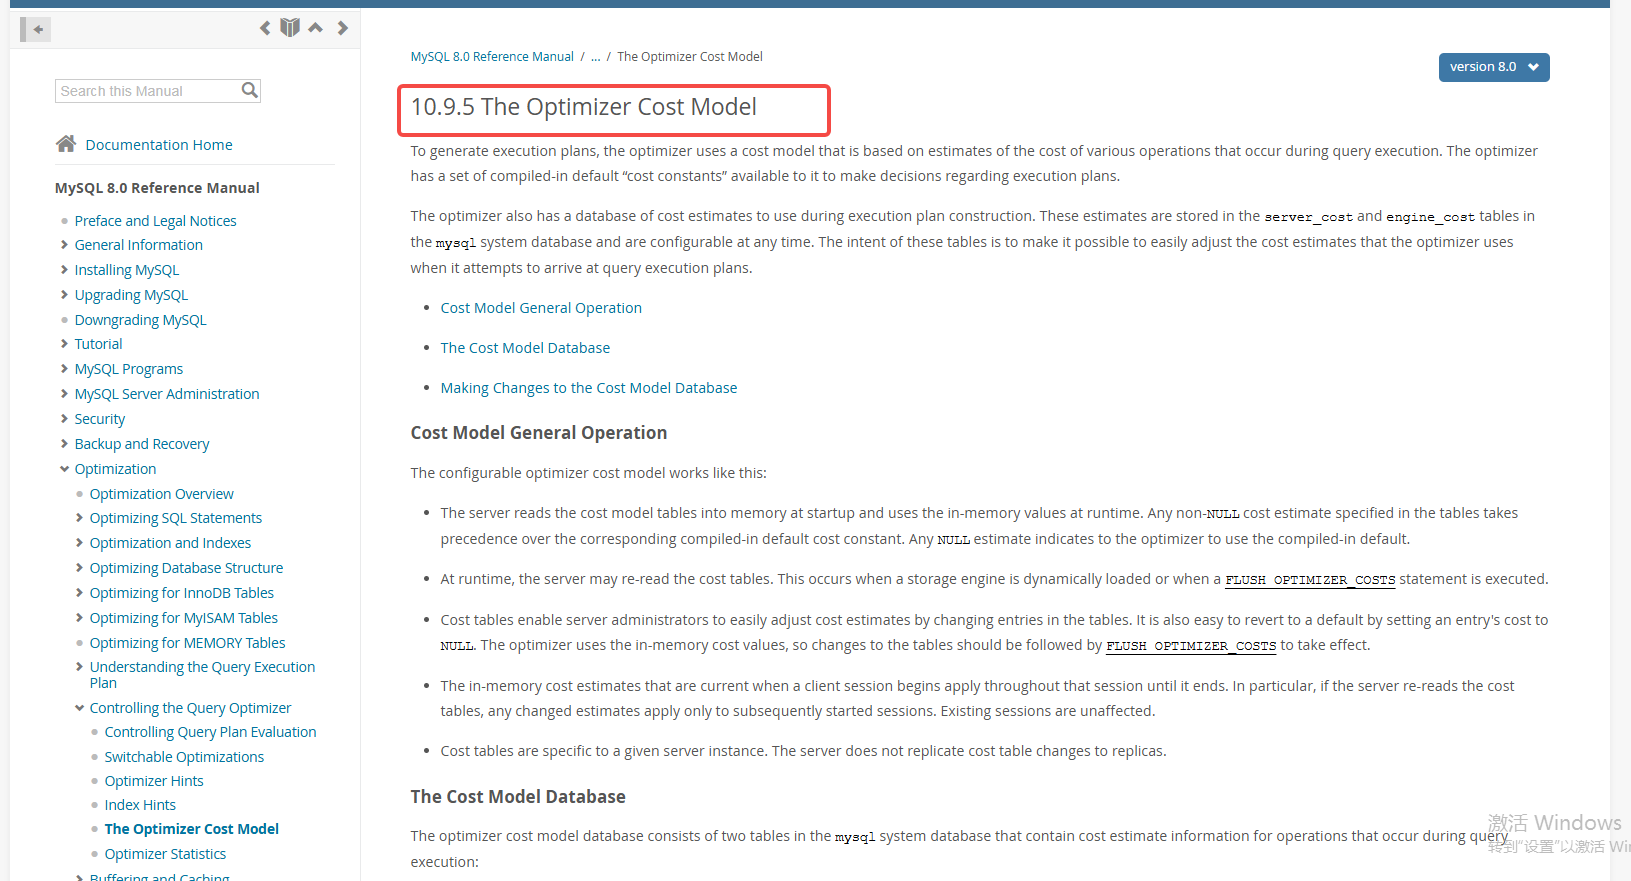
查询优化器决定了 SQL 查询执行的效率和性能。MySQL 和 PostgreSQL 作为两款广泛使用的开源数据库,它们的优化器在设计理念和实现方式上存在着显著的差异。其中,MySQL 优化器侧重于基于历史统计信息的成本估算,而 PostgreSQL 的优化器则支持更复杂的启发式优化,如并行查询规划。
为了生成执行计划,优化器会使用一个成本模型,该模型基于对查询执行过程中各种操作成本的估算。优化器具备一组编译时内置的默认 “成本常数”,可借助这些常数来决策执行计划。
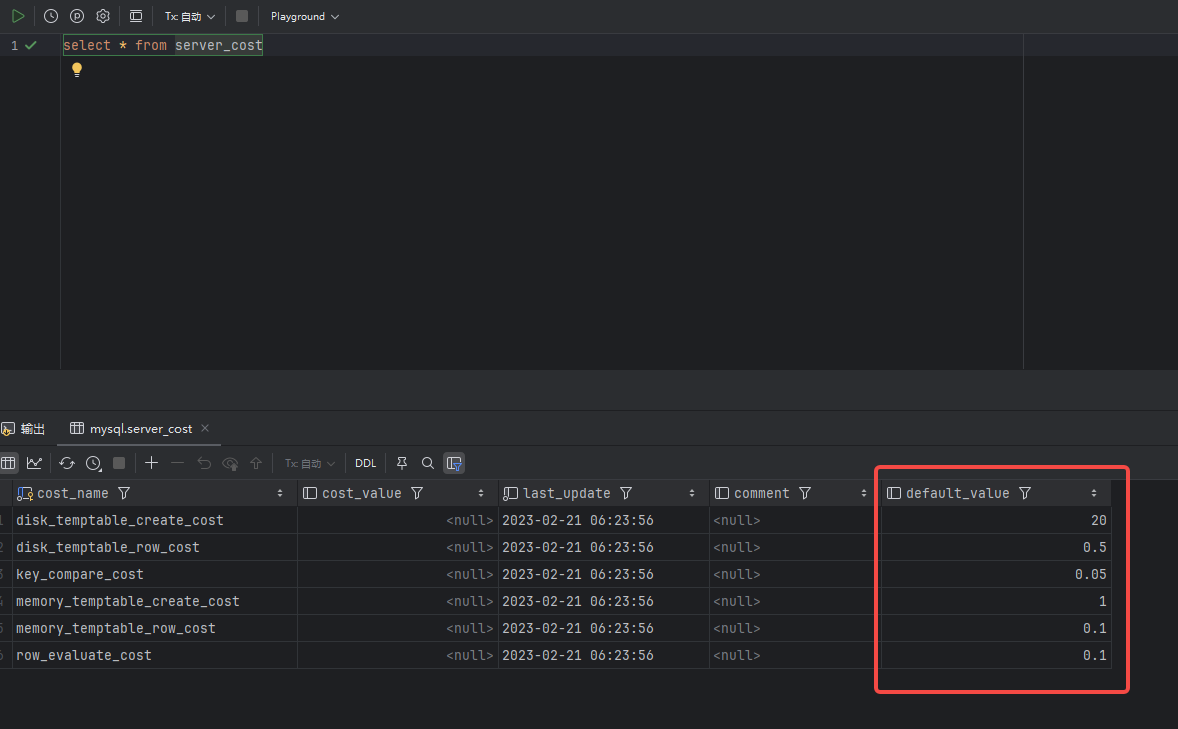
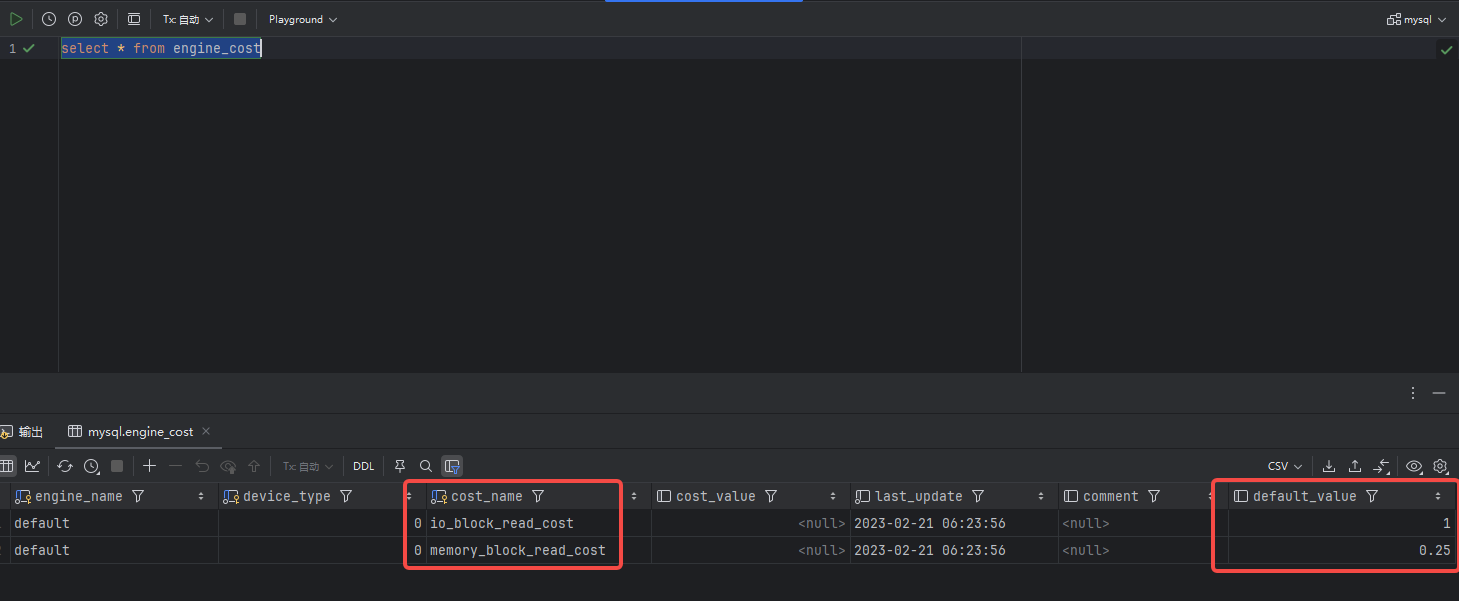
如下图 是 我本地安装的MySQL8.0版本的成本模型参数。
1. server_cost 表(通用服务器操作成本)
server_cost
engine_cost
MySQL 优化器的工作原理
如下图所示
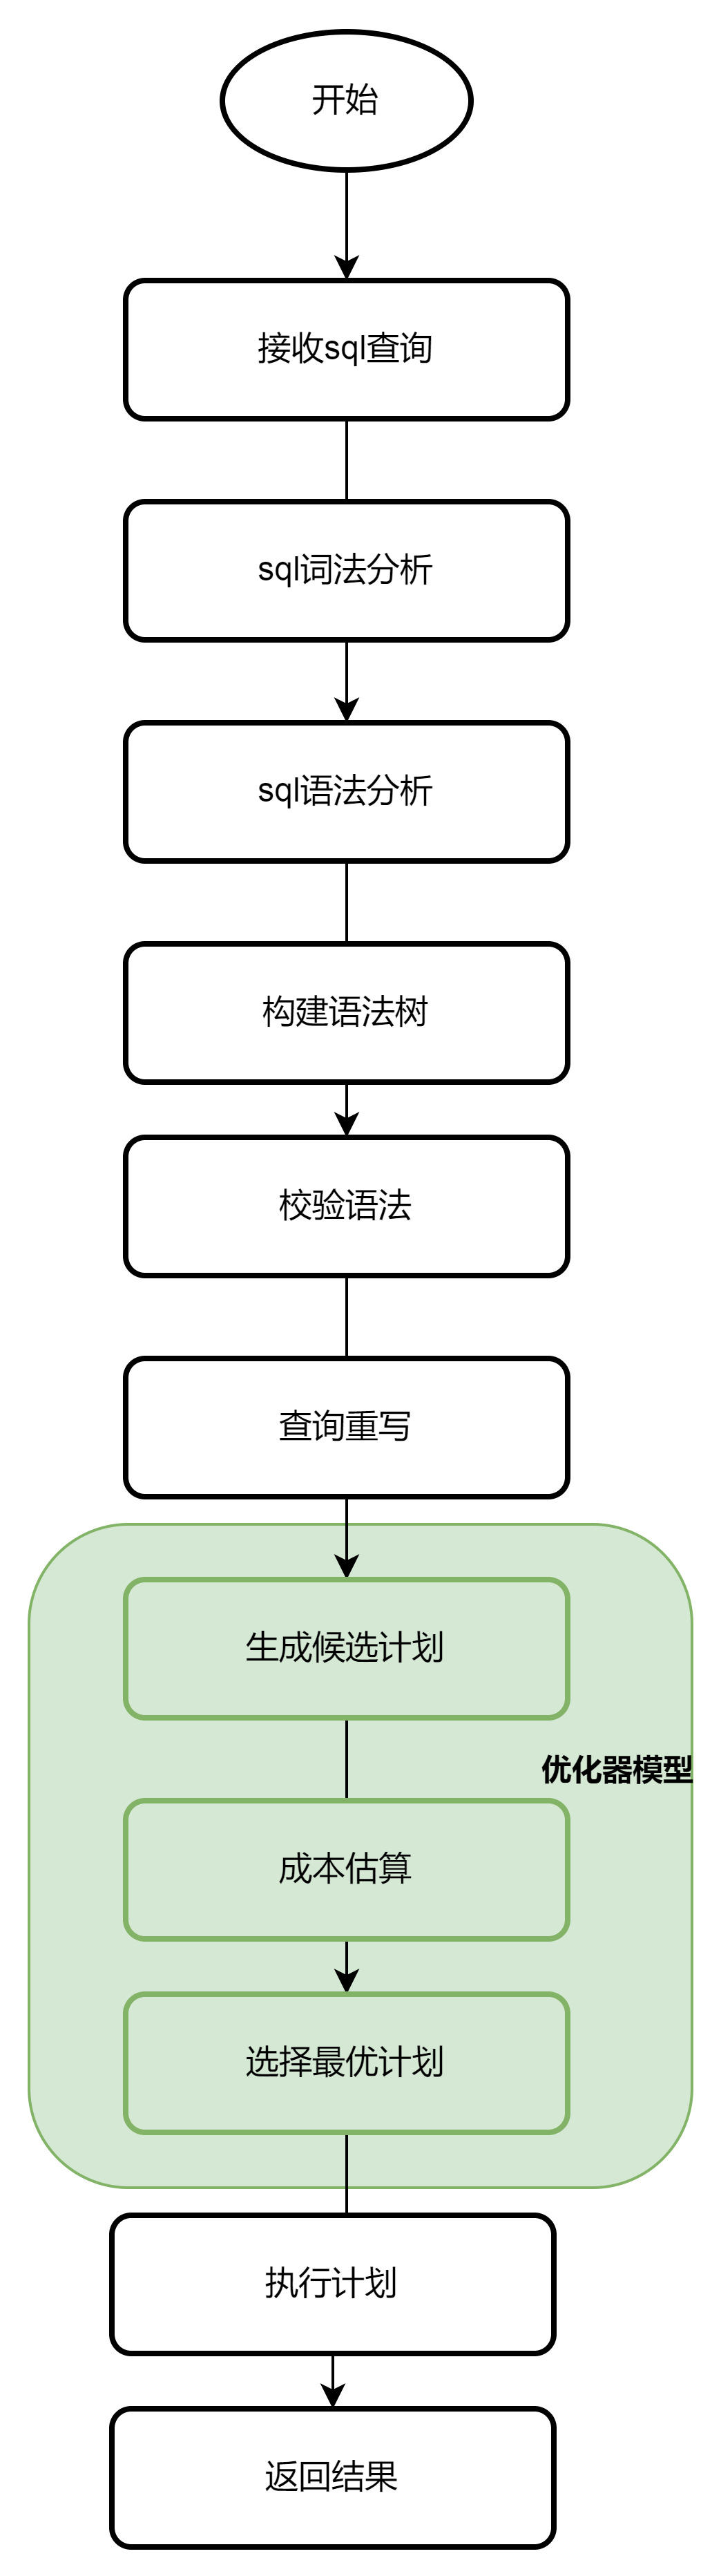
MySQL 优化器在执行 SQL 语句时,其工作原理主要包括以下几个关键阶段:
1. 解析和预处理阶段 词法和语法分析
如上图所示,在这个阶段包含 词法分析->语法分析->生成LST
优化器首先对 SQL 语句进行词法分析,将输入的 SQL 文本分解成一个个词法单元(token),比如关键字、标识符、操作符等。
接着进行语法分析,依据 MySQL 的语法规则检查 SQL 语句的语法是否正确,构建出一棵语法树。例如对于
SELECT * FROM users WHERE age > 18;,会构建出表示SELECT操作、表引用、条件判断等的语法树结构。
语义检查:
检查查询中涉及的表、列、函数等是否存在。比如在上述 SQL 中,检查
users表是否存在,age列是否属于users表。解析别名,确定表和列的实际引用关系。如果有
SELECT u.age AS user_age FROM users AS u;,会明确u是users表的别名,user_age是age列的别名。处理默认值,例如插入数据时,如果没有指定某列的值,检查该列是否有默认值并应用。
2. 查询重写阶段
等价改写
优化器会对 SQL 进行等价改写,以生成更高效的执行形式。例如,将子查询改写为连接操作,因为连接操作在某些情况下可能更高效。对于
SELECT * FROM users WHERE user_id IN (SELECT user_id FROM orders);,可能会改写成SELECT u.* FROM users u JOIN orders o ON u.user_id = o.user_id;。应用谓词下推,将过滤条件尽可能地提前应用到数据源上。比如在多表连接时,如果有条件
WHERE a.id = 1 AND b.name = 'test',如果a表连接b表,且a表有索引,就可以先在a表上应用a.id = 1的过滤条件,减少后续连接的数据量。
常量折叠和表达式简化
对于 SQL 中的常量表达式,优化器会在编译阶段计算出结果,减少运行时的计算开销。例如
SELECT 2 + 3 * 4;,优化器会直接计算出结果为14。简化复杂的条件表达式,如
(a > 5 AND a < 10) AND a > 8,可以简化为a > 8 AND a < 10。
3. 生成执行计划阶段
枚举可能的执行计划:
针对查询涉及的表,考虑不同的连接顺序、索引使用方式等,生成多个可能的执行计划。例如,对于
SELECT * FROM users JOIN orders ON users.user_id = orders.user_id;,可以先扫描users表再连接orders表,也可以先扫描orders表再连接users表,还可以选择不同的索引来访问表中的数据。
成本估算:
优化器使用成本模型(通过
server_cost和engine_cost表配置)来估算每个执行计划的成本。成本因素包括磁盘 I/O 成本(如读取数据块的成本)、内存使用成本(如内存临时表创建和操作成本)、CPU 计算成本(如比较操作、条件评估成本)等。比如,对于一个全表扫描操作,会根据表的大小估算磁盘 I/O 成本;对于使用索引的操作,会考虑索引的查找成本。
选择最优执行计划:
比较各个执行计划的成本,选择成本最低的执行计划作为最终的执行方案。例如,在上述
users表和orders表连接的例子中,如果先扫描users表并利用其索引进行连接的成本低于其他方式,优化器就会选择该执行计划。
4. 执行阶段
执行计划的执行:
按照生成的最优执行计划,MySQL 执行器从存储引擎中读取数据,执行各种操作,如过滤、连接、排序等。例如,根据计划使用特定的索引从表中读取数据,然后按照连接条件进行表连接操作,最后对结果进行过滤和排序等。
反馈和调整(在某些情况下):
在执行过程中,如果发现实际的执行情况与优化器的估算有较大偏差(例如统计信息不准确导致估算错误),MySQL 可能会采取一些措施进行调整,比如重新优化查询(在支持自适应查询优化的版本中),以提高后续执行的效率。
MySQL 优化器基于成本估算的决策
成本模型基础
MySQL 的查询优化器采用基于成本的优化(Cost-Based Optimization, CBO)策略。在这种策略下,优化器会为每个可能的查询执行计划估算成本,成本主要由两部分构成:I/O 成本和 CPU 成本。I/O 成本涉及从磁盘读取数据页到内存的时间损耗,而 CPU 成本则涵盖了读取记录、检测记录是否满足搜索条件以及对结果集进行排序等操作所消耗的时间 。
在多表连接场景中,MySQL优化器同样依据成本估算来确定连接顺序和连接方法。它会计算不同连接顺序下的I/O和CPU成本,选择总成本最低的方案。例如,对于嵌套循环连接,优化器会考虑驱动表与被驱动表的扫描成本;对于哈希连接,会预估构建哈希表和探测哈希表的成本。这种细致的成本计算,使得MySQL在多表查询优化上也能基于数据特征做出相对合理的执行计划选择。
举一个具体例子,假设有两个表orders和customers,我们想要执行一个连接查询SELECT * FROM orders JOIN customers ON orders.customer_id = customers.customer_id WHERE orders.order_date > '2024-01-01';。
在 MySQL 中,优化器基于成本模型估算时,会考虑表的统计信息,如orders表和customers表的行数、索引基数等。如果orders表有一个关于order_date和customer_id的复合索引,MySQL 优化器会计算通过该索引扫描表并进行连接的成本,以及全表扫描后再连接的成本,最终选择成本较低的执行计划。例如,若索引扫描的成本估算为 100,全表扫描后连接的成本估算为 300,优化器就会选择索引扫描的方式。
而 PostgreSQL 在处理同样的查询时,优化器除了考虑类似的成本因素外,还会运用启发式优化规则。比如,如果customers表相对较小,PostgreSQL 可能会采用嵌套循环连接(Nested Loop Join),即使这种方式在成本模型下的计算成本可能略高于哈希连接(Hash Join),但由于启发式规则认为小表嵌套循环连接的实际执行效率可能更高,所以会优先选择该策略 。
统计信息的作用
准确的统计信息对于 MySQL 优化器至关重要。这些统计信息包括表的行数、索引的选择性(Cardinality)、数据分布等。优化器通过这些信息来估计不同执行计划的成本。例如,在选择索引时,优化器会根据索引的选择性来判断使用该索引是否能降低查询成本。如果索引的选择性高,意味着通过该索引能够快速定位到较少的记录,从而减少 I/O 和 CPU 的消耗。
MySQL 提供了ANALYZE TABLE语句来更新表和索引的统计信息。官方文档明确指出,定期执行该语句可以确保优化器获取到最新、最准确的统计数据,从而做出更合理的执行计划选择。实际应用中,若统计信息陈旧,可能导致优化器选择错误的执行计划,例如在索引选择性变差时仍选择使用低效索引。
成本估算示例
假设有一个查询需要从一个包含大量记录的表中检索数据。表上存在多个索引,优化器会分别计算使用不同索引以及全表扫描的成本。例如,对于一个使用普通索引的查询,优化器需要考虑范围读取二级索引的 CPU 成本、回表的 I/O 成本以及在聚簇索引中再次排查其他条件的 CPU 成本。通过综合计算这些成本,优化器可以确定哪种执行方案最为高效。
以 MySQL 8.0 的执行计划分析工具EXPLAIN为例,它能够展示优化器选择的执行计划以及相关的成本估算数据 。在实际应用中,MySQL 的成本估算机制在大多数情况下能够有效地选择出性能较好的执行计划,尤其是在数据分布较为均匀、查询模式相对简单的场景中表现出色。
PostgreSQL 优化器启发式优化
PostgreSQL 的优化器不仅仅依赖于成本估算,还支持多种复杂的启发式优化技术。启发式优化是基于经验法则和策略来选择执行计划,它可以在某些情况下快速找到一个可行且性能不错的执行计划,而无需对所有可能的计划进行详尽的成本估算。
并行查询规划
并行查询是 PostgreSQL 启发式优化的一个重要体现。在多核处理器的现代硬件环境下,并行查询允许查询在多个 CPU 核心或处理器上同时执行,从而显著提升查询性能,特别是在处理大型数据集时。
根据PostgreSQL 16 官方文档,当查询优化器决定并行查询是最佳执行策略时,它会构建一个包含Gather或Gather Merge节点的查询计划。这些节点负责管理并行任务的收集和整合工作。具体来说,查询计划中的Gather或Gather Merge节点具有一个子节点,该子节点对应的部分将被并行执行。如果此节点位于计划的顶层,整个查询将并行运行;否则,仅该节点下的部分并行执行。
在执行过程中,主进程会启动指定数量的后台工作者进程(受max_parallel_workers_per_gather参数限制)来执行并行计划部分。主进程(领导者)也会参与执行,但主要职责是收集和处理工作者产生的数据。Gather Merge节点用于当并行部分按排序顺序产生结果时,领导者执行保持排序的合并操作;而Gather节点则不保证排序,从工作者接收数据而不保留原有排序。
其他启发式优化技术
除了并行查询,PostgreSQL 还支持查询重写、连接方法选择等启发式优化技术。查询重写系统可以将视图展开为基础表查询、处理规则系统中定义的重写规则,并将查询转换成更简化或更合适的形式。在连接方法选择方面,优化器会根据表的大小、索引情况以及查询条件等因素,智能地选择嵌套循环连接、哈希连接或合并连接等不同的连接方法,以达到最优的执行效果。
PostgreSQL 官方文档详细介绍了这些优化技术的工作原理和适用场景。例如,在处理小表与大表连接时,嵌套循环连接可能更高效;而对于两个较大的表,哈希连接通常能提供更好的性能。
评论区