




我们的风格是参照官网的文档来聊聊
https://dev.mysql.com/doc/refman/8.0/en/storage-engines.html
https://dev.mysql.com/doc/refman/8.0/en/innodb-architecture.html
InnoDB 的整体架构
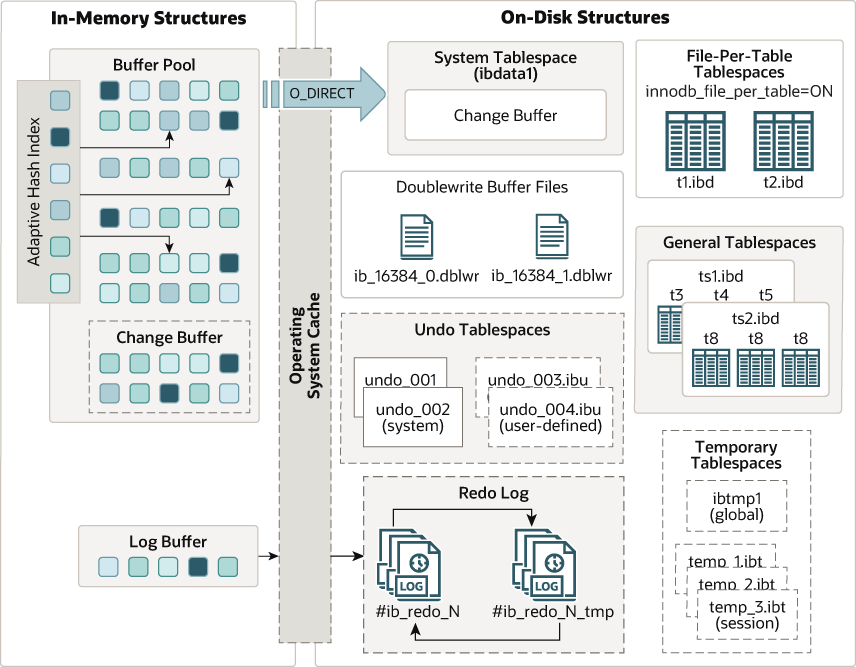
图片来源官网,记得在2年前我就看到过,当时没有在意,今天我们详细讨论一下。
通过官网的下图,我们可以清晰的看到,整个innodb的架构 官方分为了 内存结构 和 磁盘结构。
本章节 我们讨论 左侧的 in-memory structures
https://dev.mysql.com/doc/refman/8.0/en/innodb-architecture.html
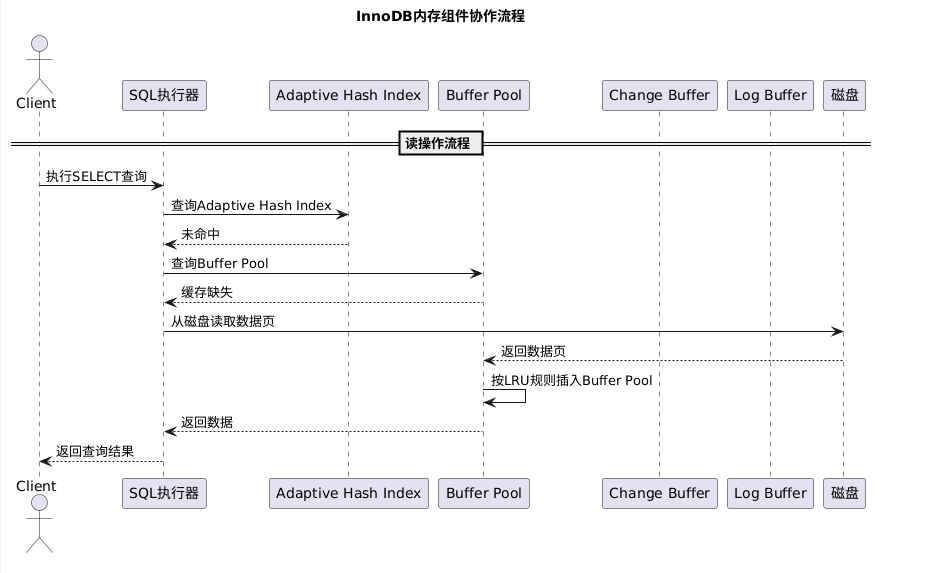
这是我用drawio画的图,虽不美观,但足以说明问题
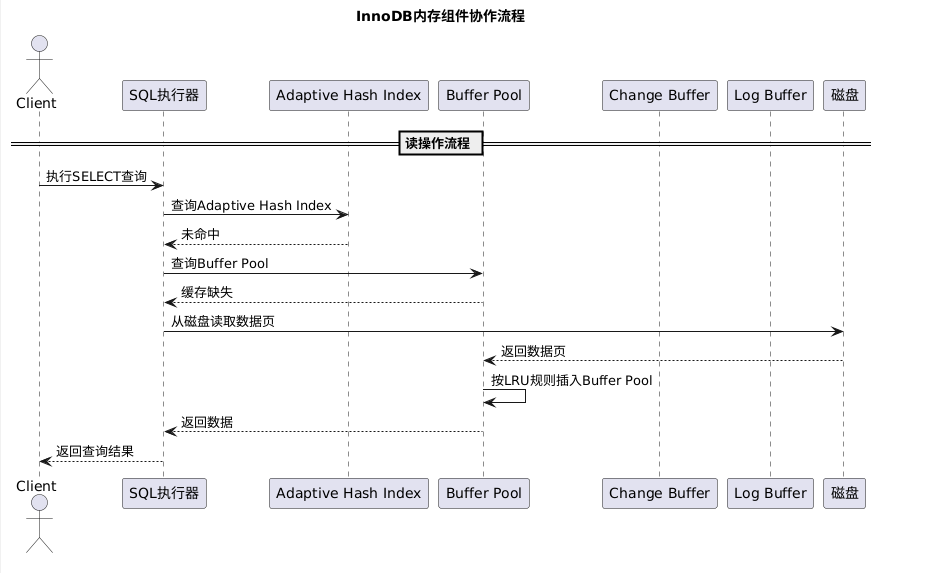
读流程
写流程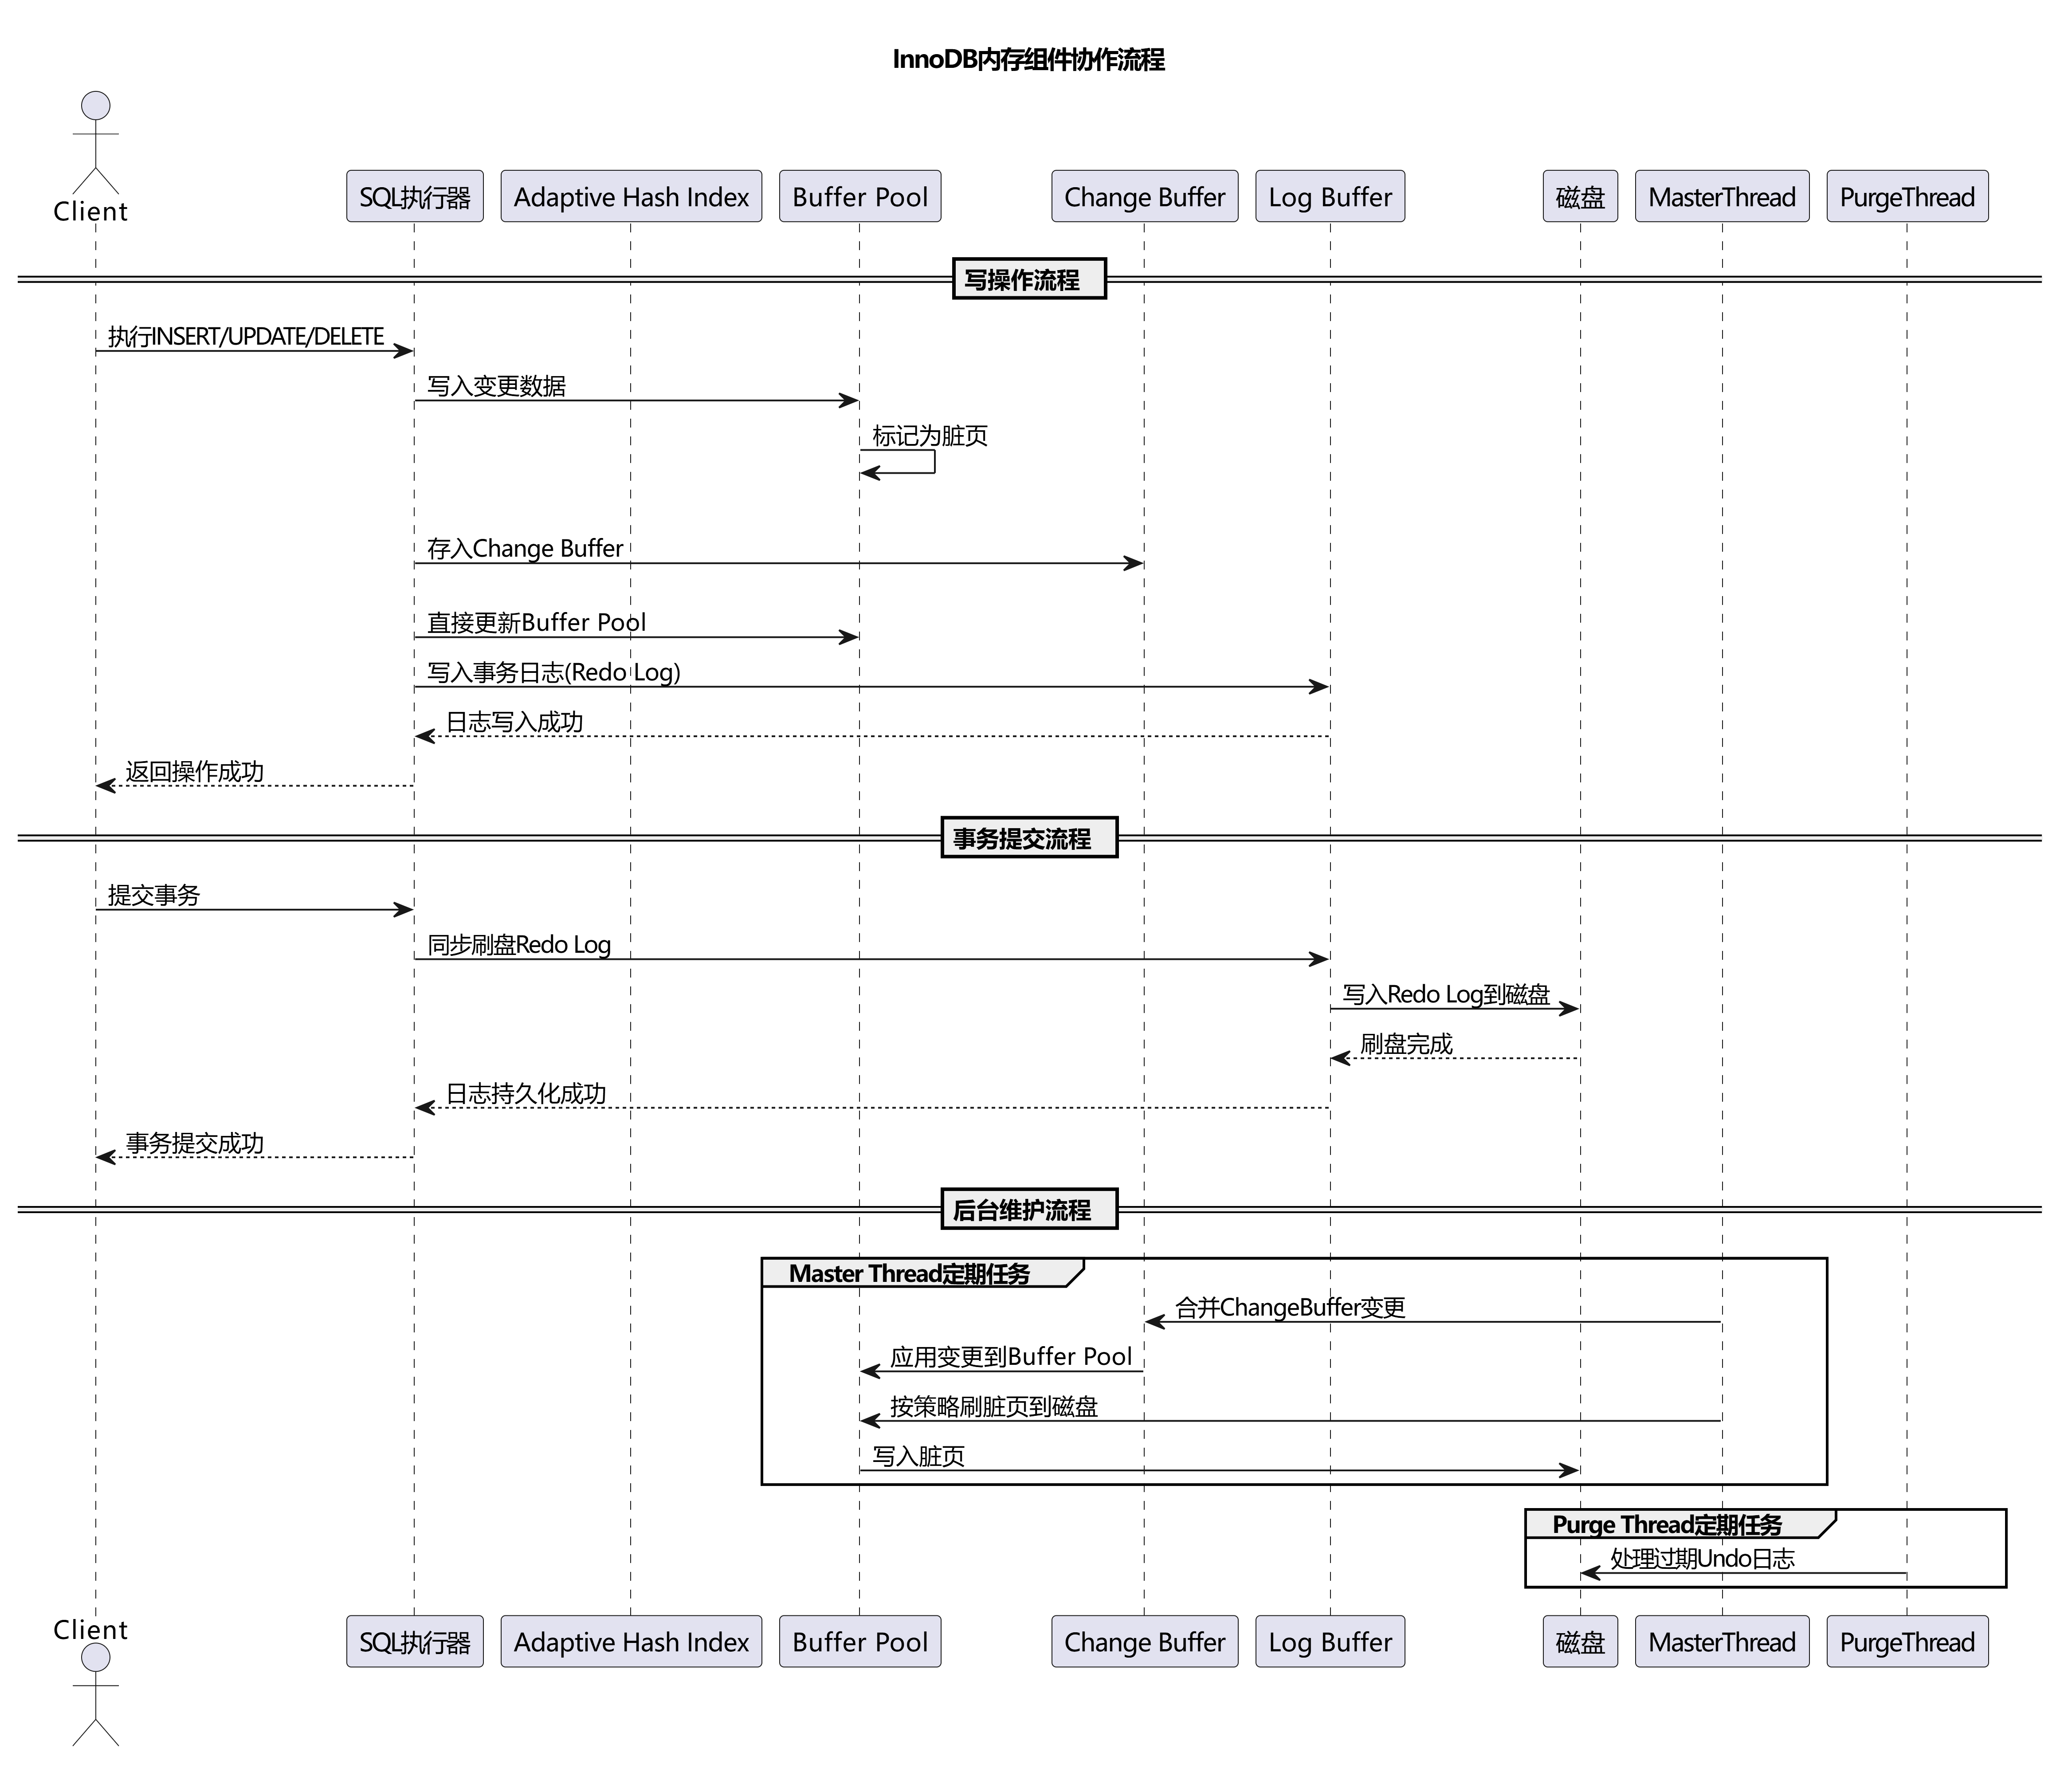
我们可以看到 在 InnoDB 存储引擎的内存架构中,左侧内存结构 中包含了 Buffer Pool 和 Change Buffer
我们先聊聊 Buffer Pool 与 Change Buffer 的作用及关系
还是先看官方文档进行解析,本次我们还是基于这两篇官方文档来看
一、Buffer Pool:数据读取的 “高速通道”
官方文档 https://dev.mysql.com/doc/refman/8.0/en/innodb-in-memory-structures.html
咱们一起从官方文档出发,解析InnoDB内存结构中Buffer Pool等组件的定义、工作机制、配置及监控方式,展现各组件在提升数据库性能中的作用。
InnoDB作为MySQL的核心存储引擎,其内存结构设计直接决定了数据库的读写性能与稳定性。官方文档中定义的四大内存组件——Buffer Pool、Change Buffer、Adaptive Hash Index和Log Buffer,通过精密协作实现了数据访问的高效调度。以下基于MySQL 8.0官方文档,深入解析各组件的技术细节与优化实践。
17.5.1 Buffer Pool数据缓存的核心枢纽
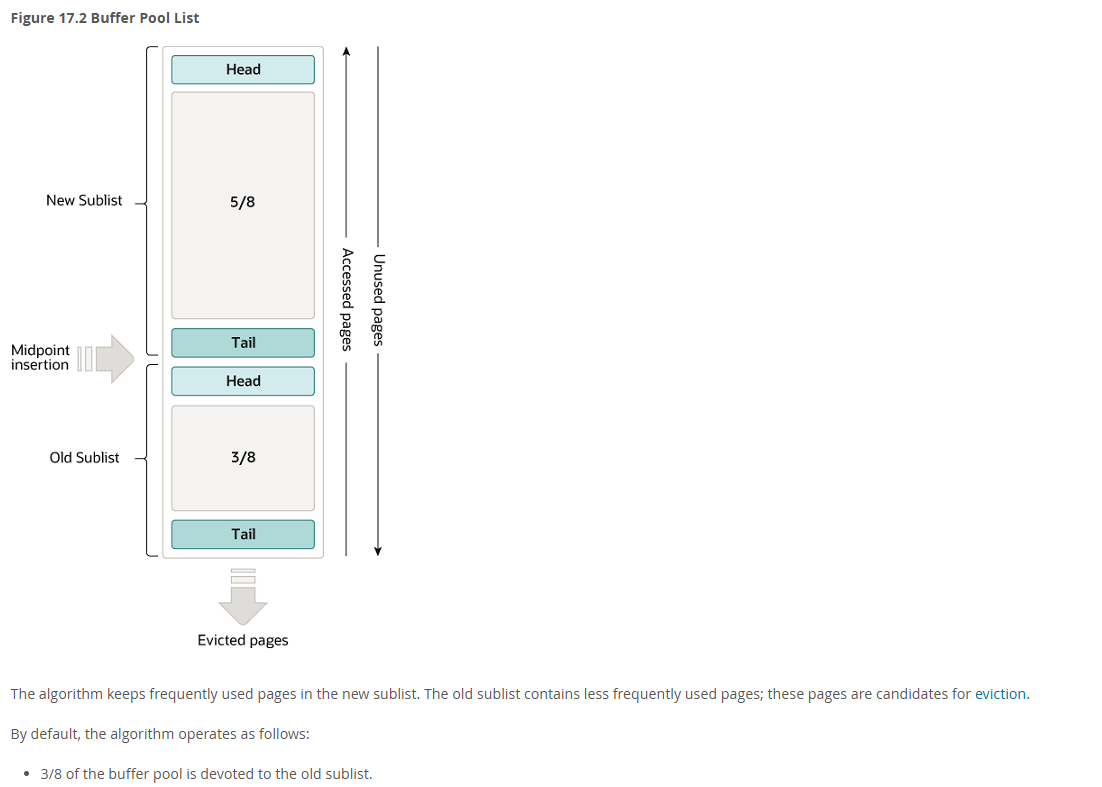
图 17.2 缓冲池列表
Buffer Pool 的 LRU 算法
缓冲池采用 LRU(最近最少使用)算法的变种以列表形式管理。当需要向缓冲池添加新页时,最近最少使用的页会被淘汰,新页则插入到列表中间位置。这种中点插入策略将列表划分为两个子列表:
列表头部:存储近期访问过的“新(young)”页子列表
列表尾部:存储近期较少访问的“旧”页子列表
该算法会将频繁访问的页保留在新子列表中,旧子列表则包含使用频率较低的页,这些页可能被优先淘汰。
默认情况下,算法遵循以下规则:
缓冲池的 3/8 分配给旧子列表。
列表中点是新子列表尾部与旧子列表头部的分界点。
当 InnoDB 将页读取到缓冲池时,会先将其插入到中点位置(旧子列表头部)。页的读取可能由用户操作(如 SQL 查询)触发,或作为 InnoDB 自动预读操作的一部分。
旧子列表中的页被访问时:会被标记为“年轻”并移动到新子列表头部。
若页因用户操作被读取,首次访问会立即触发,页直接晋升为“年轻”状态。
若页因预读操作被读取,首次访问不会立即触发,甚至可能在被淘汰前都未被访问。
随着数据库运行,缓冲池中未被访问的页会逐渐“老化”——向列表尾部移动。新子列表和旧子列表中的页都会因其他页的插入和访问而持续老化。
核心机制与LRU算法演进
Buffer Pool是InnoDB内存中用于缓存表数据和索引页的核心区域,官方文档明确指出:"The buffer pool is an area in main memory where InnoDB caches table and index data as it is accessed",其设计目标是通过内存缓存减少磁盘I/O。为解决传统LRU算法在表扫描场景下的"缓存污染"问题,InnoDB采用了改进型LRU策略:将Buffer Pool划分为"年轻"和"老旧"两个子列表,默认3/8的空间分配给老旧子列表。当新数据页加载时,首先插入到老旧子列表头部,只有在短时间内被再次访问才会晋升为年轻页,这种机制有效防止了全表扫描时大量冷数据驱逐热数据的情况。
动态配置与性能优化
官方文档提供了完整的Buffer Pool配置体系详细配置参考【https://dev.mysql.com/doc/refman/8.0/en/innodb-buffer-pool-resize.html】
大小配置:通过
innodb_buffer_pool_size参数设置,理论上专用服务器可分配至物理内存的80%,例如SET GLOBAL innodb_buffer_pool_size = 16G多实例分割:在64位系统中,可通过
innodb_buffer_pool_instances参数将大Buffer Pool拆分为多个实例(如8个),减少并发访问时的互斥锁竞争抗扫描优化:通过
innodb_old_blocks_pct调整老旧子列表比例,配合innodb_old_blocks_time设置访问延迟(默认1000ms),防止预读数据过早晋升状态持久化:启用
innodb_buffer_pool_load_at_startup和innodb_buffer_pool_save_at_shutdown参数,避免服务器重启后的缓存预热开销
InnoDB 存储引擎中的 Buffer Pool(缓冲池) 是 MySQL 数据库性能优化的核心组件,其本质是一块内存区域,主要用于缓存表数据和索引页。以下是其具体作用及工作机制的详细说明:
1.核心作用:减少磁盘 I/O,加速数据访问
数据缓存与读写加速
当 MySQL 读取数据时,会先将磁盘中的数据页加载到 Buffer Pool 中,后续相同数据的访问直接从内存获取,避免重复磁盘 I/O。
写入数据时,先修改 Buffer Pool 中的数据页(称为“脏页”),再由后台线程异步刷新到磁盘,实现“延迟写”,减少磁盘随机写入次数。
提升查询与事务性能
高频访问的数据长期驻留在 Buffer Pool 中,显著降低查询响应时间,尤其对 OLTP(联机事务处理)场景效果显著。
事务提交时,仅需确保日志(redo log)落盘,数据页可延迟刷新,提升事务提交效率。
2.关键工作机制与优化设计
缓存管理策略
LRU(最近最少使用)算法变种:将 Buffer Pool 分为“热数据区”(young sublist)和“老旧数据区”(old sublist),通过参数
innodb_old_blocks_pct和innodb_old_blocks_time防止全表扫描等操作将非热点数据挤入热区。预读机制:当访问连续数据时,提前加载相邻页到 Buffer Pool,减少后续 I/O。
多实例分割(Buffer Pool Instances)
通过参数
innodb_buffer_pool_instances将大缓冲池拆分为多个独立实例,每个实例拥有独立的锁结构,避免高并发场景下的锁竞争(如互斥锁 mutex 冲突),提升并行访问效率。
自适应哈希索引(Adaptive Hash Index)
自动为高频访问的数据页创建哈希索引,加速内存中数据的查找,类似缓存的“索引层”,进一步减少查询时间。
3.与其他组件的协同作用
与 redo log 的配合
数据修改先记录到 redo log,再更新 Buffer Pool,确保事务提交的持久性(即使 Buffer Pool 中的脏页未刷新到磁盘,重启后可通过 redo log 恢复)。
与 Checkpoint 机制的配合
后台线程定期将 Buffer Pool 中的脏页刷新到磁盘(Checkpoint),控制 redo log 的增长,并释放内存空间给新数据。
4.性能影响与配置建议
大小配置:专用服务器建议分配物理内存的 60%~80%,通过
innodb_buffer_pool_size设置,需为innodb_buffer_pool_chunk_size * innodb_buffer_pool_instances的倍数。命中率监控:通过
SHOW ENGINE INNODB STATUS查看Buffer pool hit rate,理想值应高于 95%,否则需增大缓冲池或优化查询。状态持久化:启用
innodb_buffer_pool_load_at_startup和innodb_buffer_pool_save_at_shutdown,避免重启后的缓存预热开销。
17.5.2 Change Buffer写操作的I/O优化器
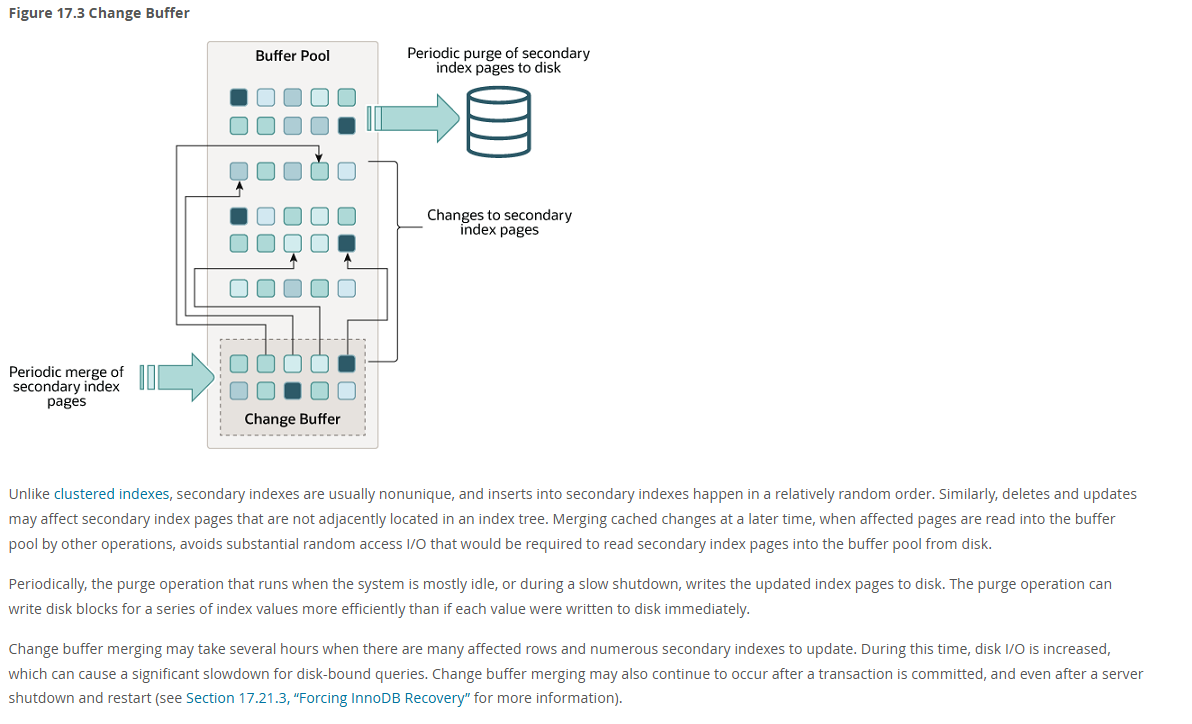
Change Buffer作为Buffer Pool的特殊组成部分,官方文档定义其为:"a special data structure that caches changes to secondary index pages when those pages are not in the buffer pool"。当对非唯一二级索引进行DML操作时,若目标索引页不在内存中,InnoDB不会立即读取磁盘,而是将变更记录在Change Buffer中,待后续索引页被访问时再合并更新。这种机制特别适合写密集型场景,例如批量导入数据时可减少高达90%的随机I/O操作。
Change Buffer 的核心机制与作用详解
官方定义与设计初衷
根据 MySQL 官方文档,Change Buffer 是 Buffer Pool 中的特殊数据结构,专门用于缓存对非唯一二级索引页的变更操作。当目标索引页不在内存中时,InnoDB 不会立即读取磁盘,而是将变更暂存于 Change Buffer,待后续索引页被访问时再合并更新。这一设计的核心目标是减少写密集型场景下的随机磁盘 I/O,提升数据库写入性能。
1. 工作原理:延迟合并与写操作优化
非唯一索引的“写缓冲”机制
当对非唯一二级索引执行 DML(插入、更新、删除)操作时,若索引页不在 Buffer Pool 中:
传统流程:需先从磁盘读取索引页到内存,再修改页面,产生两次磁盘 I/O(读+写)。
Change Buffer 流程:直接将变更记录在 Change Buffer 中,跳过磁盘读取步骤,仅在索引页被访问时合并变更并刷新磁盘,将多次 I/O 合并为一次。
典型场景:批量数据导入
例如导入 10 万条数据时,若二级索引页均不在内存中,传统方式需 20 万次磁盘 I/O(每次操作读+写);使用 Change Buffer 可将 I/O 次数减少至约 1 万次(仅当索引页被访问时合并更新),降幅可达 90%。
2. 关键特性与限制条件
适用索引类型
仅支持非唯一二级索引(唯一索引因需校验唯一性,必须实时读取磁盘页)。
主键索引(聚簇索引)的变更直接更新 Buffer Pool 中的页面,不经过 Change Buffer。
内存占用与刷新策略
Change Buffer 占用 Buffer Pool 的内存空间,通过参数
innodb_change_buffer_max_size控制其最大比例(默认 25%,最大 50%)。刷新触发条件:
索引页被访问时(主动触发合并);
后台线程定期刷新(如 Master Thread 周期性操作);
Buffer Pool 内存不足时,优先刷新 Change Buffer 中的脏页。
性能收益的前提条件
写入操作后,索引页需在短时间内被访问(例如业务查询会触发索引页读取),否则 Change Buffer 中的变更可能长期未合并,失去优化效果。
17.5.3 Adaptive Hash Index:热点查询加速器
自动优化的内存索引
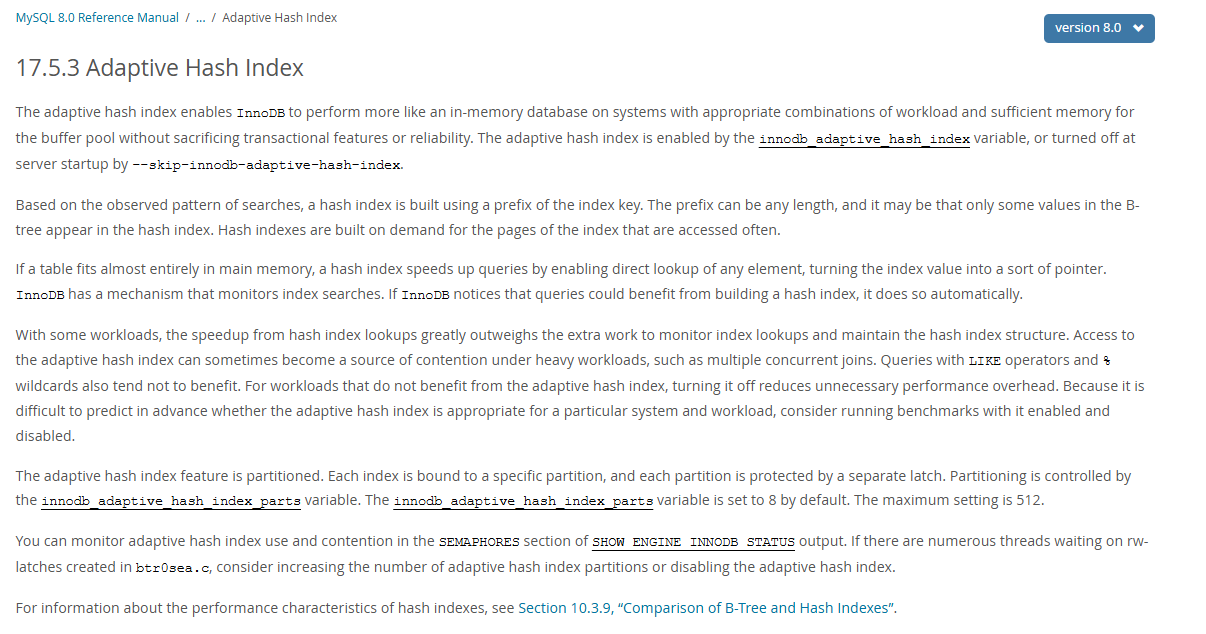
Adaptive Hash Index是InnoDB的智能优化组件,官方文档描述其"automatically creates hash indexes for frequently accessed patterns"。当检测到某个索引键被频繁访问时,会自动在内存中构建哈希索引,将B+树查询的O(logN)复杂度降至O(1)。这种机制无需人工干预,特别适合高频点查场景,如电商系统的商品详情页访问。
动态调整:InnoDB会自动评估哈希索引的性价比,当访问模式变化时会动态删除低效的哈希索引
17.5.4 Log Buffer事务持久化
事务日志的内存缓冲区
Log Buffer用于暂存InnoDB的重做日志(Redo Log),官方文档强调:"changes are first written to the log buffer and then flushed to disk"。事务提交时,日志先写入Log Buffer,再根据innodb_flush_log_at_trx_commit参数的设置(0/1/2)决定何时刷盘。默认值1表示每次提交都同步刷盘,确保事务的持久性,但会有少量性能开销;设置为0时每秒刷盘一次,可提升性能但存在丢失1秒数据的风险。
配置与调优建议
缓冲区大小:通过
innodb_log_buffer_size参数设置,默认16MB,对于大事务场景可增大至64MB或更高,避免频繁刷盘刷盘策略:根据业务一致性需求选择
innodb_flush_log_at_trx_commit值,例如金融系统必须设置为1,而日志系统可设置为2异步刷盘:在Linux系统中启用
innodb_use_native_aio=1,利用内核异步I/O提升刷盘效率
Log flush time:使用
Performance Schema监控日志刷盘耗时,异常高值可能表明磁盘I/O瓶颈
内存组件的协同工作流程
当执行一个典型的读写事务时,四大内存组件的协作流程如下:
读操作:先查询Adaptive Hash Index,未命中则查找Buffer Pool,若缓存缺失则从磁盘读取并按LRU规则插入Buffer Pool
写操作:变更数据写入Buffer Pool标记为脏页,同时对非唯一索引的修改存入Change Buffer,事务日志写入Log Buffer
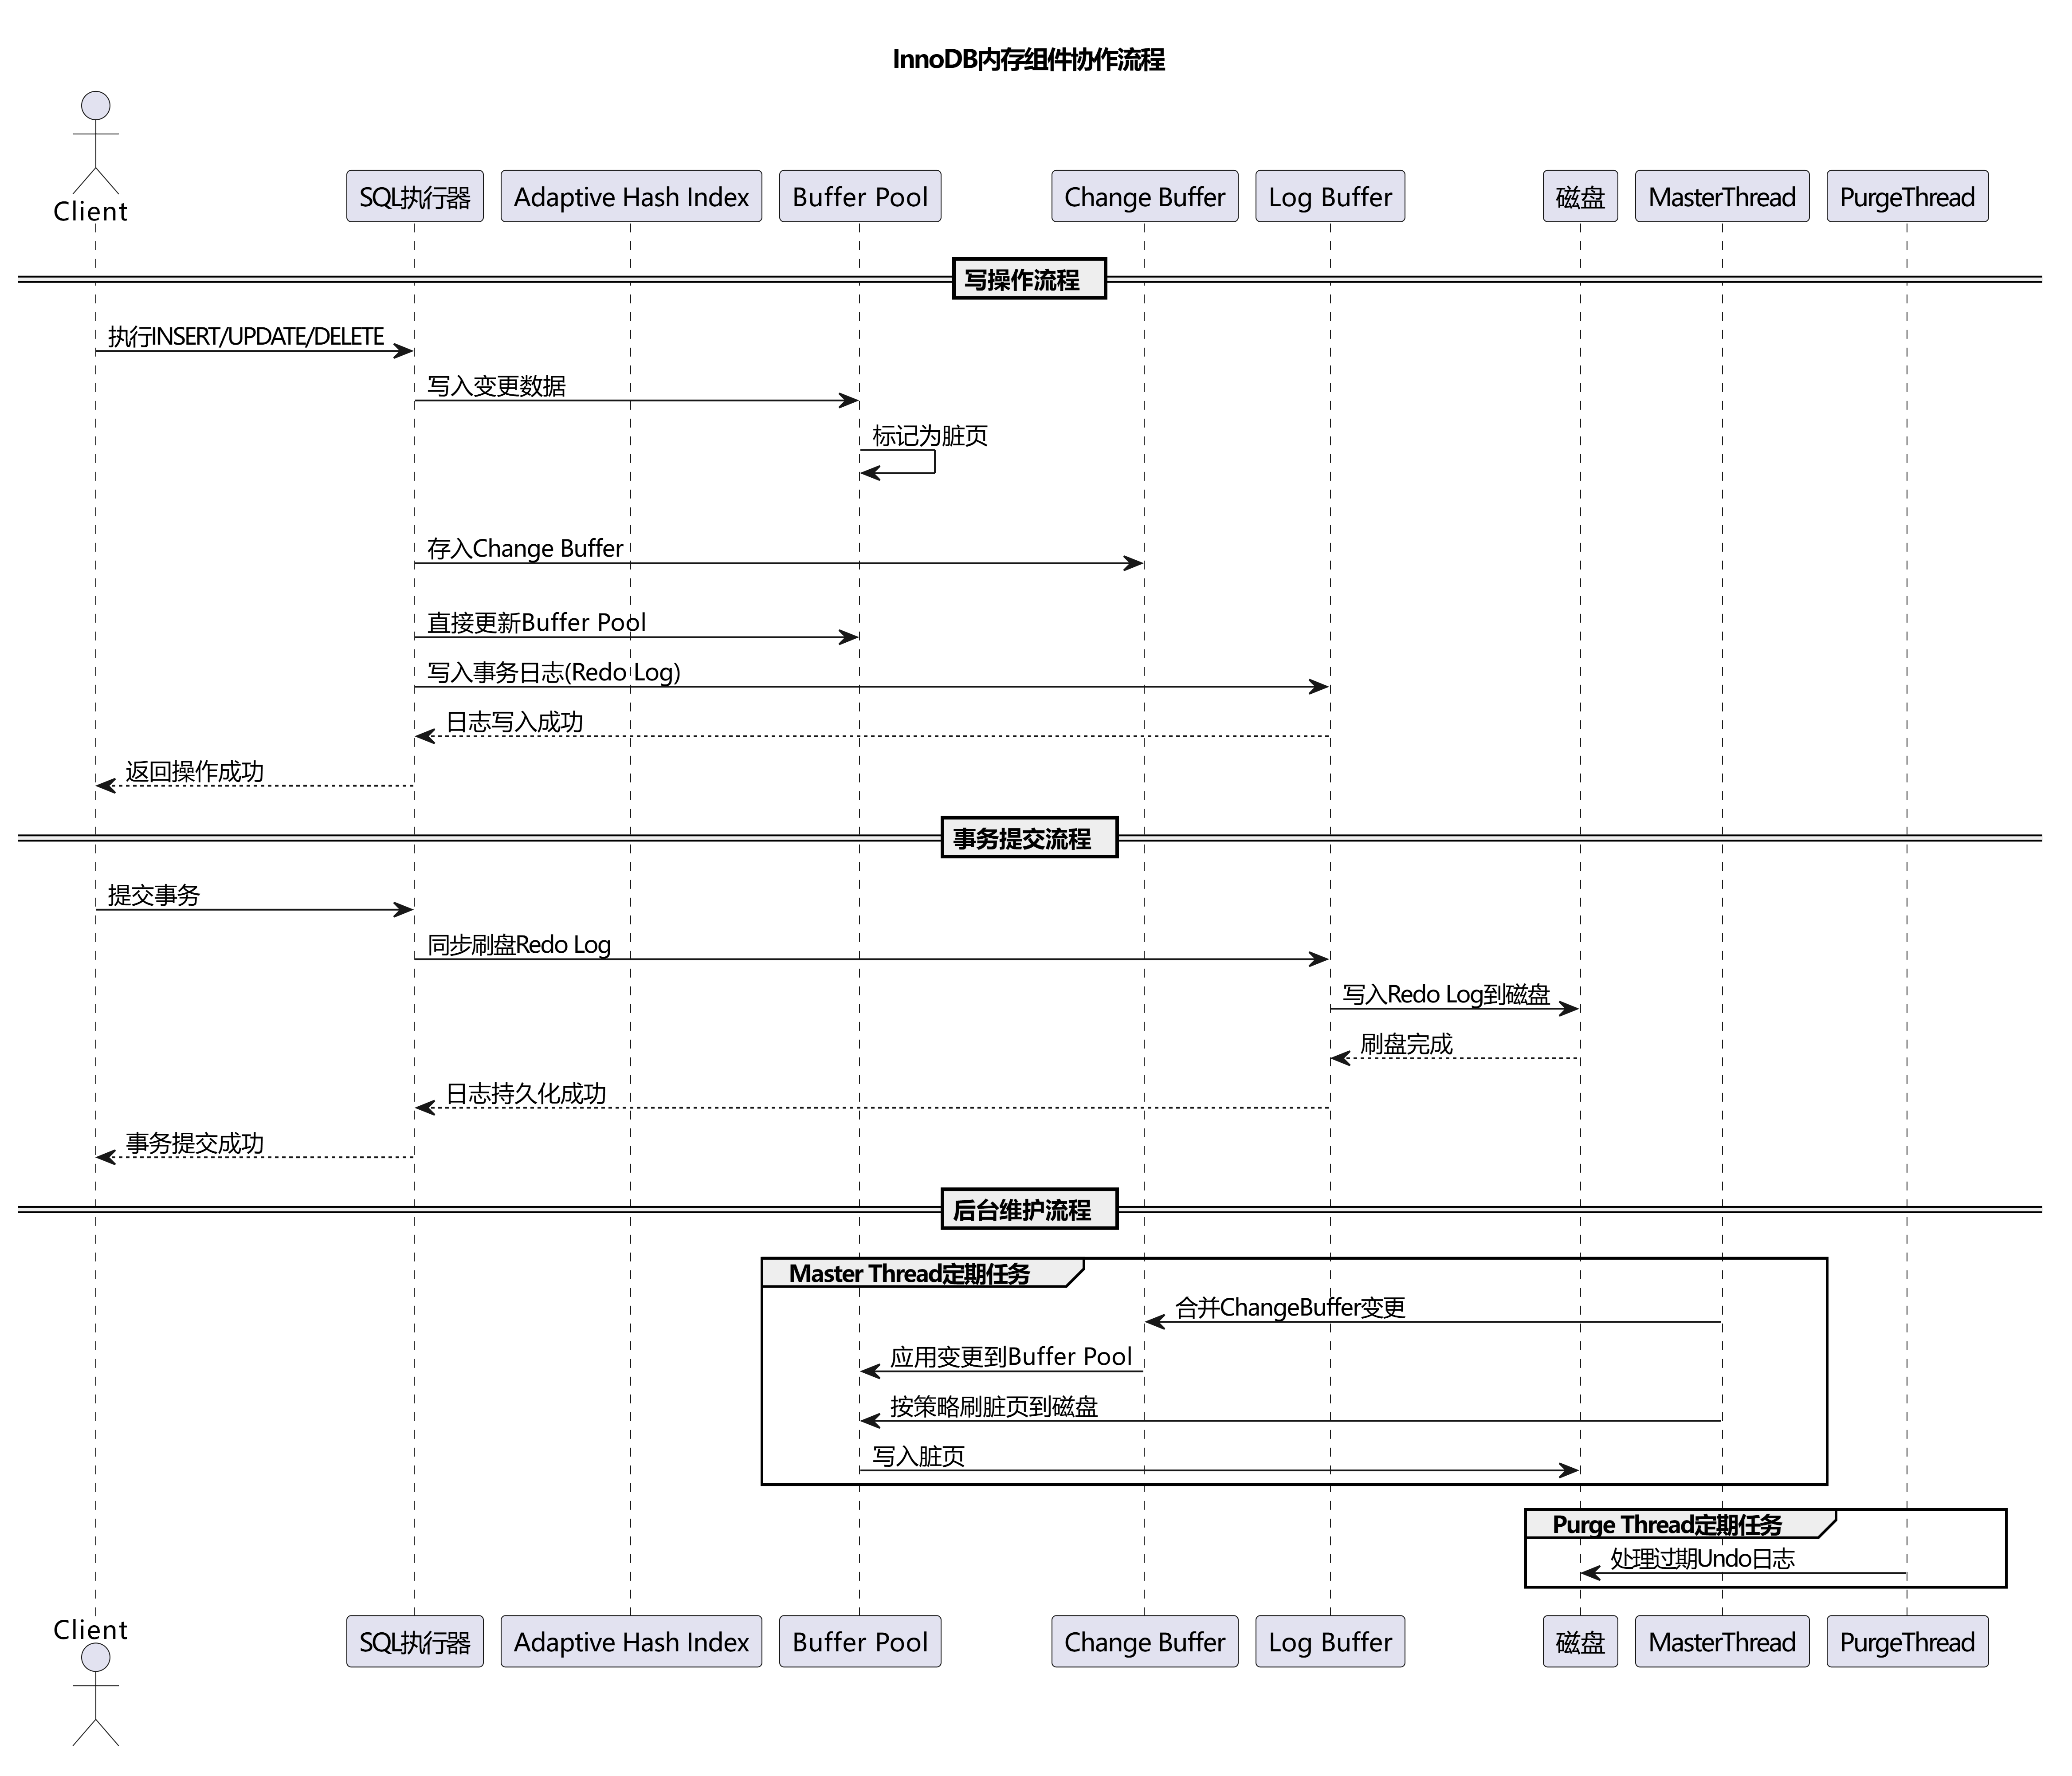
事务提交:Log Buffer中的Redo Log同步刷盘,确保事务持久化
后台维护:Master Thread定期合并Change Buffer变更,将脏页按策略刷盘,Purge Thread处理过期Undo日志
这种设计实现了"计算在内存,持久化在磁盘"的高效模式,通过各组件的分工协作,InnoDB在保证ACID特性的同时,实现了接近内存数据库的性能表现。实际调优时需根据业务场景(OLTP/OLAP)动态调整各组件参数,例如OLTP系统应增大Buffer Pool和Change Buffer,而OLAP系统可优化Adaptive Hash Index和预读参数。
评论区