




一文读懂 Flink:大数据流处理的基石
在大数据技术的浩瀚星空中,Apache Flink 无疑是一颗璀璨的明星,正逐渐成为大数据流处理领域的中流砥柱。今天,就让我们深入剖析,为何 Flink 能在大数据处理的舞台上占据如此重要的地位,以及我们为什么需要学习 Flink。
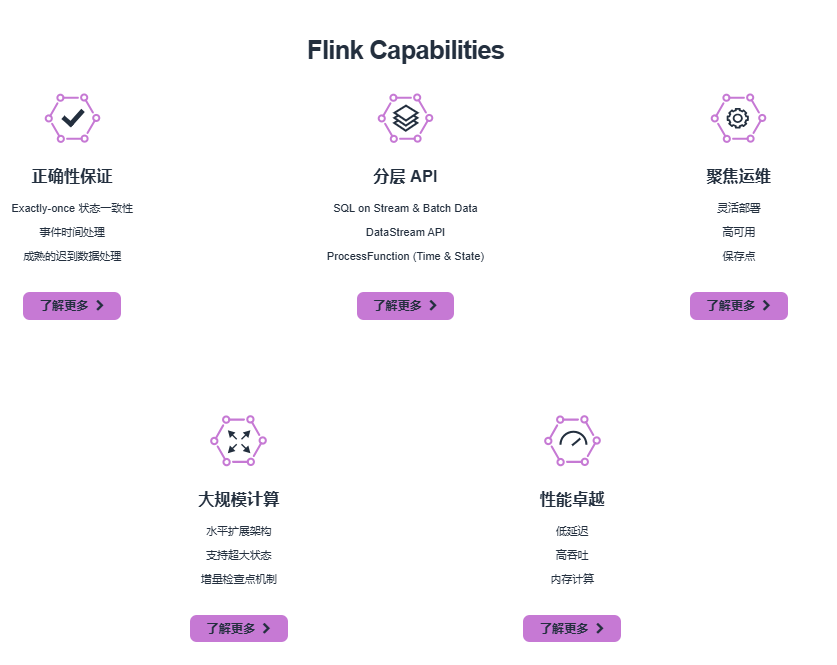
Flink 的诞生与发展
Flink 的起源可以追溯到 2008 年,它最初是由德国柏林工业大学的研究人员开发的一个名为 Stratosphere 的科研项目。经过多年的发展和完善,2014 年 Flink 正式成为 Apache 顶级项目,从此开启了它在大数据领域的辉煌征程。随着大数据技术的不断演进,数据量呈爆炸式增长,对实时处理的需求也日益迫切,Flink 凭借其卓越的流处理能力和对批处理的高效支持,迅速在大数据处理领域崭露头角。
Apache Flink 是什么? #
Apache Flink 是一个框架和分布式处理引擎,用于在无边界和有边界数据流上进行有状态的计算。Flink 能在所有常见集群环境中运行,并能以内存速度和任意规模进行计算。
接下来,我们来介绍一下 Flink 架构中的重要方面。
处理无界和有界数据 #
任何类型的数据都可以形成一种事件流。信用卡交易、传感器测量、机器日志、网站或移动应用程序上的用户交互记录,所有这些数据都形成一种流。
数据可以被作为 无界 或者 有界 流来处理。
无界流 有定义流的开始,但没有定义流的结束。它们会无休止地产生数据。无界流的数据必须持续处理,即数据被摄取后需要立刻处理。我们不能等到所有数据都到达再处理,因为输入是无限的,在任何时候输入都不会完成。处理无界数据通常要求以特定顺序摄取事件,例如事件发生的顺序,以便能够推断结果的完整性。
有界流 有定义流的开始,也有定义流的结束。有界流可以在摄取所有数据后再进行计算。有界流所有数据可以被排序,所以并不需要有序摄取。有界流处理通常被称为批处理
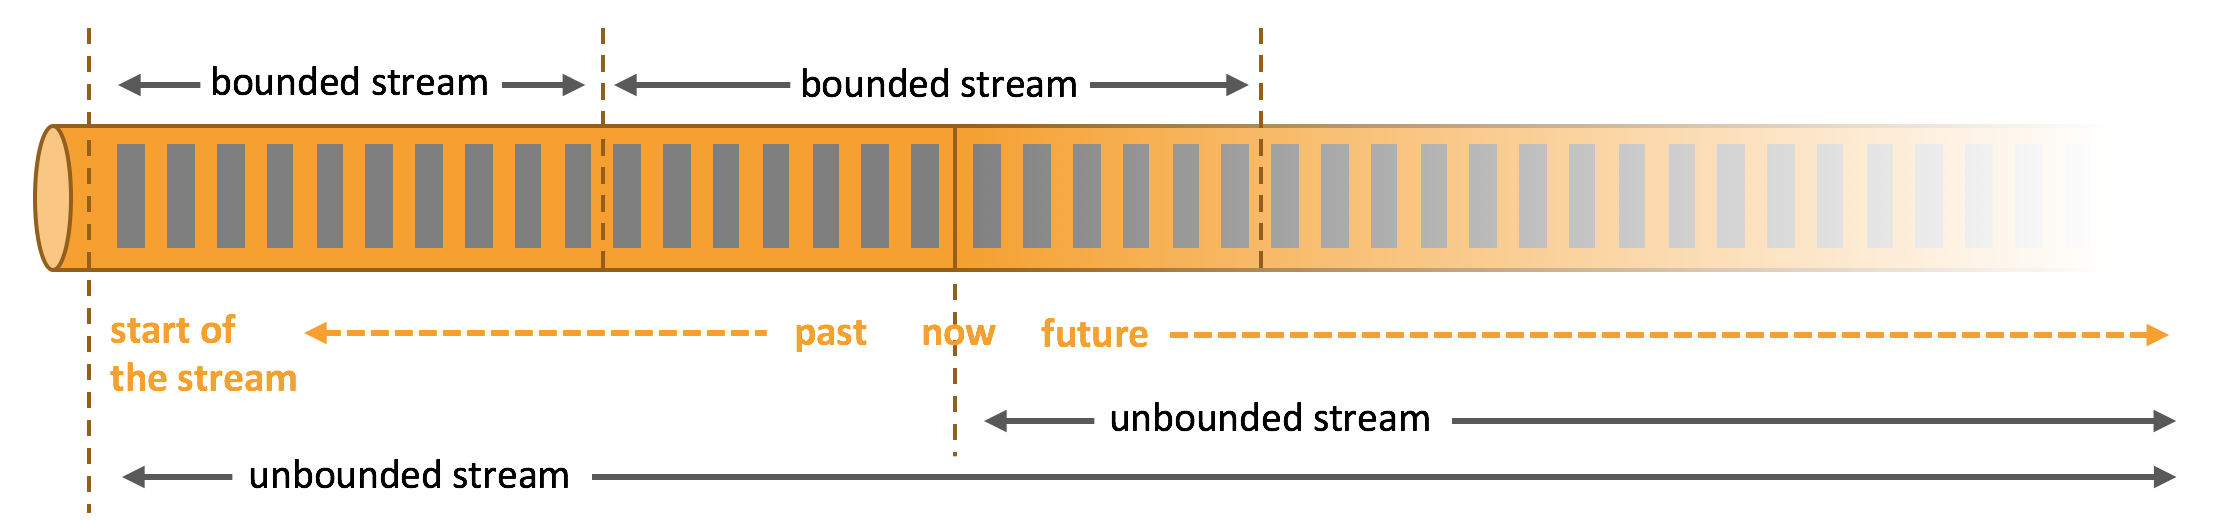
Apache Flink 擅长处理无界和有界数据集 精确的时间控制和状态化使得 Flink 的运行时(runtime)能够运行任何处理无界流的应用。有界流则由一些专为固定大小数据集特殊设计的算法和数据结构进行内部处理,产生了出色的性能。
通过探索 Flink 之上构建的 用例 来加深理解。
部署应用到任意地方 #
Apache Flink 是一个分布式系统,它需要计算资源来执行应用程序。Flink 集成了所有常见的集群资源管理器,例如 Hadoop YARN、 Apache Mesos 和 Kubernetes,但同时也可以作为独立集群运行。
Flink 被设计为能够很好地工作在上述每个资源管理器中,这是通过资源管理器特定(resource-manager-specific)的部署模式实现的。Flink 可以采用与当前资源管理器相适应的方式进行交互。
部署 Flink 应用程序时,Flink 会根据应用程序配置的并行性自动标识所需的资源,并从资源管理器请求这些资源。在发生故障的情况下,Flink 通过请求新资源来替换发生故障的容器。提交或控制应用程序的所有通信都是通过 REST 调用进行的,这可以简化 Flink 与各种环境中的集成。
运行任意规模应用 #
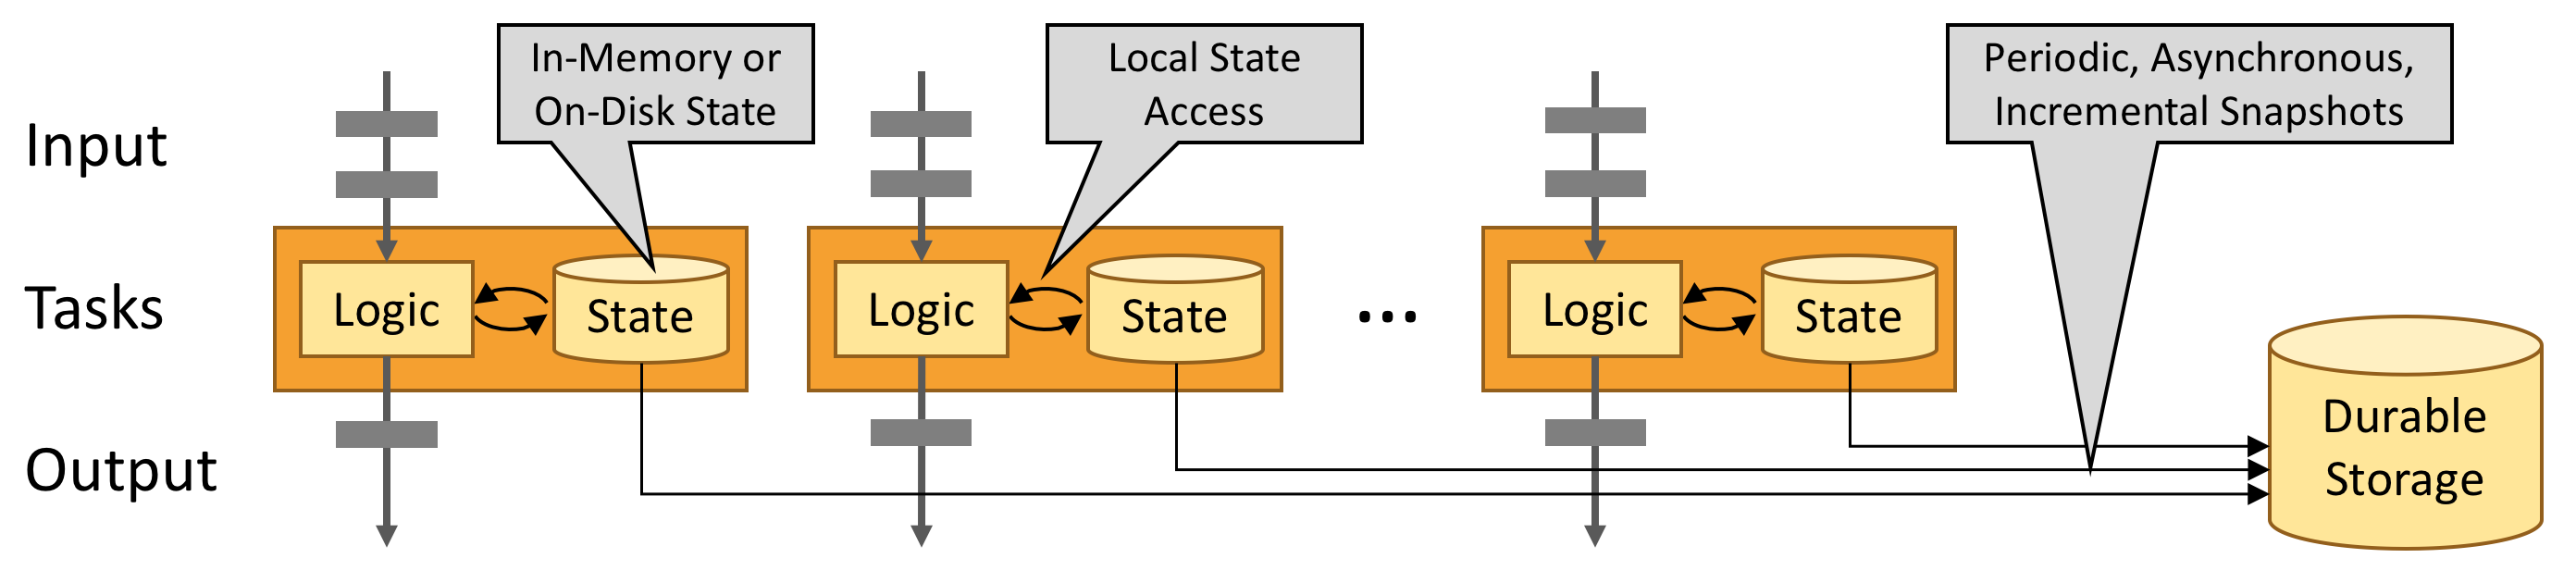
Flink 旨在任意规模上运行有状态流式应用。因此,应用程序被并行化为可能数千个任务,这些任务分布在集群中并发执行。所以应用程序能够充分利用无尽的 CPU、内存、磁盘和网络 IO。而且 Flink 很容易维护非常大的应用程序状态。其异步和增量的检查点算法对处理延迟产生最小的影响,同时保证精确一次状态的一致性。
Flink 用户报告了其生产环境中一些令人印象深刻的扩展性数字
处理每天处理数万亿的事件,
应用维护几TB大小的状态, 和
应用在数千个内核上运行。
利用内存性能 #
有状态的 Flink 程序针对本地状态访问进行了优化。任务的状态始终保留在内存中,如果状态大小超过可用内存,则会保存在能高效访问的磁盘数据结构中。任务通过访问本地(通常在内存中)状态来进行所有的计算,从而产生非常低的处理延迟。Flink 通过定期和异步地对本地状态进行持久化存储来保证故障场景下精确一次的状态一致性。
Flink 的核心特性
1. 真正的流批一体化
与传统的大数据处理框架将批处理和流处理视为两种不同的模式不同,Flink 从底层架构上就实现了流批一体化。在 Flink 中,批处理只是流处理的一种特殊情况,即有界流处理。这种设计理念使得 Flink 能够使用统一的 API 和执行引擎来处理批量数据和实时流数据,大大简化了开发和运维的复杂度。例如,无论是处理历史订单数据的批量分析,还是实时监控用户的订单行为,Flink 都能以高效且一致的方式完成任务。
2. 强大的状态管理
在流处理中,状态管理是至关重要的。Flink 提供了丰富且灵活的状态管理机制,包括键控状态(Keyed State)和算子状态(Operator State)。键控状态允许用户根据数据的键(Key)来管理和访问状态,非常适合处理需要按特定键进行聚合或统计的场景。而算子状态则是与算子实例相关联的状态,常用于实现一些特殊的功能,如分布式快照(Checkpoint)。通过强大的状态管理,Flink 能够准确地处理乱序数据,保证数据的一致性和准确性。
3. 精确的时间语义
在大数据流处理中,时间是一个关键因素。Flink 支持三种时间语义:事件时间(Event Time)、摄入时间(Ingestion Time)和处理时间(Processing Time)。事件时间是指数据产生的时间,它能够处理乱序数据,确保即使数据在传输过程中出现延迟,也能按照正确的时间顺序进行处理。摄入时间是指数据进入 Flink 系统的时间,它相对简单,适用于对时间准确性要求不是特别高的场景。处理时间则是指数据在算子中实际被处理的时间,它的性能开销最小,但无法处理乱序数据。Flink 精确的时间语义为开发者提供了极大的灵活性,能够满足各种复杂的业务需求。
4. 高可扩展性和容错性
Flink 采用了分布式架构,能够轻松地扩展到数千个节点,处理海量的数据。同时,Flink 内置了强大的容错机制,通过分布式快照(Checkpoint)技术,Flink 能够在发生故障时快速恢复,保证数据的一致性和作业的连续性。在实际生产环境中,这种高可扩展性和容错性是至关重要的,它能够确保系统在面对高并发和大规模数据时的稳定运行。
Flink 与其他大数据框架的对比
1. Flink vs Spark
Spark 是另一个广受欢迎的大数据处理框架,它以其快速的内存计算和丰富的生态系统而闻名。然而,在流处理方面,Spark Streaming 采用的是微批处理(Micro-Batch Processing)的方式,即将流数据切分成小的批次进行处理。这种方式虽然在一定程度上实现了流处理的功能,但与 Flink 的真正流处理相比,在处理延迟和对乱序数据的处理能力上存在一定的差距。Flink 能够实现毫秒级的处理延迟,并且能够准确地处理乱序数据,这使得它在对实时性要求极高的场景中具有明显的优势。
2. Flink vs Storm
Storm 是最早的大数据流处理框架之一,它以其简单易用和高吞吐量而受到广泛关注。然而,Storm 在状态管理和对复杂业务逻辑的支持方面相对较弱。Flink 不仅提供了强大的状态管理功能,还支持丰富的算子和函数,能够方便地实现复杂的业务逻辑。此外,Flink 的批处理能力也是 Storm 所不具备的,这使得 Flink 在应对多样化的业务需求时更加灵活。
Flink 的应用场景
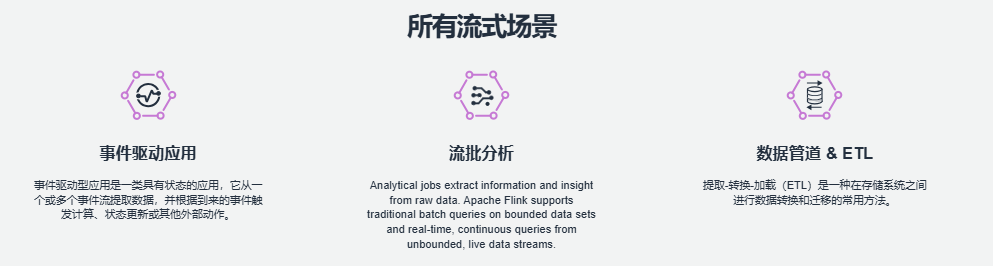
1. 实时数据处理
在当今数字化时代,实时数据处理的需求无处不在。Flink 可以实时处理来自各种数据源的数据,如传感器数据、日志数据、用户行为数据等,并进行实时分析、监控和预警。例如,在金融领域,Flink 可以实时监控交易数据,检测异常交易行为,及时发现潜在的风险。
2. 实时 ETL
ETL(Extract, Transform, Load)是数据处理的重要环节,传统的 ETL 过程通常是离线进行的,无法满足实时性的要求。Flink 可以作为实时 ETL 工具,将来自不同数据源的数据进行实时抽取、转换和加载,为后续的数据分析和应用提供实时的数据支持。
3. 机器学习与人工智能
Flink 与机器学习和人工智能的结合也越来越紧密。通过与机器学习框架(如 TensorFlow、PyTorch 等)的集成,Flink 可以实现实时的模型训练和预测。例如,在推荐系统中,Flink 可以实时处理用户的行为数据,为用户提供个性化的推荐服务。
总结
Apache Flink 以其独特的设计理念、强大的核心特性和广泛的应用场景,成为了大数据流处理领域的基石。无论是在实时数据处理、实时 ETL 还是机器学习与人工智能等领域,Flink 都展现出了卓越的性能和强大的功能。学习 Flink,是顺应时代发展、满足企业需求、提升个人能力的明智之举。如果你还没有尝试过 Flink,那么现在就是一个绝佳的时机,让我们一起踏上 Flink 的探索之旅,领略大数据流处理的魅力!
评论区