




检查点(Checkpoint)
Flink 容错机制的核心部分是对分布式数据流和算子状态绘制一致的快照。(可以理解为算子处理了相同的数据)
原理
检查点是 Flink 容错机制的基础,它是应用程序在某一时刻的状态快照。在流处理过程中,Flink 会定期将每个算子的状态信息保存到可靠存储(如 HDFS、S3 等)中。这些状态信息包括算子的中间计算结果、窗口状态、计数器等。通过这种方式,Flink 可以在故障发生时,从最近的检查点恢复到一致的状态,避免数据丢失和重复计算。
过程
协调器发起:JobManager 中的检查点协调器负责定期触发检查点操作。它会向所有的 TaskManager 发送检查点请求,指定检查点的编号和时间戳。
Barrier 注入:TaskManager 收到检查点请求后,会在输入流中插入特殊的检查点 Barrier。这些 Barrier 会随着数据流向下游传播,将数据流分割成不同的检查点区间。
状态保存:当算子接收到检查点 Barrier 时,它会暂停处理新的数据,并将当前的状态信息保存到指定的存储位置。对于有状态的算子,如窗口算子,会保存窗口内的数据和相关的统计信息。保存完成后,算子会向下游发送包含检查点 Barrier 的消息,表示该算子的状态已经保存。
检查点完成:当所有的算子都完成状态保存后,TaskManager 会向 JobManager 发送确认消息。JobManager 收到所有 TaskManager 的确认消息后,会标记该检查点为完成,并将检查点的元数据信息保存到元数据存储中。
如图所示整个job checkpoint过程
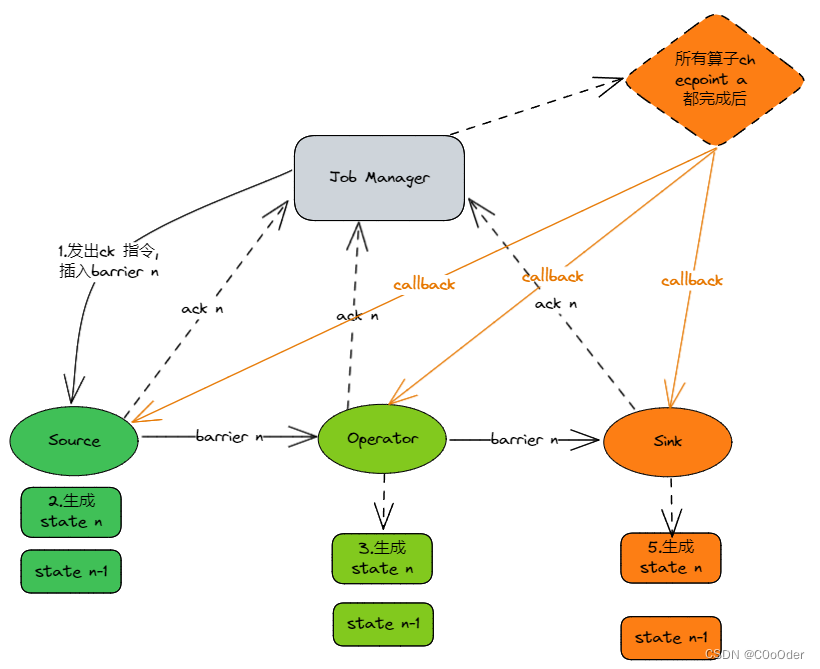
job Manager(CheckpointCoordinator ) 会定期 ( env.enableCheckpointing(2000, CheckpointingMode.EXACTLY_ONCE);)向每个向 Source算子(source task) 发送 start checkpoint命令
Source算子(source task) 收到 start checkpoint命令后,产生barrier 并广播的方式发送到下游,所有task收到 barrier-n 后会本地执行checkpoint-n,本地执行完成后,发送ack-n 到Job Manager
当所有的算子都完成checkpoint-n后,Job Manager 收到了所有节点的 ack-n ,就会向所有算子广播checkpoint-n 全部完成的通知消息;
过程分析
Flink 分布式快照的核心元素是流屏障(barrier ), 这些屏障被注入到数据流中,并作为数据流的一部分和数据记录一起流动.屏障不会超过记录严格,按照顺序流动。屏障将数据流中的记录分为进入当前快照的记录集和进入下一个快照的记录,每个障碍都带有快照的 ID(单调递增),快照的记录被推送到它前面。屏障不会中断流的流动,因此非常轻量级。来自不同快照的多个障碍可以同时在流中,这意味着各种快照可能同时发生.
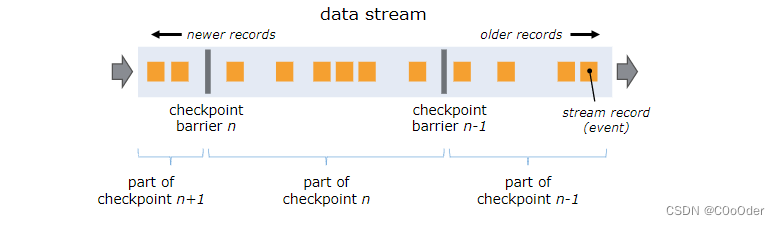
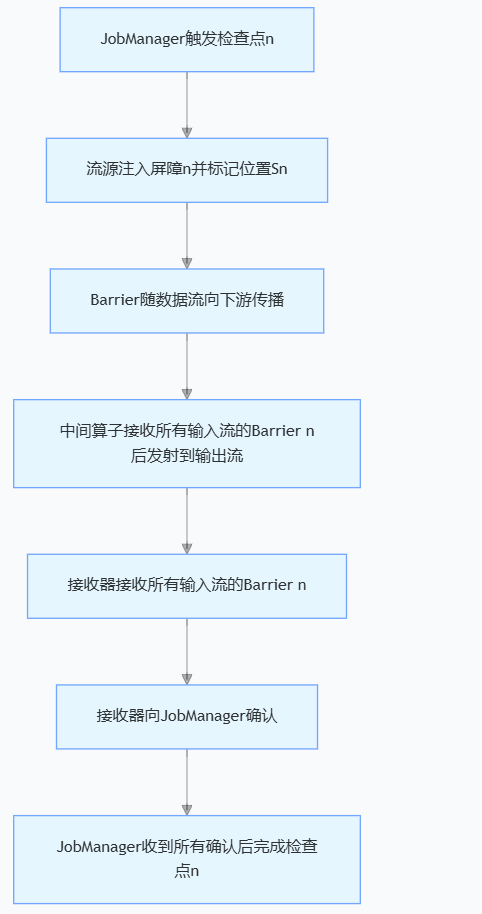
流屏障注入与位置标记
在 Flink 的分布式流处理场景下,流数据从源头(如 Kafka、文件系统等)以并行的方式进入 Flink 作业。当检查点协调器(JobManager)触发创建检查点 n 时,流屏障会被注入到流源的每个并行数据流中。以 Kafka 为例,每个分区都是一个并行数据流,此时在每个分区中会标记一个特定的位置 S n ,该位置对应分区中最后一条被检查点 n 覆盖记录的偏移量。这个偏移量信息至关重要,它明确了检查点所涵盖的数据范围,并且会被报告给 JobManager ,作为后续恢复的关键依据。
流屏障的向下游传播
流屏障一旦注入,就会随着数据流向下游流动。对于中间的算子(Operator)来说,只有当它从所有输入流中都接收到检查点 n 的屏障后,才会将该屏障发射到自身的所有输出流中。这种机制确保了数据处理的顺序性和一致性,保证在同一个检查点内,数据不会出现交叉处理的情况。例如,在一个包含多个转换操作(如过滤、聚合等)的数据流中,每个算子都要等待所有输入流的屏障到齐,才会将屏障传递下去,从而保证每个算子在处理数据时,其输入数据都属于同一个检查点范围。
这个过程也叫做状态点对齐
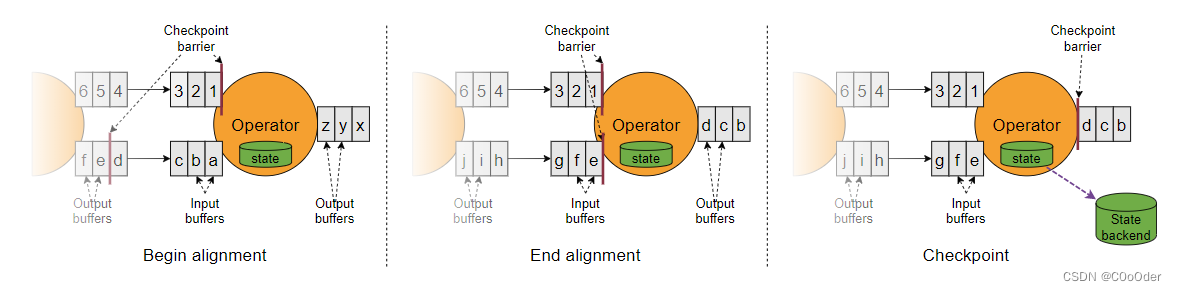
算子接受多个流,每个流里面都有barrier ,需要等所有相同的barrier 到达之后在checkpoint ;
Begin alignment : Operator算子 在收到
654321在1处的checkpoint 快照屏障n 后,它就无法处理来自这个流的其他数据(但是会继续接受数据,数据会被缓存但不会被处理逻辑处理),直到Operator算子的其他输入流也也有 checkpoint 快照屏障n 到达End alignment :Operator算子 的所有输入流的 快照屏障n 到达后(最后一个输入流的快照屏障n 到达后) ,Operator算子就会发出所有待处理的传出记录,然后自己发出快照n屏障。
checkpoint :快照自己当前状态,并恢复处理来自输入流记录,把快照状态,异写入状态后端
检查点的确认与完成
当接收器(Sink)算子从所有输入流中接收到屏障 n 时,它会向检查点协调器(JobManager)发送确认消息,表明该检查点的数据已经处理到末端。只有当 JobManager 接收到所有接收器发送的确认消息后,才会认定检查点 n 完成,并将相关的元数据(如检查点状态、位置信息等)持久化保存下来。此时,检查点 n 就成为了一个可靠的状态快照,后续如果发生故障,Flink 可以利用这个检查点进行恢复。
如何配置Flink的检查点和恢复参数
要开启检查点功能,可借助 ExecutionEnvironment 或者 StreamExecutionEnvironment 来配置。
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.CheckpointingMode;

public class CheckpointConfiguration {
    public static void main(String[] args) throws Exception {
        // 创建流执行环境
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        // 启用检查点,设置检查点间隔为 5000 毫秒(即 5 秒)
        env.enableCheckpointing(5000);

        // 设置检查点模式为精确一次(Exactly-once)
        env.getCheckpointConfig().setCheckpointingMode(CheckpointingMode.EXACTLY_ONCE);

        // 设置检查点超时时间为 60000 毫秒(即 1 分钟)
        env.getCheckpointConfig().setCheckpointTimeout(60000);

        // 设置最大并发检查点数量为 1
        env.getCheckpointConfig().setMaxConcurrentCheckpoints(1);

        // 设置两个连续检查点之间的最小间隔为 1000 毫秒(即 1 秒)
        env.getCheckpointConfig().setMinPauseBetweenCheckpoints(1000);

        // 允许在任务失败时保留最近的检查点
        env.getCheckpointConfig().enableExternalizedCheckpoints(
                org.apache.flink.streaming.api.CheckpointConfig.ExternalizedCheckpointCleanup.RETAIN_ON_CANCELLATION);

        // 执行环境
        env.execute("Checkpoint Configuration Example");
    }
}
除了检查点和恢复,Flink还有哪些容错机制?
如何配置和管理Flink的检查点?
结合实际案例说明Flink的容错机制是如何工作的→
评论区