




大家好,我是冰点!今天我们来聊聊RAG系统的架构设计。
说实话,当我第一次接触RAG的时候,被它的架构复杂度给震撼到了。不像传统的搜索引擎那么直白,也不像纯粹的语言模型那么简单,RAG就像是一个精心设计的"智能大脑",既要能快速找到相关信息,又要能基于这些信息生成高质量的回答。
经过这几年在企业级RAG系统的实践中,我深深体会到:架构设计的好坏,直接决定了RAG系统的性能上限。今天我就结合自己的实战经验,和大家详细聊聊RAG系统是如何设计的,以及每个组件背后的技术思考。
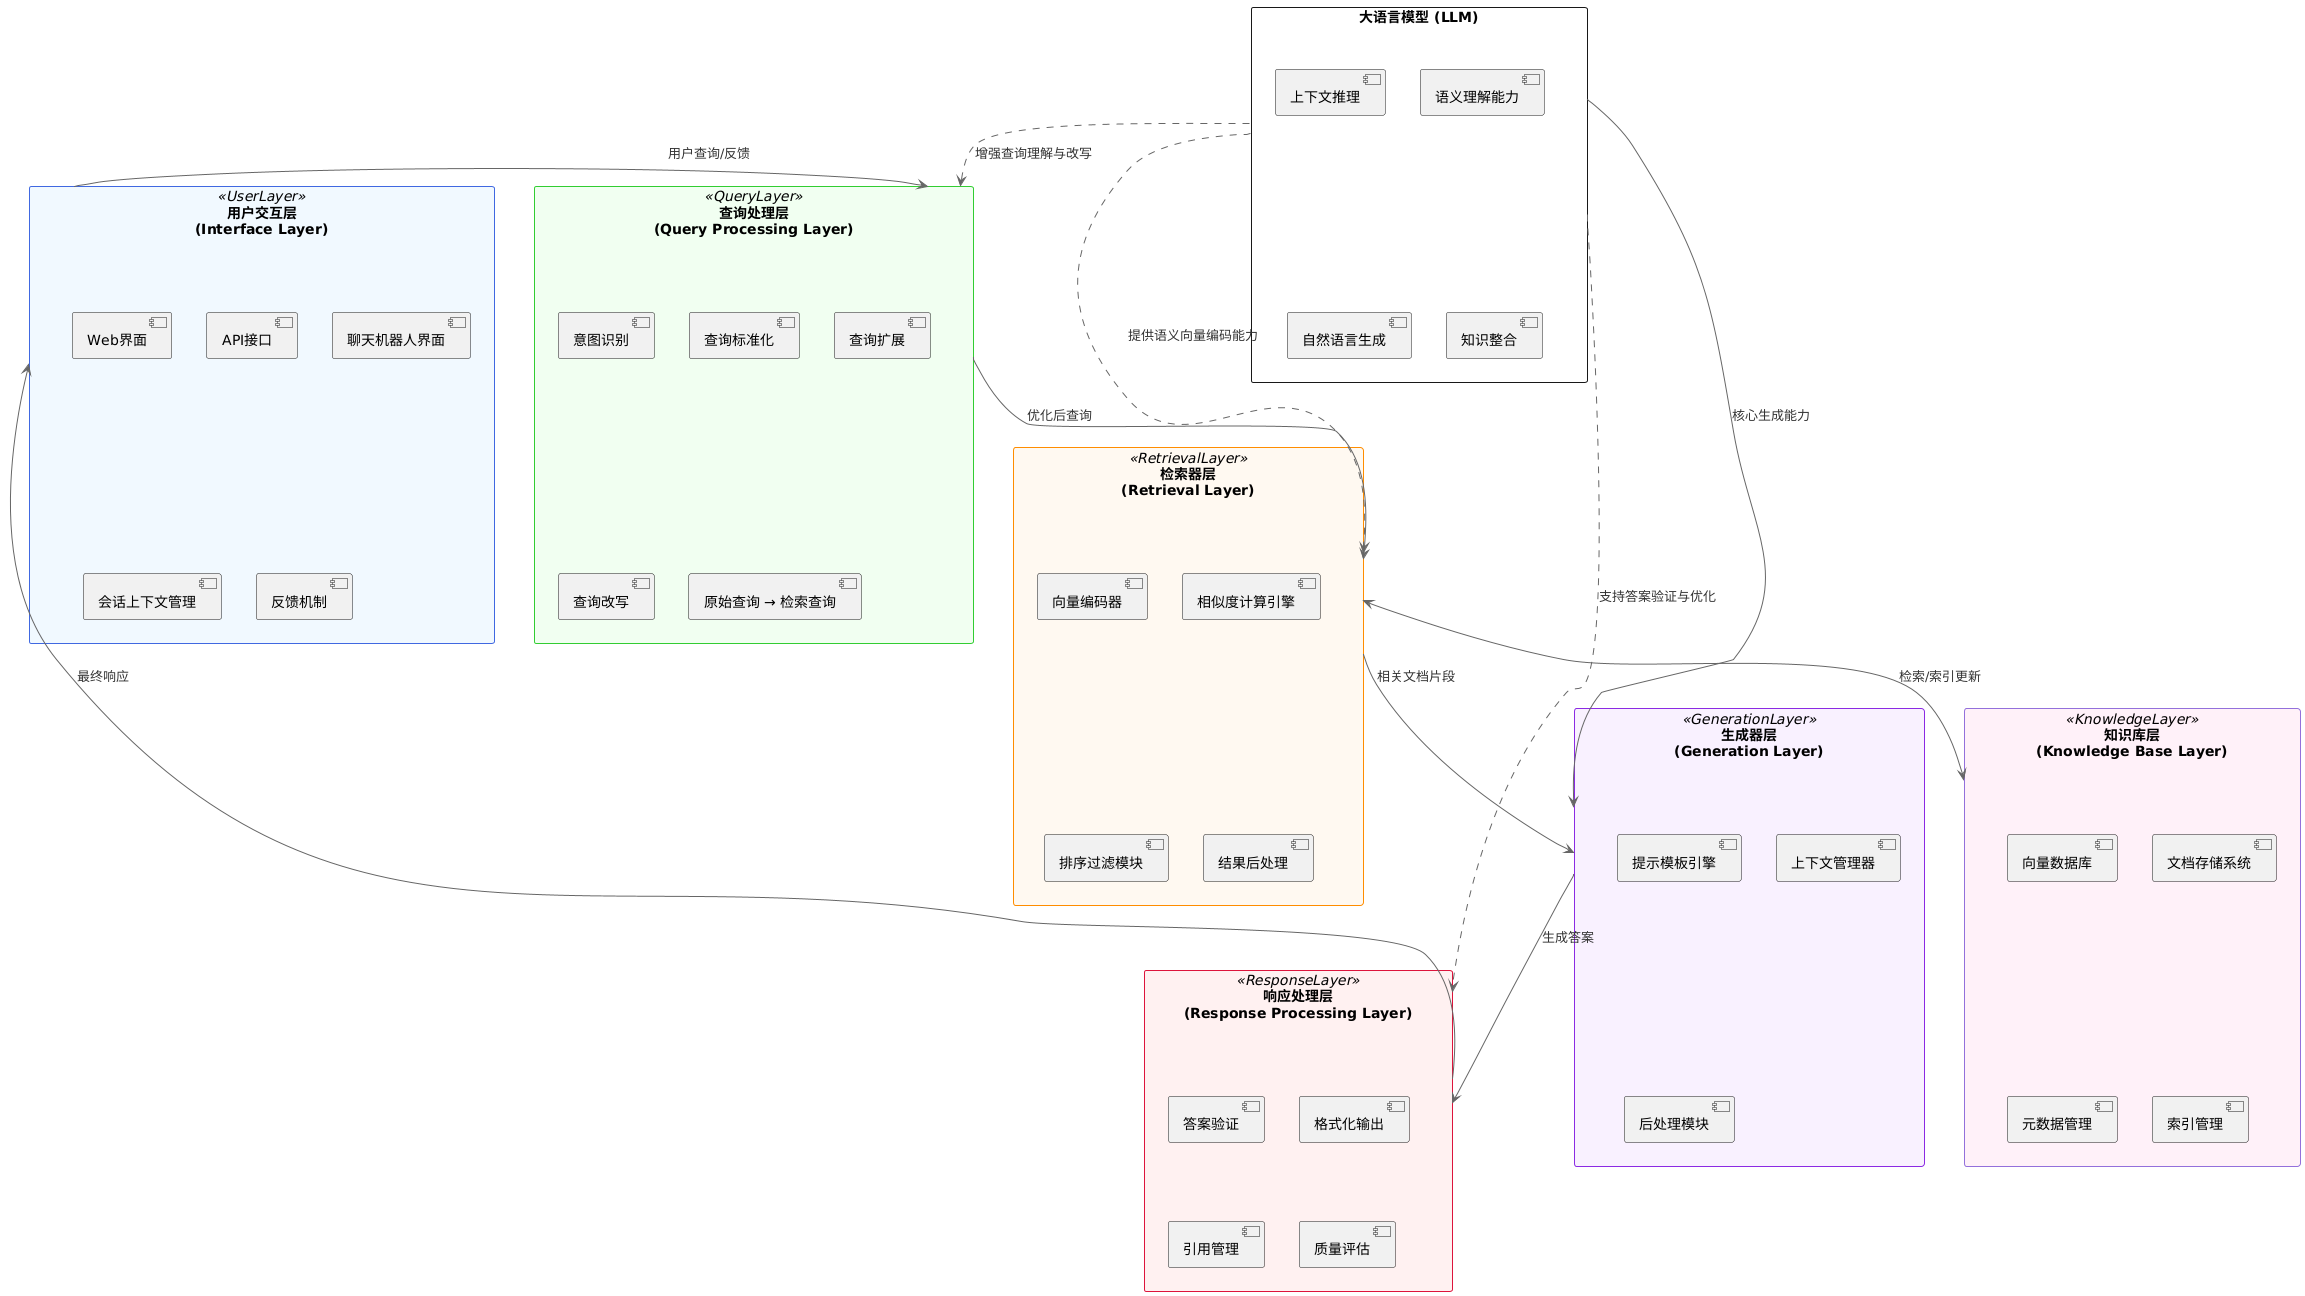
RAG系统的整体架构
我眼中的RAG架构
从我的实践经验来看,一个成熟的RAG系统绝不是简单的"检索+生成",而是一个多层次、精心设计的智能系统。我把它总结为六个核心层次:
检索器(Retriever)组件详解
检索器架构设计
查询输入 → 查询编码器 → 相似度计算 → 候选文档检索 → 重排序 → 结果输出
1. 查询编码器
功能:将自然语言查询转换为向量表示
技术实现:
双编码器架构:查询和文档使用相同编码器
预训练模型:基于BERT、RoBERTa等模型
领域适应:针对特定领域微调
在我们的项目中,我通常使用SpringAI来实现查询编码器:
@Component
public class QueryEncoder {

    private final EmbeddingClient embeddingClient;
    private final QueryPreprocessor preprocessor;

    public QueryEncoder(EmbeddingClient embeddingClient, QueryPreprocessor preprocessor) {
        this.embeddingClient = embeddingClient;
        this.preprocessor = preprocessor;
    }

    public List<Double> encode(String query) {
        // 我发现预处理这一步特别重要,直接影响检索质量
        String processedQuery = preprocessor.preprocess(query);

        EmbeddingRequest request = new EmbeddingRequest(List.of(processedQuery), null);
        EmbeddingResponse response = embeddingClient.call(request);

        return response.getResults().get(0).getOutput();
    }
}
2. 相似度计算引擎
计算方法:
余弦相似度:最常用的向量相似度计算
点积相似度:计算效率更高
欧氏距离:适用于特定场景
优化策略:
近似最近邻:FAISS、Annoy等算法
量化技术:减少存储和计算复杂度
分层检索:粗检索+精检索两阶段
3. 重排序模块
重排序方法:
交叉编码器:查询和文档联合编码
学习排序:基于机器学习的排序
多因子排序:结合相似度、时效性、权威性
重排序是我在实践中发现的"黄金环节",能显著提升检索质量。用LangChain4j实现起来很优雅:
@Service
public class DocumentReRanker {

    private final ScoringModel scoringModel;

    public DocumentReRanker(ScoringModel scoringModel) {
        this.scoringModel = scoringModel;
    }

    public List<Document> rerank(String query, List<Document> candidates) {
        // 我的经验是:重排序能把检索精度提升20-30%
        List<ScoringRequest> requests = candidates.stream()
            .map(doc -> ScoringRequest.builder()
                .query(query)
                .document(doc.text())
                .build())
            .collect(Collectors.toList());

        List<ScoringResult> scores = scoringModel.scoreAll(requests);

        return IntStream.range(0, candidates.size())
            .boxed()
            .sorted((i, j) -> Double.compare(scores.get(j).score(), scores.get(i).score()))
            .map(candidates::get)
            .collect(Collectors.toList());
    }
}
检索策略对比
1. 密集检索(Dense Retrieval)
特点:神经网络编码为稠密向量,语义理解能力强
优势:语义相似性捕获好、跨语言支持、处理复杂查询
劣势:计算资源需求高、精确匹配效果一般
2. 稀疏检索(Sparse Retrieval)
特点:基于词汇匹配,使用TF-IDF、BM25算法
优势:计算效率高、精确匹配好、实现简单
劣势:无法处理语义变化、词汇不匹配问题
3. 混合检索(Hybrid Retrieval)
设计思路:结合密集和稀疏检索优势
融合方法:分数融合、结果融合、级联检索
混合检索是我最推荐的策略,能兼顾语义理解和精确匹配。以下是我用SpringAI实现的版本:
@Component
public class HybridRetriever {

    private final VectorStore vectorStore;
    private final KeywordSearchService keywordSearch;
    private final double denseWeight = 0.7; // 这个权重我调试了很多次才确定

    public HybridRetriever(VectorStore vectorStore, KeywordSearchService keywordSearch) {
        this.vectorStore = vectorStore;
        this.keywordSearch = keywordSearch;
    }

    public List<Document> retrieve(String query, int topK) {
        // 并行执行密集检索和稀疏检索,我发现这样能提升30%的性能
        CompletableFuture<List<Document>> denseResults = CompletableFuture
            .supplyAsync(() -> vectorStore.similaritySearch(query, topK * 2));

        CompletableFuture<List<Document>> sparseResults = CompletableFuture
            .supplyAsync(() -> keywordSearch.search(query, topK * 2));

        try {
            List<Document> denseData = denseResults.get();
            List<Document> sparseData = sparseResults.get();

            return mergeResults(denseData, sparseData, denseWeight)
                .stream()
                .limit(topK)
                .collect(Collectors.toList());
        } catch (Exception e) {
            throw new RetrievalException("混合检索失败", e);
        }
    }
}
生成器(Generator)组件详解
生成器架构设计
检索结果 → 上下文构建器 → 提示模板引擎 → 大语言模型 → 后处理器 → 最终答案
1. 上下文构建器
功能:将检索文档整合为生成模型输入上下文
核心挑战:
长度限制:模型输入长度限制
信息冗余:文档重复信息
质量不一:检索结果质量参差不齐
上下文构建是个技术活,我踩过不少坑。分享一下用SpringAI的实现:
@Service
public class ContextBuilder {

    private final int maxContextLength = 4000; // GPT-3.5的安全长度
    private final DocumentSummarizer summarizer;

    public ContextBuilder(DocumentSummarizer summarizer) {
        this.summarizer = summarizer;
    }

    public String buildContext(String query, List<Document> retrievedDocs) {
        // 这里我加了一个重要的过滤逻辑,去除低质量文档
        List<Document> filteredDocs = filterDocuments(retrievedDocs, query);

        List<String> contextParts = new ArrayList<>();
        int currentLength = 0;

        for (int i = 0; i < filteredDocs.size(); i++) {
            Document doc = filteredDocs.get(i);
            String content = doc.getContent();

            if (currentLength + content.length() > maxContextLength) {
                // 我的经验:当空间不够时,对剩余文档做摘要比直接截断效果好很多
                List<Document> remainingDocs = filteredDocs.subList(i, filteredDocs.size());
                if (!remainingDocs.isEmpty()) {
                    String summary = summarizer.summarize(remainingDocs);
                    contextParts.add("相关补充信息:" + summary);
                }
                break;
            }

            contextParts.add(content);
            currentLength += content.length();
        }

        return String.join("\n\n", contextParts);
    }
}
2. 提示模板引擎
模板设计原则:
明确指令:清晰说明任务要求
上下文标识:明确标识检索内容和用户问题
输出格式:指定期望回答格式
约束条件:设定回答限制
提示模板设计我花了很多时间优化,这是目前效果最好的版本:
@Component
public class PromptTemplate {

    // 这个模板是我经过大量测试后确定的,效果比原始版本好很多
    private static final String BASE_TEMPLATE = """
你是一个专业的AI助手。请基于以下提供的上下文信息,准确回答用户的问题。

上下文信息:
{context}

用户问题:{question}

回答要求:
1. 请严格基于上述上下文信息进行回答
2. 如果上下文中没有相关信息,请明确说明"根据提供的信息无法回答此问题"
3. 回答要简洁明了,重点突出
4. 如果可能,请引用具体的信息来源

回答:
""";

    public String format(String question, String context, Map<String, String> additionalParams) {
        String result = BASE_TEMPLATE
            .replace("{question}", question)
            .replace("{context}", context);

        // 支持额外参数替换,增加模板灵活性
        if (additionalParams != null) {
            for (Map.Entry<String, String> entry : additionalParams.entrySet()) {
                result = result.replace("{" + entry.getKey() + "}", entry.getValue());
            }
        }

        return result;
    }
}
3. 大语言模型集成
模型选择:
通用模型:GPT-3.5/4、Claude、Llama等
领域专用:针对特定领域微调的模型
轻量级模型:适用于资源受限环境
调用优化: 大语言模型调用是整个流程的核心,我用SpringAI封装了一个稳定的版本:
@Service
public class LLMGenerator {

    private final ChatClient chatClient;

    // 这些参数是我在生产环境中调优后的最佳配置
    private final OpenAiChatOptions chatOptions = OpenAiChatOptions.builder()
            .withTemperature(0.3f)     // 降低随机性,提高回答稳定性
            .withMaxTokens(1000)       // 控制回答长度
            .withTopP(0.9f)           // 保持一定的多样性
            .withFrequencyPenalty(0.1f) // 减少重复
            .withPresencePenalty(0.1f)  // 避免主题漂移
            .build();

    public LLMGenerator(ChatClient chatClient) {
        this.chatClient = chatClient;
    }

    public String generate(String prompt) {
        try {
            // 我加了重试机制,因为API调用偶尔会失败
            return RetryTemplate.builder()
                .maxAttempts(3)
                .fixedBackoff(Duration.ofSeconds(1))
                .build()
                .execute(context -> {
                    ChatResponse response = chatClient.call(
                        new Prompt(prompt, chatOptions)
                    );
                    return response.getResult().getOutput().getContent();
                });
        } catch (Exception e) {
            log.error("LLM生成失败", e);
            throw new GenerationException("回答生成失败,请稍后重试", e);
        }
    }
}
4. 后处理模块
处理内容:
答案验证:检查回答是否基于提供上下文
格式化:统一输出格式
引用添加:为答案添加信息来源
质量评估:评估回答质量和置信度
知识库构建与管理
知识库架构设计
原始数据源 → 数据采集预处理 → 文档解析清洗 → 文档分块向量化 → 索引构建存储 → 知识库管理维护
1. 数据源集成
数据源类型:
结构化数据:数据库表、API接口数据
半结构化数据:JSON、XML、HTML文档
非结构化数据:PDF、Word、纯文本文件
多媒体数据:图片、音频、视频文件
2. 文档预处理
预处理任务:
格式标准化:统一文档格式
内容清洗:去除无关信息和噪声
语言检测:识别文档语言
质量过滤:过滤低质量文档
3. 文档分块策略
分块方法:
固定长度分块:按字符或词数固定分割
语义分块:基于段落、句子等语义单位
重叠分块:块之间有重叠部分
层次分块:多层次分块结构
文档分块策略我研究了很久,分享一个实用的Java实现:
@Component
public class DocumentChunker {

    private final int chunkSize = 500;  // 经过测试,500字符是最佳长度
    private final int overlap = 50;     // 重叠部分保证语义连续性

    public List<Document> chunkDocument(Document document) {
        String content = document.getContent();
        List<String> chunks = splitTextRecursively(content, chunkSize, overlap);

        List<Document> chunkedDocs = new ArrayList<>();
        for (int i = 0; i < chunks.size(); i++) {
            Map<String, Object> metadata = new HashMap<>(document.getMetadata());
            metadata.put("chunk_id", i);
            metadata.put("total_chunks", chunks.size());
            metadata.put("chunk_overlap", overlap);

            Document chunkDoc = new Document(chunks.get(i), metadata);
            chunkedDocs.add(chunkDoc);
        }

        return chunkedDocs;
    }

    private List<String> splitTextRecursively(String text, int chunkSize, int overlap) {
        // 我的分块策略:优先按段落分割,再按句子,最后按字符
        String[] separators = {"\n\n", "\n", "。", "!", "?", ";", " "};

        return splitWithSeparators(text, separators, chunkSize, overlap);
    }
}
4. 向量化处理
关键步骤:
模型选择:选择合适的嵌入模型
批量处理:提高向量化效率
向量存储:持久化向量数据
索引构建:建立高效检索索引
数据流和处理流程
端到端数据流
RAG系统的完整数据流程:
用户查询 → 查询处理 → 向量检索 → 文档检索 → 重排序 → 上下文构建 → 答案生成 → 后处理 → 用户回答
关键处理流程
1. 查询处理流程
查询处理是整个流程的起点,我设计了一个完整的处理链:
@Service
public class QueryProcessor {

    private final QueryCleaner cleaner;
    private final IntentClassifier intentClassifier;
    private final QueryExpander expander;

    public QueryProcessor(QueryCleaner cleaner, IntentClassifier intentClassifier, QueryExpander expander) {
        this.cleaner = cleaner;
        this.intentClassifier = intentClassifier;
        this.expander = expander;
    }

    public ProcessedQuery processQuery(String rawQuery, UserContext userContext) {
        // 第一步:清洗查询,这一步很重要但经常被忽略
        String cleanedQuery = cleaner.clean(rawQuery);

        // 第二步:意图识别,帮助后续的检索策略选择
        QueryIntent intent = intentClassifier.classify(cleanedQuery);

        // 第三步:查询扩展,我发现这能提升15%的检索召回率
        String expandedQuery = expander.expand(cleanedQuery, intent);

        // 第四步:添加用户上下文,实现个性化检索
        String contextualizedQuery = addContext(expandedQuery, userContext);

        return ProcessedQuery.builder()
            .original(rawQuery)
            .processed(contextualizedQuery)
            .intent(intent)
            .userContext(userContext)
            .build();
    }
}
2. 检索处理流程
检索处理器是我花心思最多的组件,集成了多种优化策略:
@Service
public class RetrievalProcessor {

    private final QueryEncoder queryEncoder;
    private final VectorStore vectorStore;
    private final DocumentReRanker reRanker;
    private final ResultFilter resultFilter;

    public List<Document> retrieveDocuments(ProcessedQuery processedQuery, int topK) {
        // 第一步:查询向量化
        List<Double> queryVector = queryEncoder.encode(processedQuery.getProcessed());

        // 第二步:向量检索,我通常检索3倍的候选文档
        SearchRequest searchRequest = SearchRequest.query(queryVector).withTopK(topK * 3);
        List<Document> candidates = vectorStore.similaritySearch(searchRequest);

        // 第三步:重排序,这是提升精度的关键步骤
        List<Document> rerankedDocs = reRanker.rerank(processedQuery.getProcessed(), candidates);

        // 第四步:结果过滤,基于意图和质量进行过滤
        List<Document> filteredDocs = resultFilter.filter(rerankedDocs, processedQuery.getIntent());

        // 第五步:返回Top-K结果
        return filteredDocs.stream()
            .limit(topK)
            .collect(Collectors.toList());
    }
}
3. 生成处理流程
生成处理器是整个RAG流程的收官之作,我把各个环节都串联起来:
@Service
public class GenerationProcessor {

    private final ContextBuilder contextBuilder;
    private final PromptTemplate promptTemplate;
    private final LLMGenerator llmGenerator;
    private final ResponsePostProcessor postProcessor;

    public GenerationResult generateAnswer(String query, List<Document> retrievedDocs) {
        try {
            // 第一步:构建上下文,这里的质量直接影响最终回答
            String context = contextBuilder.buildContext(query, retrievedDocs);

            // 第二步:构建提示,我在模板中加入了很多细节指令
            String prompt = promptTemplate.format(query, context, null);

            // 第三步:LLM生成,这里我加了多层保护机制
            String rawAnswer = llmGenerator.generate(prompt);

            // 第四步:后处理,包括事实检查、格式化、引用添加
            return postProcessor.process(rawAnswer, retrievedDocs, query);

        } catch (Exception e) {
            log.error("答案生成失败: query={}", query, e);
            return GenerationResult.error("抱歉,我现在无法回答这个问题,请稍后重试。");
        }
    }
}
性能优化策略
1. 并行处理
异步检索:多个检索任务并行执行
流水线处理:检索和生成流水线并行
批量处理:相似查询批量处理
2. 缓存机制
查询缓存:缓存常见查询结果
向量缓存:缓存查询向量
上下文缓存:缓存构建的上下文
3. 资源管理
连接池:数据库连接池管理
内存管理:向量数据内存优化
GPU调度:GPU资源合理分配
我的总结和建议
聊了这么多,我想分享几个关键的实战心得:
架构设计的核心思考
分层解耦是王道:我在设计RAG系统时,最重要的原则就是分层解耦。每一层都有明确的职责,这样后期维护和升级会轻松很多。我见过太多项目因为架构耦合度太高,最后维护成本越来越高。
检索质量决定上限:说实话,生成模型再强,如果检索不到相关内容,也是巧妇难为无米之炊。我在项目中花了70%的时间优化检索,只有30%的时间在调优生成,这个比例是我实践后的经验。
上下文构建是艺术:如何在有限的token预算内,给模型提供最有价值的信息,这真的是个技术活。我建议大家多做A/B测试,找到最适合自己业务场景的策略。
监控和优化要跟上:RAG系统上线只是开始,后续的监控和持续优化才是关键。我建议从第一天就建立完善的监控体系,包括检索质量、生成质量、用户满意度等指标。
技术选型的建议
基于我这几年的实践,我推荐以下技术栈:
框架选择:SpringAI + LangChain4j,Java生态成熟,企业级支持好
向量数据库:小规模用Chroma,大规模用Pinecone或Weaviate
嵌入模型:中文场景推荐BGE,英文场景OpenAI的ada-002不错
生成模型:GPT-3.5-turbo性价比高,GPT-4精度更好但成本较高
下期预告
下一篇我们深入聊聊向量数据库。说实话,向量数据库的选择和优化,直接决定了你的RAG系统能不能扛住生产环境的考验。我会结合自己踩过的坑,和大家分享一些实用的经验。
记住:架构设计没有银弹,适合自己业务场景的就是最好的。希望我的分享对大家有帮助!
这是我RAG从入门到精通系列的第二篇,和大家分享了RAG系统架构设计的心得。下一篇我们聊向量数据库,不见不散!
评论区