




参考文档
https://docs.spring.io/spring-ai/reference/api/vectordbs/elasticsearch.html
基于 Spring AI 实现 RAG(检索增强生成)的完整实战教程
在本篇博客中,我将带你一步步了解并实践如何使用 Spring AI 构建一个完整的 RAG(Retrieval-Augmented Generation) 系统。我们将结合 Elasticsearch 作为向量数据库,并演示多种 RAG 模式:Basic、Compression、Memory、Translation 和 Rewrite。
这个项目非常适合想要入门大模型 + 向量数据库结合应用的同学,也可以作为企业级问答系统、知识库检索系统的原型参考。
🧠 什么是 RAG?
RAG(Retrieval-Augmented Generation)是一种结合了信息检索和语言生成的技术,其核心思想是:
检索:根据用户输入的问题,在知识库中查找最相关的文档;
增强:将检索到的内容作为上下文注入提示词(Prompt);
生成:由语言模型基于增强后的 Prompt 生成最终回答。
这样可以有效提升 LLM 的准确性与可控性,特别是在面对内部知识库或私有数据时。
🛠️ 技术栈概览
📁 项目结构一览
spring-ai-demo/
├── src/
│   ├── main/
│   │   ├── java/                      # Java 控制器代码
│   │   │   └── com.bingdian.ai.demo.rag.controller/
│   │   │       ├── BasicRAGController.java
│   │   │       ├── CompressionRAGController.java
│   │   │       ├── MemoryRAGController.java
│   │   │       ├── TranslationRAGController.java
│   │   │       └── RewriteRAGController.java
│   │   │
│   │   │   └── resources/
│   │   │       ├── application.yml      # 配置文件
│   │   │       ├── documents/           # 中文 PolarDB 文档
│   │   │       ├── documents-cn/        # 中文故事文档
│   │   │       ├── documents-story/     # 英文故事文档
│   │   │       └── static/index.html    # 前端测试页面
│   │   │
│   │   └── LoadDoc2VectorDBHandler.java # 初始化文档加载逻辑
│   │
│   └── RAGApplication.java            # 主启动类
└── pom.xml                            # Maven 依赖配置
🚀 核心模块解析
1. 文档加载模块:LoadDoc2VectorDBHandler
该模块负责:
从指定路径读取
.md文件;使用
MarkdownDocumentReader解析内容;利用
TokenTextSplitter对文档进行分块处理;将文本转换为向量后,存入 Elasticsearch。
@PostConstruct
void run() {
    var docs = new MarkdownDocumentReader(new FileSystemResource(file)).get();
    vectorStore.add(tokenTextSplitter.split(docs));
}
✅ 支持中文文档自动切片并上传至向量数据库
2. RAG 控制器详解
🔹 Basic RAG Controller
基础检索增强模式,直接对用户问题进行检索 + 生成:
@GetMapping("/chat")
public String chatWithDocument(@RequestParam("prompt") String prompt) {
    return chatClient.prompt()
        .advisors(retrievalAugmentationAdvisor)
        .user(prompt)
        .call()
        .content();
}
🔹 Compression RAG Controller
使用压缩查询优化检索过程,同时保留对话记忆功能:
@PostMapping("/chat/{chatId}")
public String rag(@RequestBody String prompt, @PathVariable String chatId) {
    return chatClient.prompt()
        .advisors(chatMemoryAdvisor, retrievalAugmentationAdvisor)
        .advisors(advisors -> advisors.param(CONVERSATION_ID, chatId))
        .user(prompt)
        .call()
        .content();
}
🔹 Memory RAG Controller
带记忆功能的 RAG,适用于多轮对话场景:
@PostMapping("/chat/{chatId}")
public String chatWithDocument(...) {
    return chatClient.prompt()
        .advisors(chatMemoryAdvisor, retrievalAugmentationAdvisor)
        ...
}
🔹 Translation RAG Controller
在检索前将用户输入翻译成目标语言(如英文),适用于跨语言知识库检索:
var queryTransformer = TranslationQueryTransformer.builder()
    .targetLanguage("english")
    .build();
🔹 Rewrite RAG Controller
使用 LLM 对用户原始提问进行改写,以提高检索相关性:
var queryTransformer = RewriteQueryTransformer.builder()
    .targetSearchSystem("vector store")
    .build();
🌐 前端交互页面说明
提供了一个简洁的 HTML 页面,允许用户选择任意一种 RAG 模式并发送请求:
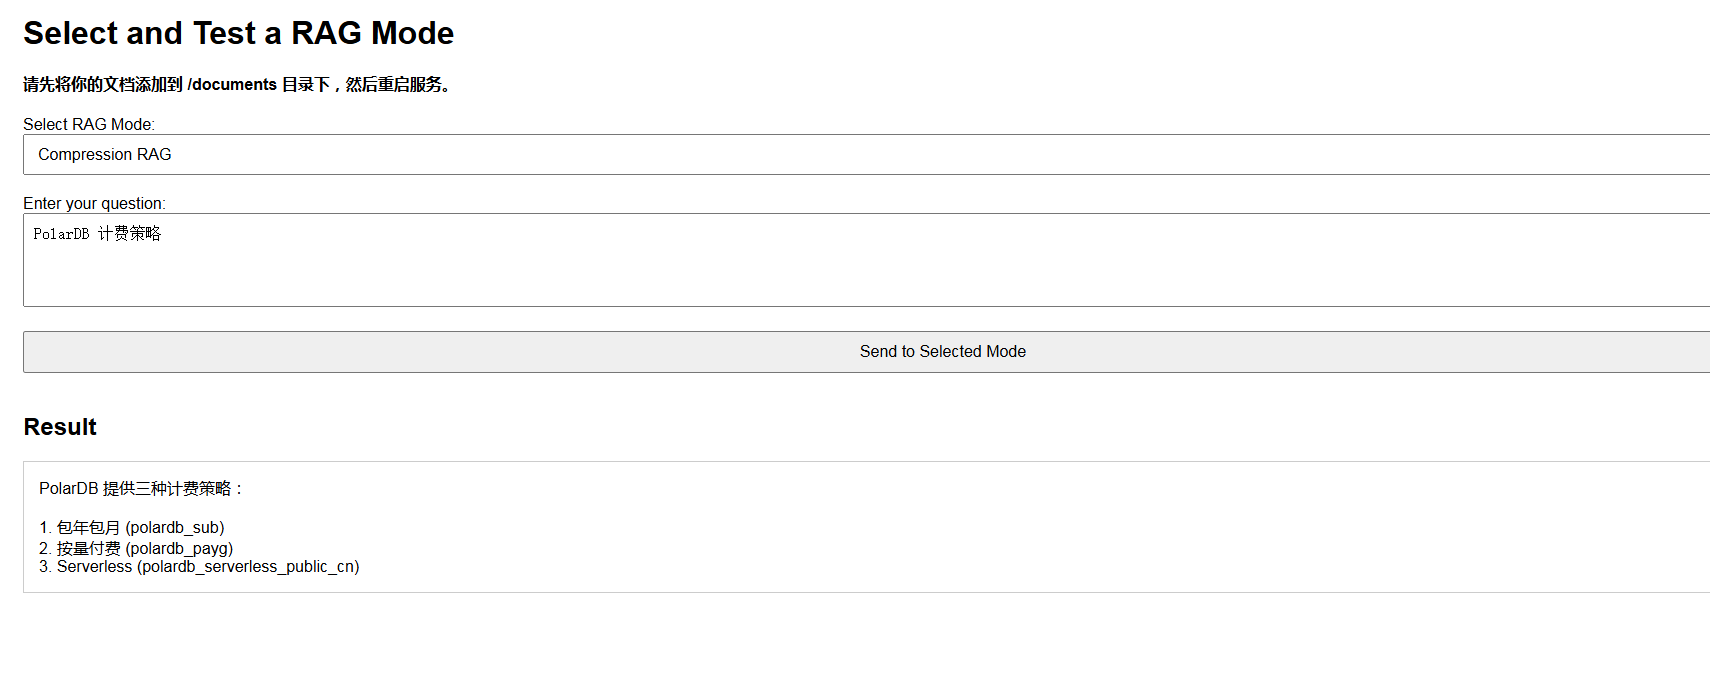
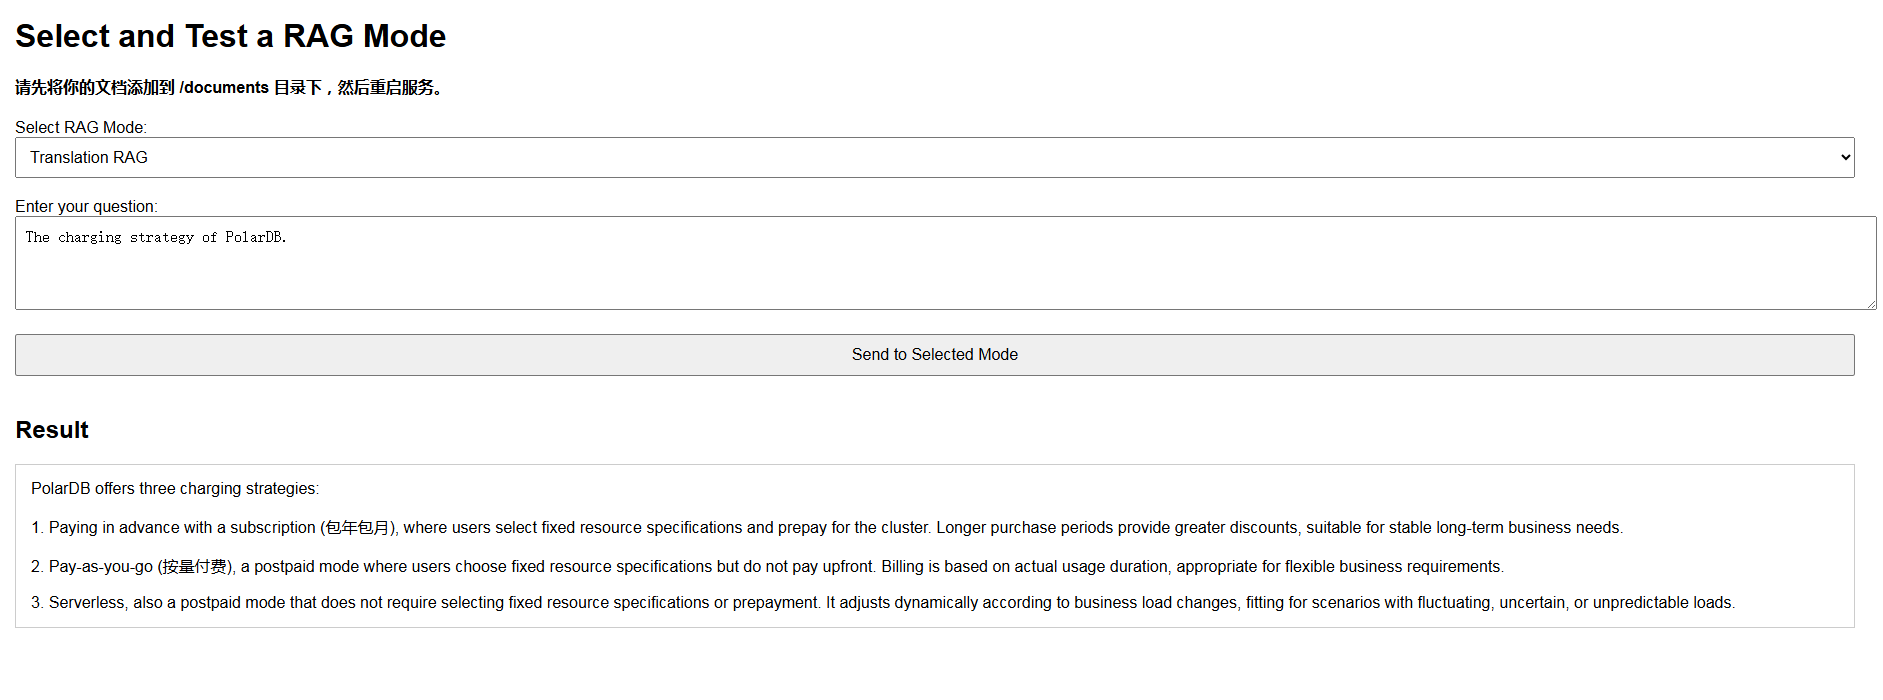
index.html 截图
下拉框选择 RAG 模式;
输入问题后点击按钮;
显示对应模型返回结果;
💡 使用 JavaScript 动态生成 Chat ID(用于 Compression / Memory 模式)
⚙️ 核心配置(application.yml)
server:
  port: 38080

spring:
  ai:
    dashscope:
      api-key: sk-b4e14a58718e4bc59b8de2a3ce43c266
    vectorstore:
      elasticsearch:
        index-name: spring-ai-polar-index
        similarity: cosine
        dimensions: 1536

  elasticsearch:
    uris: http://172.24.32.232:19200
📈 示例:PolarDB 计费策略问答系统
我们以阿里云 PolarDB 的计费策略文档为例,训练出一个专属的知识问答系统:
用户输入:
polardb 收费策略返回:
PolarDB 支持三种计费方式:

- 包年包月(预付费)
- 按量付费(后付费)
- Serverless(动态弹性资源按小时计费)

不同模式适用不同业务场景...
你也可以替换为你自己的知识库,比如产品手册、技术文档、FAQ 等。
📦 运行步骤
准备知识库文档(放入
resources/documents目录下);修改
application.yml配置;启动 Spring Boot 应用;
打开
http://localhost:38080;输入问题并选择 RAG 模式;
查看结果输出。
🧩 可扩展方向
✅ 支持 PDF / Word / Excel 多种格式解析;
✅ 支持 PostgreSQL、Milvus、FAISS 等其他向量数据库;
✅ 结合 Redis 缓存会话状态;
✅ 添加身份认证和权限控制;
✅ 支持 RESTful API 接口供外部调用;
✅ 集成 LangChain4j 或 LlamaIndex 提供更多高级特性。
🎯 总结
通过本文介绍的 Spring AI Demo,你可以快速搭建一个具备以下能力的 RAG 系统:
GitHub 地址:[待补充]
项目名称:spring-ai-rag
📚 参考资料
如需获取完整源码、部署方案或定制开发,欢迎联系我 👇
评论区