




在大数据领域,Apache Kafka 作为高吞吐量、分布式的消息队列系统,广泛应用于数据管道、实时流处理等场景。然而,在实际使用中,Kafka 的架构设计涉及诸多关键决策,其中分区数、副本因子与存储策略的选择,更是直接影响系统的性能、可靠性和资源利用率。作为资深架构师,本文将结合实际场景,深入剖析这些要素的选择逻辑,并通过图文帮助大家更好地理解。
一、分区数:性能与资源的平衡
1.1 分区的作用
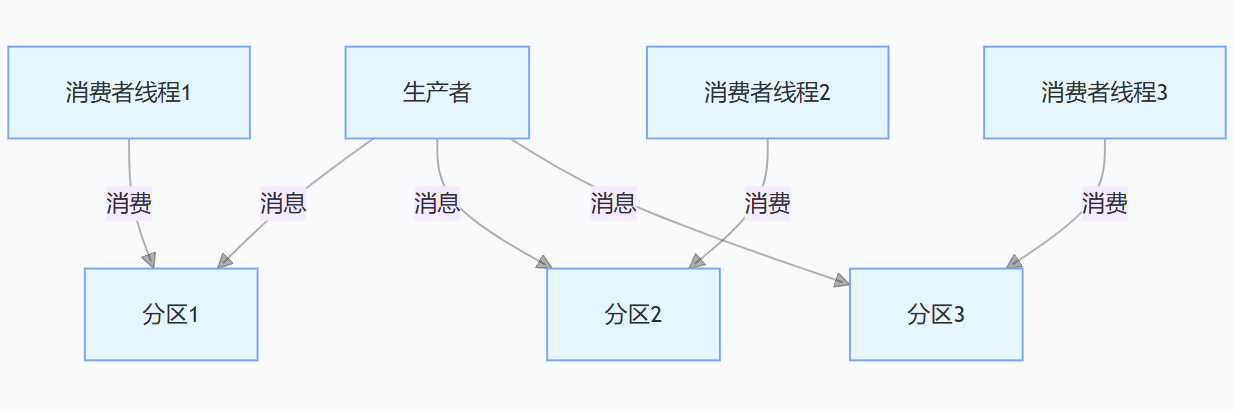
Kafka 中的分区(Partition)是实现高吞吐量和并行处理的核心机制。每个主题(Topic)可以划分为多个分区,每个分区是一个有序的消息队列。消费者可以通过并行消费不同分区的数据,从而提升整体的消费效率。同时,分区还能实现数据的分布式存储,避免单个节点存储压力过大。
从下图中可以直观看到,一个主题被划分成多个分区,生产者将消息发送到不同分区,消费者通过多个线程并行消费分区数据。
1.2 分区数的选择逻辑
业务场景的消息流量:如果业务场景中消息产生的速率很高,例如电商平台的订单实时推送、金融交易的实时记录等,就需要较多的分区来支撑高吞吐量。以某大型电商的双 11 活动为例,每秒订单消息量可达数十万条,此时就需要数百个分区来保证消息的快速写入和消费。物流行业 IoT 场景下,车辆和订单数量庞大,且轨迹数据需实时上传。以一家覆盖全国的物流企业为例,其拥有上万辆运输车辆,每天产生的轨迹数据消息量可达数千万条,高峰期每秒新增轨迹消息数千条,为了保证数据能够快速写入 Kafka,需要设置较多的分区,如 100 - 150 个,以满足高并发的数据写入需求 。
例如物流企业每日产生数千万条轨迹数据,在业务高峰时段,每秒新增轨迹消息可达数千条。如此庞大的数据流量,对 Kafka 的写入性能提出了极高要求。分区作为 Kafka 实现高吞吐量的核心机制,通过水平扩展提升并行处理能力。若分区数量不足,生产者发送消息时会出现排队等待,导致数据积压,无法满足实时性需求;而分区过多则会增加集群管理开销与磁盘 I/O 竞争。
从消费者角度来看,企业数据分析团队配备的服务器硬件资源中等,且仅需对轨迹数据进行基础的实时监控分析。若分区数过多,消费者线程难以充分利用,反而会造成资源浪费。经过综合评估,120 个分区既能满足高并发数据写入需求,又与消费者处理能力相匹配,实现了数据处理效率与资源利用的平衡。同时,该企业 Kafka 集群拥有 15 个节点,120 个分区可均匀分布在节点上,确保每个节点的负载均衡,充分发挥集群的整体性能 。
消费者的并行处理能力:消费者的线程数和处理能力决定了能够同时消费的分区数量。如果消费者的硬件资源有限,过多的分区反而会导致资源浪费和性能下降。例如,在一个小型的数据分析项目中,消费者服务器配置较低,可能只需要 10 - 20 个分区即可满足需求。在物流 IoT 场景中,如果企业的数据分析团队使用的服务器配置中等,且仅需对车辆轨迹数据进行简单的实时监控分析,那么消费者的并行处理能力有限,此时可将分区数适当减少至 50 - 80 个,确保消费者能够高效处理数据。
集群节点数量:分区数过多会增加集群管理的开销,每个分区都需要在节点上进行存储和管理。一般建议分区数略大于集群节点数的倍数,以充分利用节点资源,同时避免过度分散。例如,对于一个有 10 个节点的集群,分区数设置在 30 - 50 个较为合适。若物流企业的 Kafka 集群有 15 个节点,为了平衡资源利用和管理开销,分区数可设置在 60 - 90 个。
1.3 分区数选择的常见误区
很多人认为分区数越多越好,这样可以无限提升性能。但实际上,分区数过多会带来以下问题:
增加磁盘 I/O 开销:每个分区都会有独立的日志文件,过多分区会导致磁盘 I/O 竞争加剧。
增加网络开销:分区过多会增加生产者和消费者与各个分区之间的网络通信次数。
增加集群管理复杂度:分区的副本分配、故障转移等管理操作会变得更加复杂。
二、副本因子:可靠性与成本的博弈
2.1 副本的作用
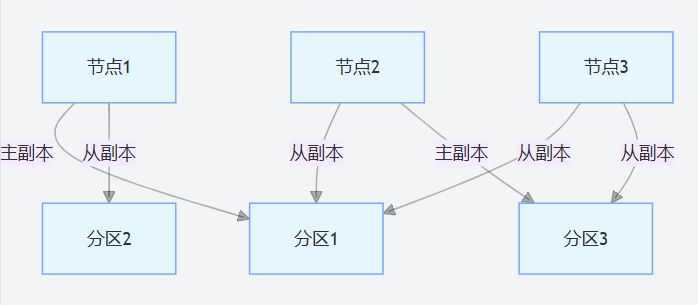
副本因子(Replication Factor)指的是每个分区的数据在集群中复制的份数。Kafka 通过副本机制实现数据冗余,提高系统的可靠性和容错能力。当某个节点出现故障时,其他副本可以继续提供服务,保证数据不丢失和业务的连续性。
从下面的示意图可以看到,每个分区有 3 个副本,分别分布在不同的节点上,其中一个为主副本,其余为从副本。
2.2 副本因子的选择逻辑
业务对数据可靠性的要求:对于金融、医疗等对数据可靠性要求极高的行业,建议将副本因子设置为 3 或更高,以确保即使有多个节点故障,数据依然完整可用。例如,银行的交易记录系统,副本因子设置为 3,能有效应对节点故障带来的数据风险。在物流 IoT 场景中,车辆和订单轨迹数据关乎物流运输的调度、监控以及后续的业务分析和客户服务,数据丢失可能导致严重的运营问题和客户信任危机。因此,为保证数据可靠性,副本因子可设置为 3 ,确保在 1 - 2 个节点故障时,数据依然能够正常访问和使用。
集群的硬件资源和成本:副本因子越高,占用的存储资源和网络带宽就越多,相应的硬件成本也会增加。对于一些对成本敏感的业务,如日志分析等,可以适当降低副本因子,但至少要保证为 2,以防止单节点故障导致数据丢失。如果物流企业的预算有限,且对数据恢复时间要求不是特别苛刻,在权衡成本和可靠性后,也可将副本因子设置为 2,以减少存储和带宽资源的消耗。
故障容忍度:根据集群的预期故障情况来设置副本因子。如果希望系统能够容忍 1 个节点故障,副本因子至少为 2;如果要容忍 2 个节点故障,副本因子则需要设置为 3。物流企业可根据自身集群的硬件状况和历史故障数据,评估故障发生的概率和影响,从而合理设置副本因子。
2.3 副本因子选择的注意事项
避免副本因子过高:过高的副本因子会导致写入性能下降,因为每次写入都需要同步多个副本。同时,过多的副本也会增加数据同步的延迟。
合理分配副本:要确保副本在集群节点上均匀分布,避免出现某些节点副本过多,而其他节点副本过少的情况,影响集群的负载均衡。
三、存储策略:空间与性能的抉择
3.1 存储策略的重要性
Kafka 的数据存储在磁盘上,合理的存储策略能够有效利用磁盘空间,同时保证数据的读写性能。Kafka 的存储策略主要涉及日志保留策略、压缩策略和存储目录配置等方面。
3.2 存储策略的选择逻辑
日志保留策略:
时间维度:可以根据业务需求设置消息在磁盘上的保留时间,例如设置为 7 天,超过 7 天的消息将被自动删除。对于一些时效性较强的业务,如广告点击日志,较短的保留时间可以节省磁盘空间。在物流 IoT 场景中,车辆和订单轨迹数据在短期内对物流调度、实时监控和异常处理至关重要,但随着时间推移,历史轨迹数据的使用频率会逐渐降低。企业可根据自身需求,将日志保留时间设置为 30 - 60 天 ,既能满足业务对近期数据的查询和分析需求,又能节省磁盘空间。
大小维度:也可以根据分区日志文件的大小来决定是否删除旧数据。当分区日志文件达到指定大小后,开始删除最早的消息。对于物流企业,如果每天产生的轨迹数据量较大,也可结合日志文件大小来管理数据,例如当单个分区日志文件达到 50GB 时,删除最早的数据。
压缩策略:Kafka 支持多种压缩算法,如 Snappy、Gzip 等。对于存储大量文本数据的场景,如日志文件,可以选择 Gzip 压缩算法,以获得更高的压缩比,节省磁盘空间;而对于对压缩和解压缩性能要求较高的场景,如实时流处理,可以选择 Snappy 算法。物流行业的车辆和订单轨迹数据包含大量的位置坐标、时间戳等信息,数据格式相对固定且具有一定的重复性。为了在保证实时处理性能的同时节省存储空间,可采用 Snappy 压缩算法 ,在实现较高压缩比的同时,确保数据能够快速压缩和解压缩,满足实时轨迹监控和分析的需求。
存储目录配置:将 Kafka 的数据存储目录分布在多个磁盘上,可以分散磁盘 I/O 压力,提高读写性能。同时,要定期清理磁盘空间,避免因磁盘空间不足导致 Kafka 服务异常。物流企业可将 Kafka 存储目录分布在多块高速磁盘上,如 SSD 磁盘,并且定期清理过期的轨迹数据,保证系统的高效运行。
3.3 存储策略优化案例
某互联网公司的用户行为日志系统,每天产生的数据量高达 TB 级。通过将日志保留时间设置为 30 天,采用 Gzip 压缩算法,并将存储目录分布在 10 块磁盘上,不仅有效节省了磁盘空间,还保证了数据的快速读写,满足了实时分析的需求。
四、综合案例分析
以一个大型在线教育平台为例,该平台需要实时处理用户的学习行为数据,包括课程观看记录、作业提交、考试成绩等。每天产生的数据量约为 500GB,消息峰值流量可达每秒 10 万条。
4.1 分区数选择
考虑到高流量和消费者的并行处理能力,将主题分区数设置为 200 个。这样既能满足消息的快速写入,又能通过多个消费者线程并行消费,提高处理效率。同时,该平台拥有 20 个节点的 Kafka 集群,200 个分区也能较好地在节点上分布,充分利用资源。
4.2 副本因子选择
由于教育数据的重要性,为了保证数据可靠性,将副本因子设置为 3。即使有 1 - 2 个节点故障,数据依然完整可用,不会影响平台的正常运营。虽然这样会增加一定的存储成本,但相比数据丢失带来的损失,是值得的。
4.3 存储策略选择
日志保留策略设置为 60 天,以满足教学数据分析和审计的需求。采用 Snappy 压缩算法,在保证压缩性能的同时,满足实时流处理对解压缩速度的要求。将存储目录分布在 15 块磁盘上,分散 I/O 压力,提升读写性能。
通过合理选择分区数、副本因子和存储策略,该在线教育平台的 Kafka 系统稳定运行,高效处理用户行为数据,为教学决策和用户体验优化提供了有力支持。
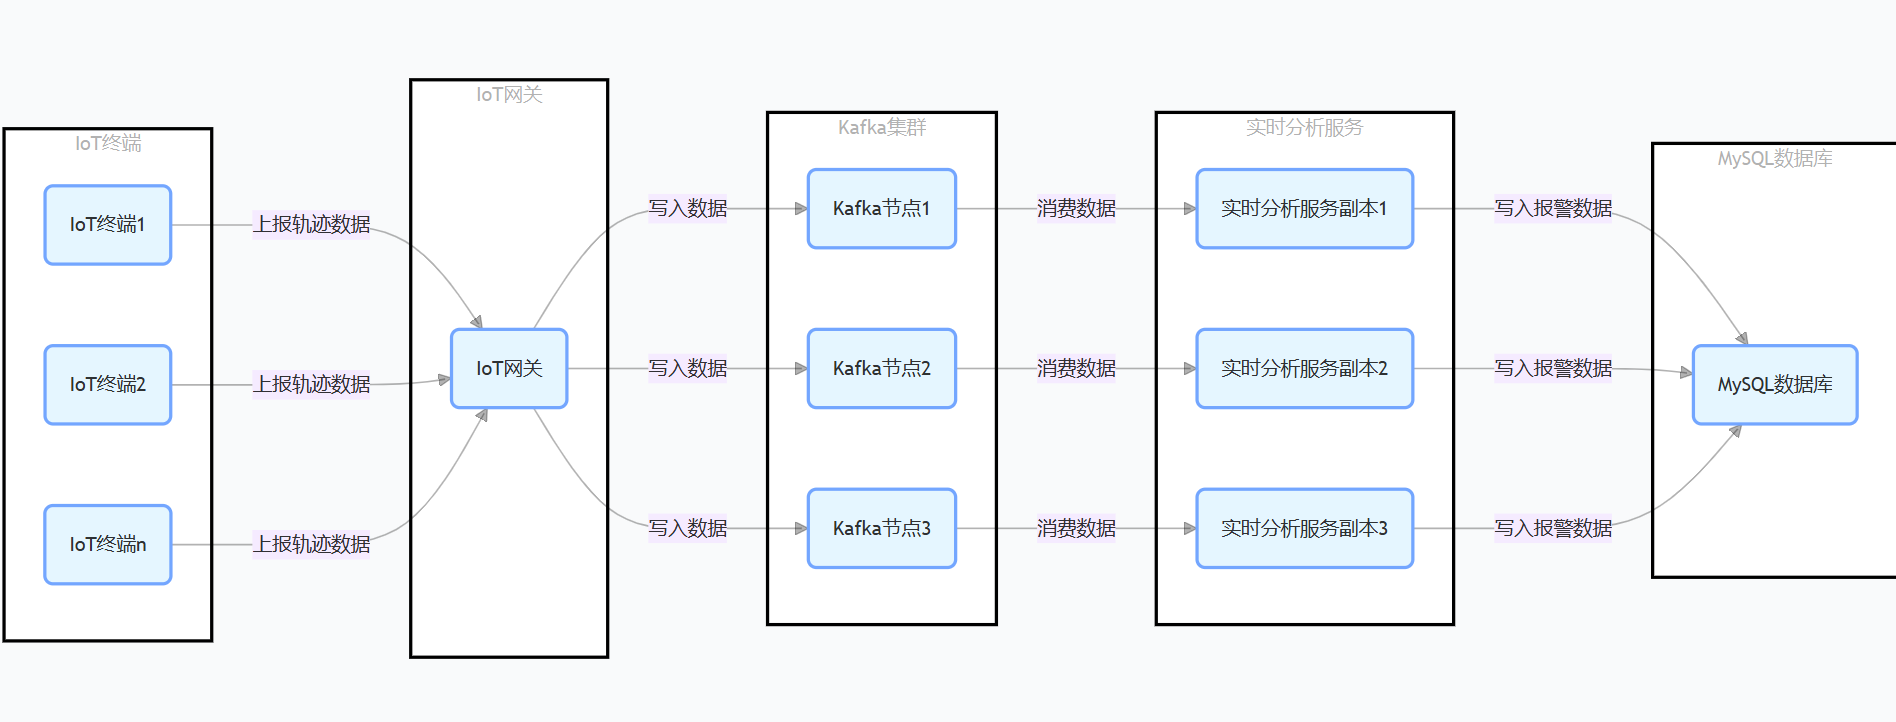
再以一家大型物流企业为例,其构建了基于 Kafka 的物流 IoT 数据处理平台,用于收集和处理车辆轨迹与订单轨迹数据。在分区数方面,根据每日数千万条的消息量和消费者的处理能力,设置了 120 个分区;副本因子为了保障数据可靠性,设定为 3;存储策略上,日志保留时间设置为 45 天,采用 Snappy 压缩算法,并将数据存储目录分布在 12 块 SSD 磁盘上。该平台上线后,稳定承载了海量轨迹数据的实时传输与处理,帮助企业实现了车辆的精准调度、订单的实时跟踪,大大提升了物流运营效率和客户满意度。
五、总结
Kafka 架构设计中的分区数、副本因子与存储策略的选择,是一个需要综合考虑业务需求、性能要求、资源成本等多方面因素的过程。在实际应用中,没有固定的标准和答案,需要根据具体场景进行权衡和调整。通过深入理解这些要素的作用和选择逻辑,并结合实际案例进行实践和优化,才能构建出高效、可靠、经济的 Kafka 系统,为企业的大数据应用提供坚实的基础。
希望本文的内容能对大家在 Kafka 架构设计方面有所帮助,如果你在实际项目中遇到相关问题,欢迎在评论区留言讨论,一起探索更优的解决方案。
评论区