




1. Kafka 架构概览
Kafka 是一个分布式流处理平台,最初由 LinkedIn 开发并开源,旨在处理高吞吐量的实时数据流。Kafka 设计的核心理念是高可扩展性、高容错性以及高可用性,并且能够满足大规模系统的需求,特别是对于大数据平台、实时分析、日志聚合等场景。
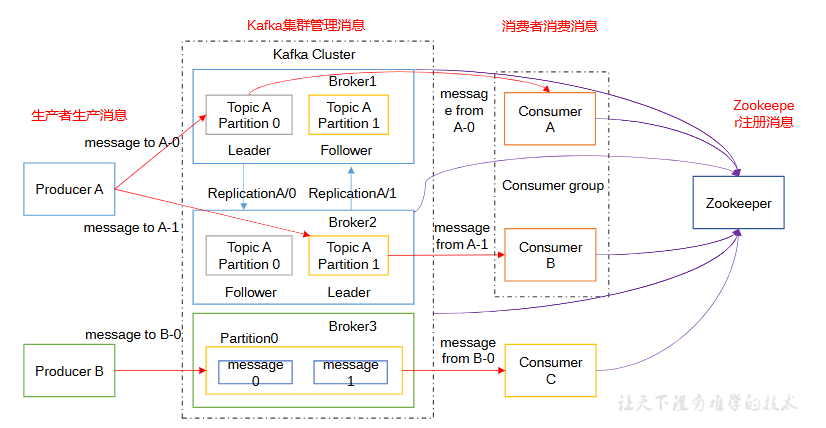
1. Producer(消息生产者)
Producer 是向 Kafka Broker 发送消息的客户端。它可以将各种业务系统产生的数据,按照指定的 Topic 发送到 Kafka 集群中。比如在电商系统中,用户的下单操作产生的订单数据,就可以通过 Producer 发送到名为 “order - topic” 的 Topic 里 。
示例:假设一个日志收集系统,有许多应用程序会产生日志。每个应用程序就是一个 Producer,它们将各自产生的日志消息发送到 Kafka 集群中名为 “log - topic” 的 Topic 上。
2. Consumer(消息消费者)
Consumer 是从 Kafka Broker 拉取消息的客户端。它可以订阅感兴趣的 Topic,然后按照一定的逻辑处理接收到的消息。比如在实时数据分析系统中,Consumer 从 Kafka 中获取数据后,进行统计分析等操作。
示例:在上述电商系统中,数据分析团队可能会使用 Consumer 从 “order - topic” 中获取订单消息,然后对订单数据进行分析,统计销售额、订单数量等指标。
3. Topic(主题)
可以把 Topic 理解为一个消息队列,用于对消息进行分类。不同类型的消息发送到不同的 Topic 中。例如在社交媒体系统中,用户发布的动态、评论、点赞等不同类型的操作产生的消息,会分别发送到 “post - topic”“comment - topic”“like - topic” 等不同的 Topic 中。
示例:在一个物流系统中,包裹的发货信息、运输轨迹信息、签收信息可以分别发送到 “shipment - topic”“tracking - topic”“delivery - topic”。
4. Consumer Group(CG,消费者组)
广播实现:Kafka 通过 Consumer Group 实现消息的广播和单播。如果要实现广播,即让每个 Consumer 都能收到 Topic 的所有消息,只需让每个 Consumer 属于一个独立的 CG。因为每个 Topic 的消息会复制(概念上)到所有的 CG,且每个 Partition 只会把消息发给该 CG 中的一个 Consumer 。
单播实现:若要实现单播,即让消息只被一个 Consumer 消费,所有的 Consumer 应在同一个 CG 中。这样一个 Partition 的消息只会被该 CG 中的一个 Consumer 消费。同时,通过 CG 可以灵活对 Consumer 分组,无需将消息多次发送到不同 Topic 。
示例:广播场景:在一个新闻推送系统中,每个用户的设备可以看作一个独立的 Consumer,且属于不同的 CG。新闻发布后,作为消息发送到 Kafka 的 “news - topic”,每个用户设备(Consumer)都能收到这条新闻消息,实现了新闻对所有用户的广播。
单播场景:在一个订单处理系统中,有多个订单处理服务器作为 Consumer 组成一个 CG,当有新订单消息发送到 “order - topic” 时,只会有一个订单处理服务器(Consumer)来处理这个订单,避免重复处理,实现单播。
5. Broker(代理服务器)
讲解:一台 Kafka 服务器就是一个 Broker。多个 Broker 组成 Kafka 集群,一个 Broker 可以容纳多个 Topic。Broker 负责接收 Producer 发送的消息,存储消息,并为 Consumer 提供消息读取服务。例如在一个大型分布式系统中,可能会有几十台 Broker 组成集群,共同处理海量的消息。
示例:在一个互联网公司的消息处理平台中,部署了 10 台 Broker 服务器组成 Kafka 集群。这些 Broker 上存储着用户行为数据、业务交易数据等不同 Topic 的消息,支撑着公司多个业务系统的消息流转。
6. Partition(分区)
讲解:为了实现扩展性,一个大的 Topic 会被分布到多个 Broker 上,即一个 Topic 可以分为多个 Partition。每个 Partition 是一个有序的队列,其中的每条消息都有一个有序的 id(offset)。Kafka 保证在一个 Partition 内消息的顺序性,但不保证一个 Topic 整体(多个 Partition 间)的顺序性。比如一个非常活跃的 “message - topic”,可以被划分为多个 Partition,分布在不同的 Broker 上存储和处理。
示例:在一个大型电商的订单 Topic(如 “order - topic”)中,由于订单数据量巨大,将其划分为 10 个 Partition。这些 Partition 分布在不同的 Broker 上,每个 Partition 内的订单消息按照产生的先后顺序排列,有各自的 offset。当有新订单产生时,会根据一定的规则(如哈希算法)被分配到其中一个 Partition 中。
7. Offset(偏移量)
讲解:Kafka 的存储文件按照 offset.kafka 命名,offset 作为文件命名方便查找消息。例如想找到位于 offset 为 2049 的消息,只要找到 2048.kafka 文件即可(因为 offset 是有序递增的)。第一个消息的 offset 是 0,对应的文件是 00000000000.kafka 。
示例:在一个持续接收消息的 “log - topic” 中,消息不断写入 Partition 对应的存储文件。假设当前最新写入消息的 offset 是 5000,那么如果要查找 offset 为 4500 的消息,就可以直接定位到 4499.kafka 文件,在该文件中查找对应的消息记录。
二、核心组件简单解析
后面章节我们详细解析,此处只是简单的代码示例
1. Producer(消息生产者)
1.1 消息发送流程
// 生产者初始化
Properties props = new Properties();
props.put("bootstrap.servers", "broker1:9092,broker2:9092");
props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");
props.put("acks", "all"); // 强一致性保障
props.put("retries", 3); // 重试机制

Producer<String, String> producer = new KafkaProducer<>(props);

// 同步发送消息
ProducerRecord<String, String> record =
  new ProducerRecord<>("user-tracking", "user_123", "click_event");
producer.send(record, (metadata, exception) -> {
  if (exception != null) {
    // 消息发送失败处理
    log.error("Failed to send message: {}", exception.getMessage());
  } else {
    // 消息成功发送
    log.info("Message sent to partition: {}, offset: {}",
      metadata.partition(), metadata.offset());
  }
});

producer.close();
1.2 关键配置参数
1.3 高级特性
事务支持:
producer.initTransactions();
producer.beginTransaction();
try {
  producer.send(record1);
  producer.send(record2);
  producer.commitTransaction();
} catch (KafkaException e) {
  producer.abortTransaction();
}
2. Consumer(消息消费者)
2.1 消费组机制
// 消费者初始化
Properties props = new Properties();
props.put("bootstrap.servers", "broker1:9092");
props.put("group.id", "analytics-group");
props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");
props.put("auto.offset.reset", "earliest"); // 从头开始消费
props.put("enable.auto.commit", "false"); // 手动提交位移

Consumer<String, String> consumer = new KafkaConsumer<>(props);
consumer.subscribe(Collections.singletonList("user-tracking"));

// 消息循环处理
while (true) {
  ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
  for (ConsumerRecord<String, String> record : records) {
    // 业务处理逻辑
    processRecord(record);
  }
  // 手动提交位移
  consumer.commitSync();
}
2.2 消费位移管理
java
// 提交指定分区的位移
Map<TopicPartition, OffsetAndMetadata> offsets = new HashMap<>();
offsets.put(new TopicPartition("user-tracking", 0),
  new OffsetAndMetadata(record.offset() + 1));
consumer.commitSync(offsets);
2.3 反压机制
通过调整 max.poll.records 和线程池大小实现消费速率控制:
java
props.put("max.poll.records", 500); // 单次拉取最大消息数
props.put("max.poll.interval.ms", 300000); // 消费超时时间
3. Broker 集群配置
3.1 关键配置文件(server.properties)
properties
# 基础配置
broker.id=1
listeners=PLAINTEXT://:9092
log.dirs=/data/kafka-logs

# 副本管理
num.replica.fetchers=3
min.insync.replicas=2
unclean.leader.election.enable=false

# 性能优化
num.io.threads=8
socket.send.buffer.bytes=102400
socket.receive.buffer.bytes=102400
3.2 Leader 选举机制
java
// ISR(In-Sync Replicas)机制
// 当 Leader 宕机时,仅 ISR 中的 Follower 参与选举
// 通过以下参数控制 ISR 大小
replica.lag.time.max.ms=10000
replica.lag.max.messages=4000
4. Topic 与 Partition 设计
4.1 创建主题示例
bash
# 命令行创建
bin/kafka-topics.sh --create \
  --topic order-topic \
  --partitions 10 \
  --replication-factor 3 \
  --config min.insync.replicas=2
4.2 自定义分区策略
java
public class HashPartitioner implements Partitioner {
  @Override
  public int partition(String topic, Object key, byte[] keyBytes,
                       Object value, byte[] valueBytes, Cluster cluster) {
    List<PartitionInfo> partitions = cluster.partitionsForTopic(topic);
    int numPartitions = partitions.size();
    return Math.abs(key.hashCode()) % numPartitions;
  }
}

// 使用自定义分区器
props.put("partitioner.class", "com.example.HashPartitioner");
三、生产级配置优化
1. 可靠性配置矩阵
2. 吞吐量优化方案
java
// Producer 端优化
props.put("batch.size", 32768); // 32KB 批量
props.put("linger.ms", 50); // 50ms 延迟

// Broker 端优化
num.network.threads=16
num.io.threads=8
四、典型故障场景与解决方案
ISR 收缩
现象:分区的 ISR 数量减少
解决方案:检查 Broker 磁盘 I/O 和网络延迟
调整
replica.lag.time.max.ms参数
消费者滞后
诊断命令:bash
bin/kafka-consumer-groups.sh --describe \ --group analytics-group \ --bootstrap-server localhost:9092优化措施:
增加消费者实例数量
增大
max.poll.records值
评论区