




在大数据处理领域,Apache Flink 凭借其强大的流处理和批处理能力备受青睐。而 Flink 集群的部署模式,是决定其性能、可扩展性和灵活性的关键因素。不同的部署模式适用于不同的业务场景和需求,下面将结合生动的架构图与实际案例,详细介绍单机模式、本地模式、分离式部署和嵌入式模式的特点、优缺点及适用场景。
一、单机模式
(一)特点
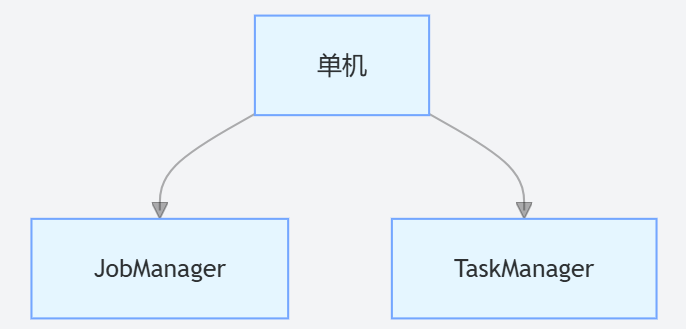
单机模式是 Flink 最简单的部署方式,所有的 Flink 组件,包括 JobManager 和 TaskManager,都运行在一台机器上。这种模式下,资源有限,任务执行和管理都在单机环境内完成,无需进行复杂的分布式配置。
(二)优缺点
优点在于部署和配置极其简单,几乎不需要额外的环境搭建和复杂的参数设置,非常适合初学者快速上手学习 Flink 的基本概念和操作,也可用于简单的测试和调试场景。例如,刚接触 Flink 的开发人员在本地编写完一个简单的 WordCount 程序后,使用单机模式可以快速验证程序逻辑是否正确,无需担心分布式环境带来的复杂配置问题。
然而,单机模式的缺点也很明显。由于资源局限于单台机器,其处理能力有限,无法应对大规模数据和高并发任务,并且缺乏高可用性,一旦这台机器出现故障,整个 Flink 集群就会崩溃,无法继续提供服务。
(三)适用场景
单机模式主要适用于学习和开发阶段的代码测试、小规模数据的简单处理任务,以及对性能和可靠性要求不高的实验性项目。比如,学生在完成大数据课程作业时,使用单机模式处理少量的文本数据,实现简单的数据统计功能。在启动命令和部署方式上,单机模式相对本地模式更为简易。单机模式下,通常仅需执行单一的启动脚本,如./bin/start-cluster.sh --config /path/to/conf/flink-conf.yaml,Flink 即可在单节点上快速启动,且资源分配完全依赖于该节点自身的默认设置。以下是flink-conf.yaml的示例内容:
# 作业管理器的主机名或IP地址
jobmanager.rpc.address: localhost
# 作业管理器的RPC端口
jobmanager.rpc.port: 6123
# 任务管理器的堆内存大小
taskmanager.memory.process.size: 1600m
# 每个任务管理器的任务槽数量
taskmanager.numberOfTaskSlots: 2
# 作业默认的并行度
parallelism.default: 1
而本地模式的启动命令则会涉及到更多对本地资源的配置参数,部署时需要更细致地规划本地环境,比如要指定不同的内存分配、线程数量等参数,启动命令如./bin/flink run -m local -c com.example.MainClass --jobmanager.memory.process.size 2048m --taskmanager.memory.process.size 4096m /app/data/app.jar,相较于单机模式,在启动和部署环节需要更多的人工干预和精确配置 。
二、本地模式
(一)特点
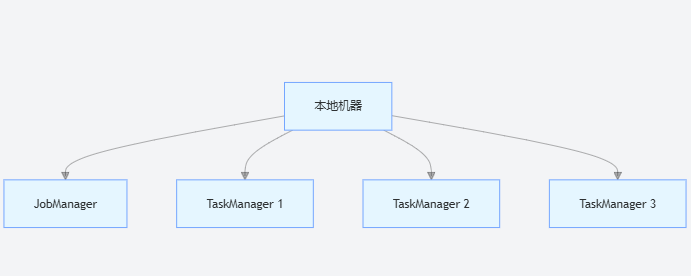
本地模式同样在单台机器上运行 Flink 集群,但它充分利用了本地机器的多线程或多进程能力。与单机模式不同的是,本地模式可以模拟分布式环境,在一台机器上启动多个 TaskManager 实例,每个实例运行在独立的线程或进程中,从而实现一定程度的并行计算。
(二)优缺点
本地模式的优点是便于在本地环境进行代码的调试和性能测试,能够快速验证程序在多任务并行处理下的效果。开发人员可以方便地查看任务执行过程中的日志和状态,及时发现和解决问题。例如,开发一个实时计算用户行为数据的 Flink 程序时,在本地模式下,可以快速模拟多个任务并行处理数据,观察程序的性能表现,定位可能存在的性能瓶颈。
但它也存在局限性,由于运行在单台机器上,资源仍然受限于本机,无法满足大规模数据处理和高并发业务的需求。并且,本地模式无法模拟真实分布式环境中的网络延迟、节点故障等复杂情况,对于需要考虑分布式特性的程序测试不够全面。
(三)适用场景
本地模式适用于开发过程中的代码调试、性能优化,以及对资源和可靠性要求不高的小规模数据处理任务。启动本地模式十分简便,在安装好 Flink 环境后,进入 Flink 的安装目录,执行./bin/start-cluster.sh命令即可启动。若需配置一些基础参数,可在conf/flink-conf.yaml文件中进行设置,常见配置项如下:
jobmanager.rpc.address:指定 JobManager 的 RPC 地址,默认值为localhost。
jobmanager.heap.size:设置 JobManager 的堆内存大小,如1024m。
taskmanager.heap.size:设置 TaskManager 的堆内存大小,例如2048m 。
以小型电商企业在开发初期,使用本地模式对每日的订单数据进行简单的统计分析,以了解销售趋势为例,可在conf/flink-conf.yaml中配置:
bmanager.rpc.address: localhost
jobmanager.heap.size: 1024m
taskmanager.heap.size: 2048m
配置完成后,执行./bin/start-cluster.sh,即可启动本地模式的 Flink 集群。若要发布任务,可使用flink run命令。例如,假设有一个打包好的 JAR 文件job.jar,并且该 JAR 文件的主类是com.example.JobClass,你可以通过以下命令发布任务:
./bin/flink run -c com.example.JobClass job.jar
在上述命令中,-c参数指定了 JAR 文件中的主类。若你的任务需要传入额外参数,可在 JAR 文件路径后继续添加。例如:
./bin/flink run -c com.example.JobClass job.jar param1 param2
通过这些步骤,就能在本地模式的 Flink 集群上成功发布并运行任务。
三、分离式部署
(一)特点
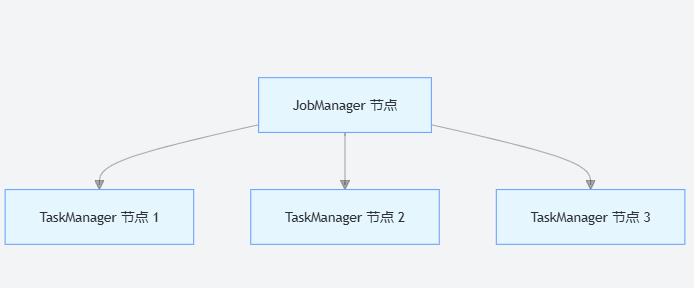
分离式部署是一种典型的分布式部署模式,JobManager 和 TaskManager 分别部署在不同的节点上。这种模式下,集群中的节点可以根据实际需求灵活配置资源,JobManager 负责作业的调度和管理,TaskManager 负责具体的任务执行。通过网络通信实现节点之间的协调和数据传输,能够充分利用多台机器的资源,具备良好的扩展性和高可用性。
(二)优缺点
分离式部署的优点显著,它能够处理大规模数据和高并发任务,通过增加节点可以轻松扩展集群的处理能力。同时,由于节点的分离,即使部分 TaskManager 节点出现故障,JobManager 可以将任务重新分配到其他正常节点上,保证集群的持续运行,提高了系统的可靠性。例如,在大型电商平台的 “双十一” 活动期间,大量的订单数据需要实时处理,分离式部署的 Flink 集群可以通过动态增加 TaskManager 节点,轻松应对高并发的订单数据处理任务。
不过,分离式部署的缺点在于部署和管理较为复杂,需要对网络配置、节点管理、资源分配等进行细致的规划和配置,并且运维成本相对较高,需要专业的运维团队进行维护。
(三)适用场景
分离式部署适用于生产环境中的大规模数据处理任务,如电商平台的实时数据分析、金融行业的交易数据处理、社交媒体的日志分析等对性能、扩展性和可靠性要求较高的场景。以社交媒体平台为例,每天会产生海量的用户动态数据,使用 Flink 集群进行分离式部署,可实时分析用户的点赞、评论、分享等行为数据,为用户推荐感兴趣的内容。
在配置方面,首先需编辑conf/flink-conf.yaml文件,设置jobmanager.rpc.address为 JobManager 的 IP 地址,配置taskmanager.numberOfTaskSlots以确定每个 TaskManager 的任务槽数量。启动命令为:在主节点执行bin/start-cluster.sh来启动整个 Flink 集群。提交任务时,使用bin/flink run命令,后面跟上任务的 Jar 包路径以及相关参数,例如bin/flink run -m yarn-cluster -c com.example.MyJob /data/job.jar,即可将任务提交到已部署好的 Flink 集群上运行。
四、嵌入式模式
(一)特点
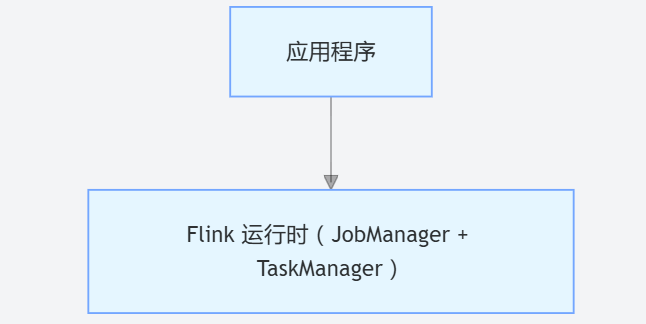
嵌入式模式是将 Flink 运行时嵌入到其他应用程序中,使 Flink 成为应用程序的一部分。在这种模式下,Flink 的 JobManager 和 TaskManager 与应用程序共享进程空间,无需独立的 Flink 集群环境。嵌入式模式可以根据应用程序的需求灵活定制 Flink 的运行方式,实现更紧密的集成。
(二)优缺点
嵌入式模式的优点在于高度集成,能够与应用程序深度融合,实现快速响应和高效的数据处理。它可以根据应用程序的特定需求进行定制化开发,提高系统的整体性能和灵活性。例如,在在线广告投放系统中,将 Flink 嵌入到广告投放应用程序中,实时分析用户的浏览行为数据,根据用户的兴趣和偏好,快速精准地投放广告。
但它也存在一些问题,由于与应用程序紧密耦合,代码的维护和升级相对复杂,并且嵌入式模式的资源管理和调度需要与应用程序的其他部分进行协调,增加了开发和调试的难度。
(三)适用场景
适用场景
嵌入式模式适用于对集成度要求较高的场景,如实时数据处理与业务逻辑紧密结合的应用程序,像在线广告投放系统中根据实时用户行为数据进行广告推荐,以及一些需要快速响应的实时监控和预警系统。例如,在工业生产监控系统中,将 Flink 嵌入其中,实时分析传感器采集的数据,一旦发现数据异常,立即发出预警信号。以下是一个简单的代码示例:
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
public class EmbeddedFlinkExample {
public static void main(String[] args) throws Exception {
// 创建执行环境
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
// 从传感器数据源读取数据,假设数据源以文本形式提供数据
DataStreamSource<String> sensorData = env.socketTextStream("localhost", 9999);
// 处理数据,例如简单地打印数据
sensorData.print();
// 执行任务
env.execute("Embedded Flink Example");
}
}
在嵌入式模式中,Flink 运行时会被嵌入到其他应用程序中,成为其一部分。部署时,需要将 Flink 的相关依赖库整合到主应用的项目中,通过代码创建并配置 StreamExecutionEnvironment 或 BatchExecutionEnvironment。提交任务时,与单机、本地和分离式不同,嵌入式模式下任务直接在主应用程序内启动,无需像其他模式那样通过命令行工具或 REST API 提交。例如,在 Java 应用中,可以直接调用 env.execute() 方法来触发任务执行。如下代码展示了嵌入式模式下从本地 9999 端口读取传感器数据并打印的简单任务提交过程:
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
DataStream<String> stream = env.socketTextStream("localhost", 9999);
stream.print();
env.execute();
评论区